2026-09-21
Alexandr Wang 转发 Muse 定制时尚应用案例
Alexandr Wang 转发用户 @shriyanevatia 用 @Muse 打造的定制时尚应用,称其为"个人造型师"。该用户投入大量时间和 token 提示 Muse,输入身高、体重、三围、照片及 20 家服装店和预算区间,由 Muse 从目录挑选"hero piece"并围绕它搭配造型,还可持续迭代喜好。
Alexandr Wang 转发用户 @shriyanevatia 用 @Muse 打造的定制时尚应用,称其为"个人造型师"。该用户投入大量时间和 token 提示 Muse,输入身高、体重、三围、照片及 20 家服装店和预算区间,由 Muse 从目录挑选"hero piece"并围绕它搭配造型,还可持续迭代喜好。
中国大模型周调用量达67.46万亿Token,连续21周领先美国 · 1 · Sep 21, 2026 5 据OpenRouter 最新 数据,9月14日至20日,全球AI大模型总调用量达129万亿Token,环比增长1.57%
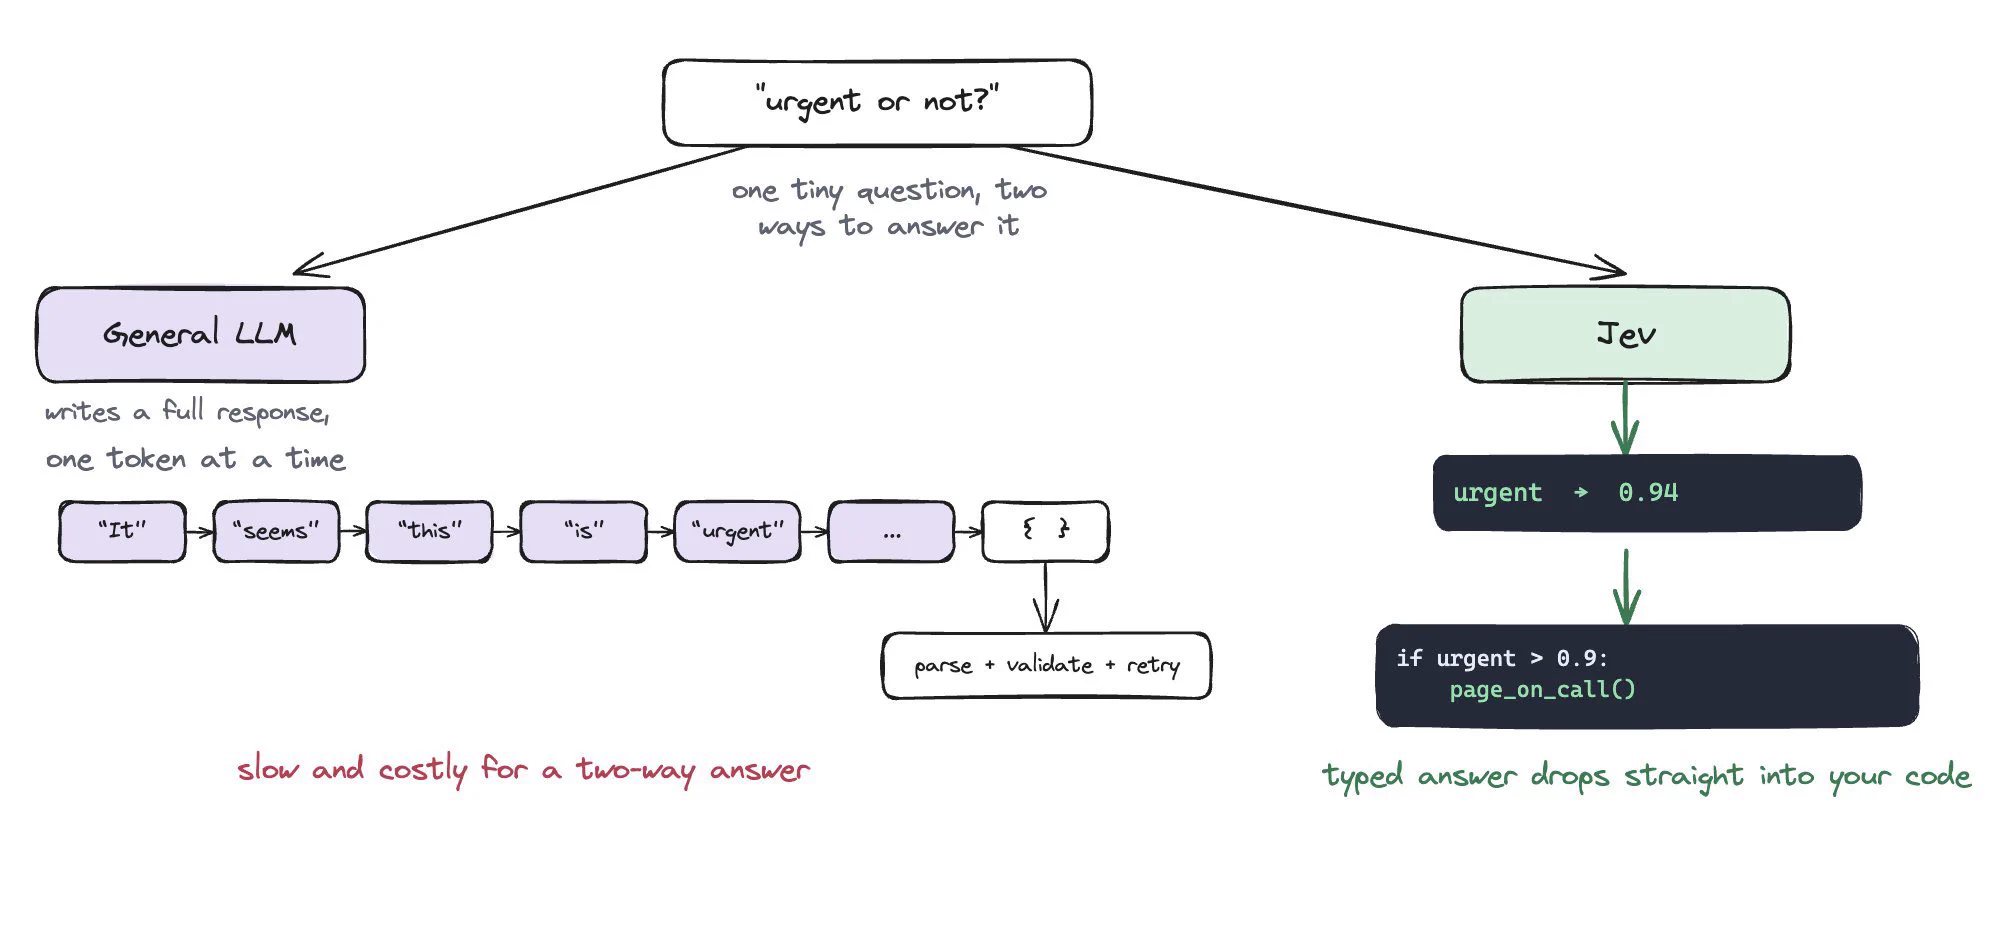
jevchat 把 Jev 的概率打分接口当作语言模型使用:每一步让 Jev 在给定问题和已生成回复的情况下,为字母表或 token 列表中每个候选符号返回概率,再由采样器归一化后抽取下一个符号,抽到 STOP 即结束。
Orange AI 借《Next Token 词元之外》第三期,串起 Jev 走红、Dario 呼吁放慢 AI 进展、DeepSeek 4.1 Flash 优化与数学家反思等话题,并引申到维特根斯坦的语言游戏。
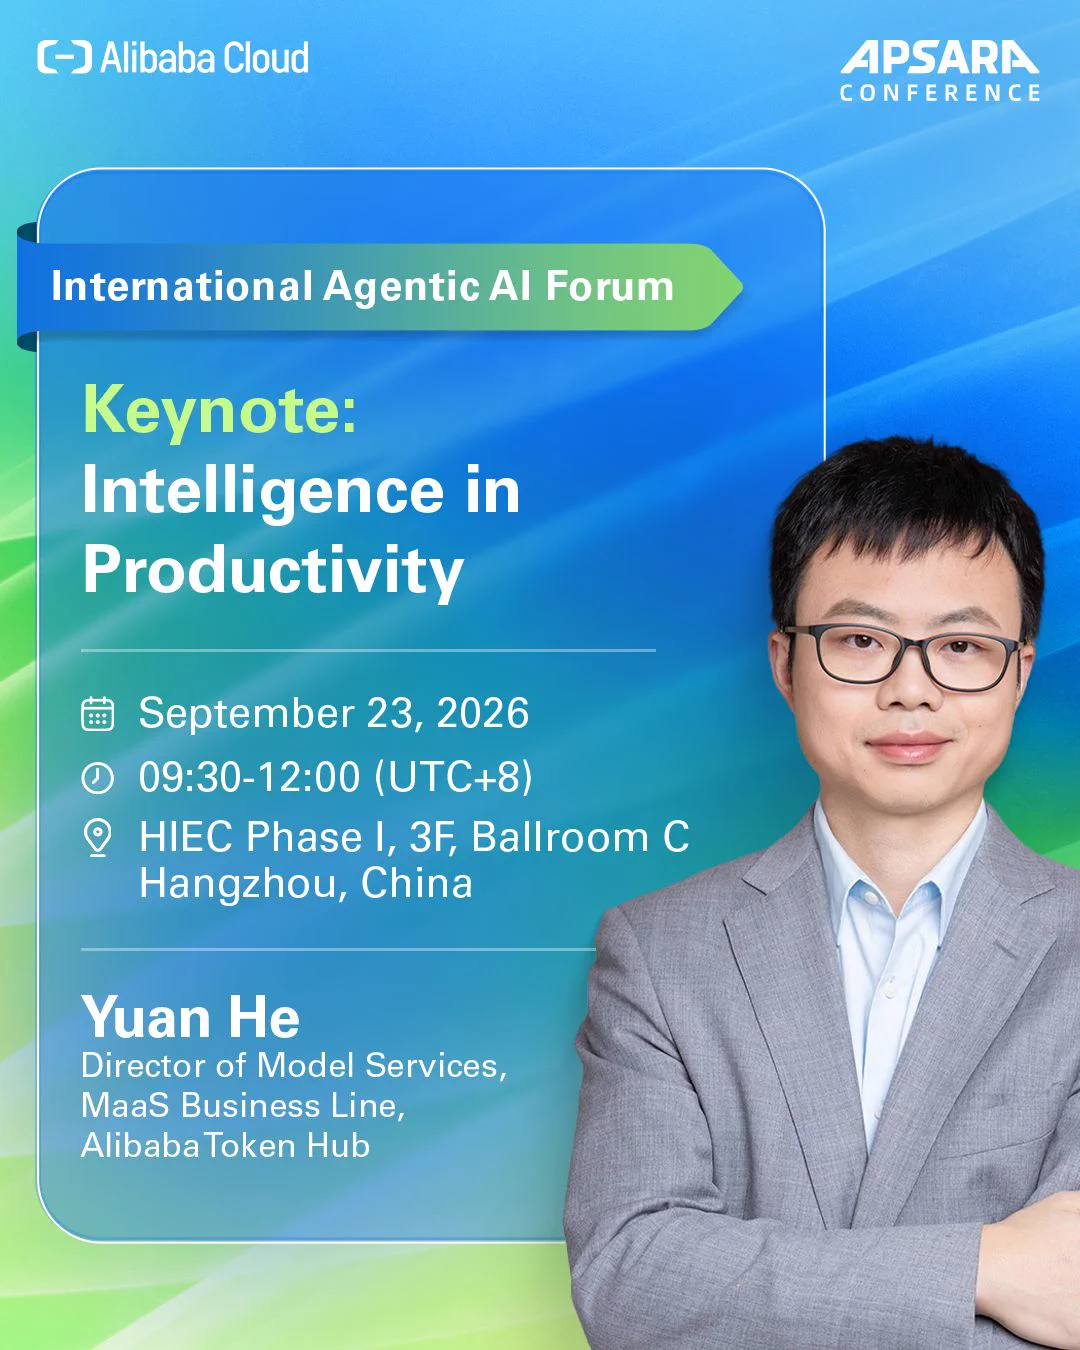
智能生产力的新时代正在形成。在 #ApsaraConference2026 上,阿里巴巴 Token Hub MaaS 业务线模型服务总监 Yuan He 将探讨不断演进的 AI 模型能力如何塑造生产力的未来
作者推荐并解读 @akshay_pachaar 的技术图解长文,指出传统大模型自回归逐 Token 生成的成本与延迟问题,而 Jev 把判断逻辑变成确定的输入状态与候选选项。
阶跃星辰发布 Step 5 Preview,采用 600B 稀疏 MoE、27B 激活参数,支持 100 万 Token 上下文,权重将于 10 月 15 日释放。Bun 团队四个月内用 AI 辅助将 53.5 万行 Zig 重写为 Rust,消除大量内存泄漏
阶跃星辰发布 Step 5 Preview,采用 6000 亿总参数、270 亿激活参数的稀疏 MoE 架构,支持 100 万 Token 上下文与文本、视觉输入,计划 10 月 15 日释放权重。
DAIR.AI 发布 9 月 14-20 日 Top AI Papers:Meta 研究字节级语言模型随算力增长的缩放规律,用 Marginalize-It 与 End-Of-Token 两种方法从 token 教师蒸馏 1B 字节学生,拟合缩放律显示 End-Of-Token 学生在渐近线上领先蒸馏 token 模型最多 4%
智谱 MaaS 平台近期将上线数据内容不留存功能,用户可通过 MaaS 控制台申请开通,生效后平台不会对输入和输出进行静态存储,数据仅用于完成当次模型调用。Batch API、File API 等需持久化保存任务或文件的功能不在覆盖范围内,法律法规要求留存或核查违规滥用时,平台可能留存相关数据 30 天及以上。
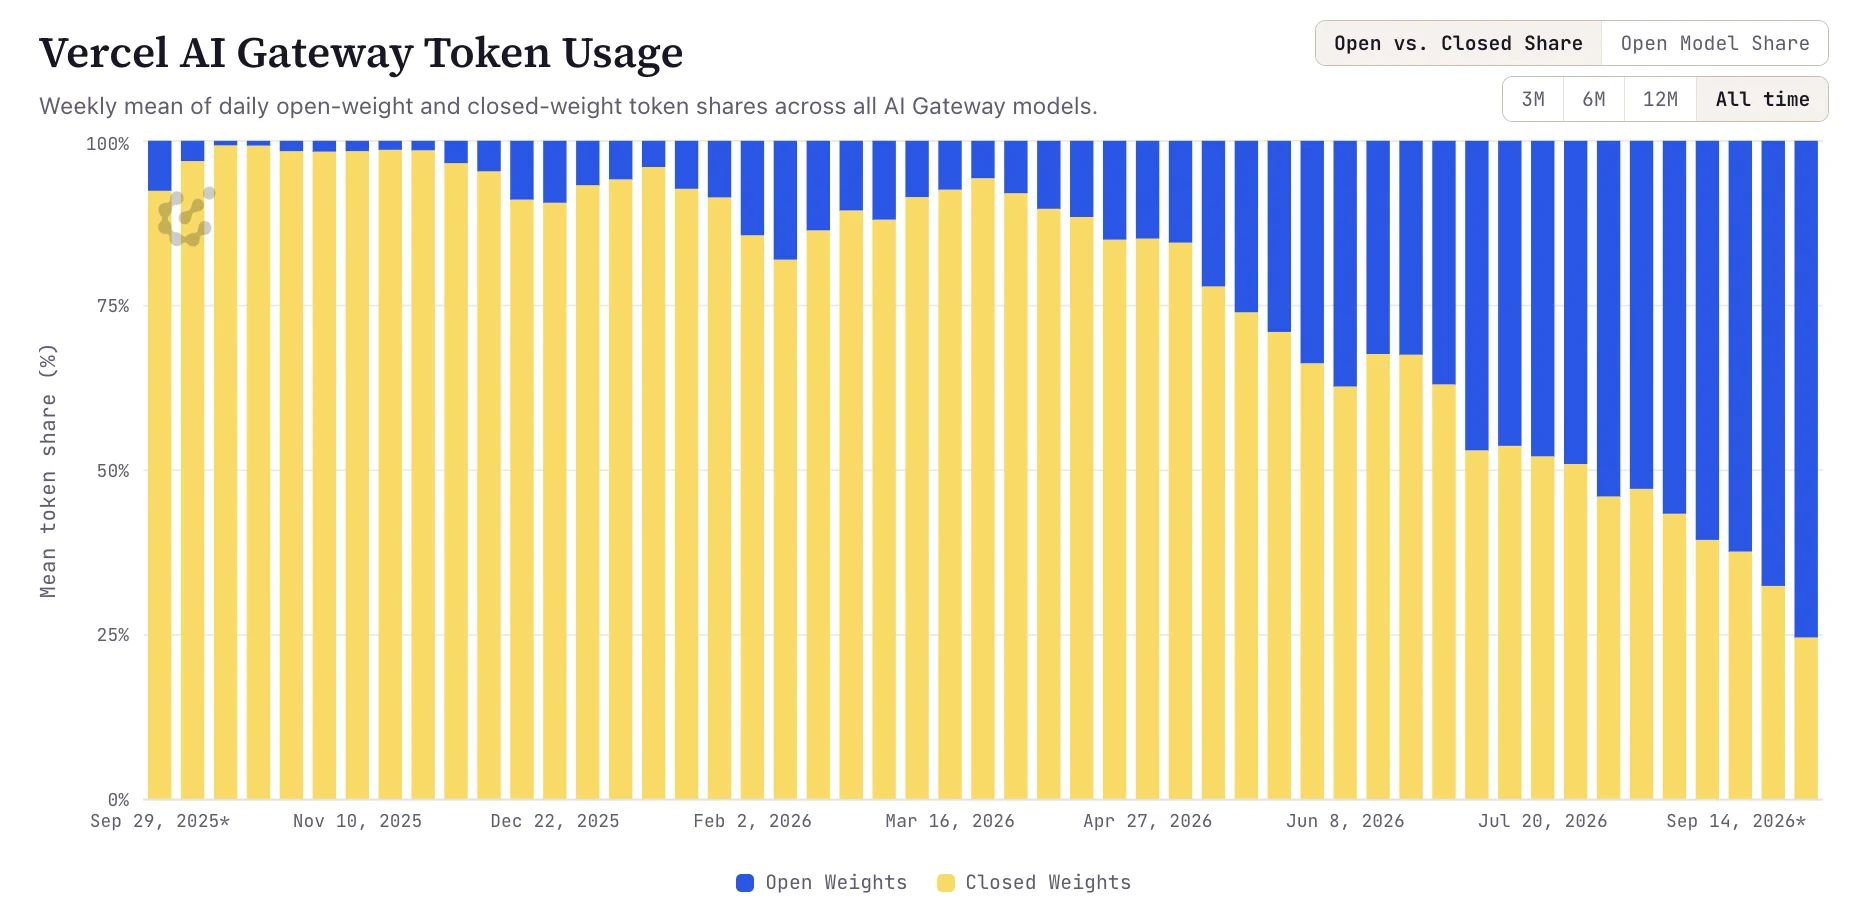
Vercel AI Gateway 上开源模型 token 占比今日或创纪录,达 78.4%,闭源模型为 21.6%。Moonshot AI 与 DeepSeek 分列支出第 3、4 位,加上 Z.ai 后合计支出超过 OpenAI(第 2)
小北分析 Vercel AI Gateway 上线近三个月的模型榜单,总结为开放模型吃掉 Token、闭源模型拿走预算。开放权重模型占 80.1% 的 Token,其中 DeepSeek V4.1 Flash 一款占 64.8%;花费榜前列是 Claude Opus、GPT-6 Astra、Kimi K3
NVIDIA 提出一种前后端架构,让全双工语音模型通过发出委托 token,将流式转录转发给文本后端 LLM 执行工具调用,再经轻量 prefill-and-repeat 机制回传结果并由 TTS 播报。
Astra for Law 首批通过 Trusted Access 向部分律所开放,可在 ChatGPT 和 Codex 中使用,API 即将推出。
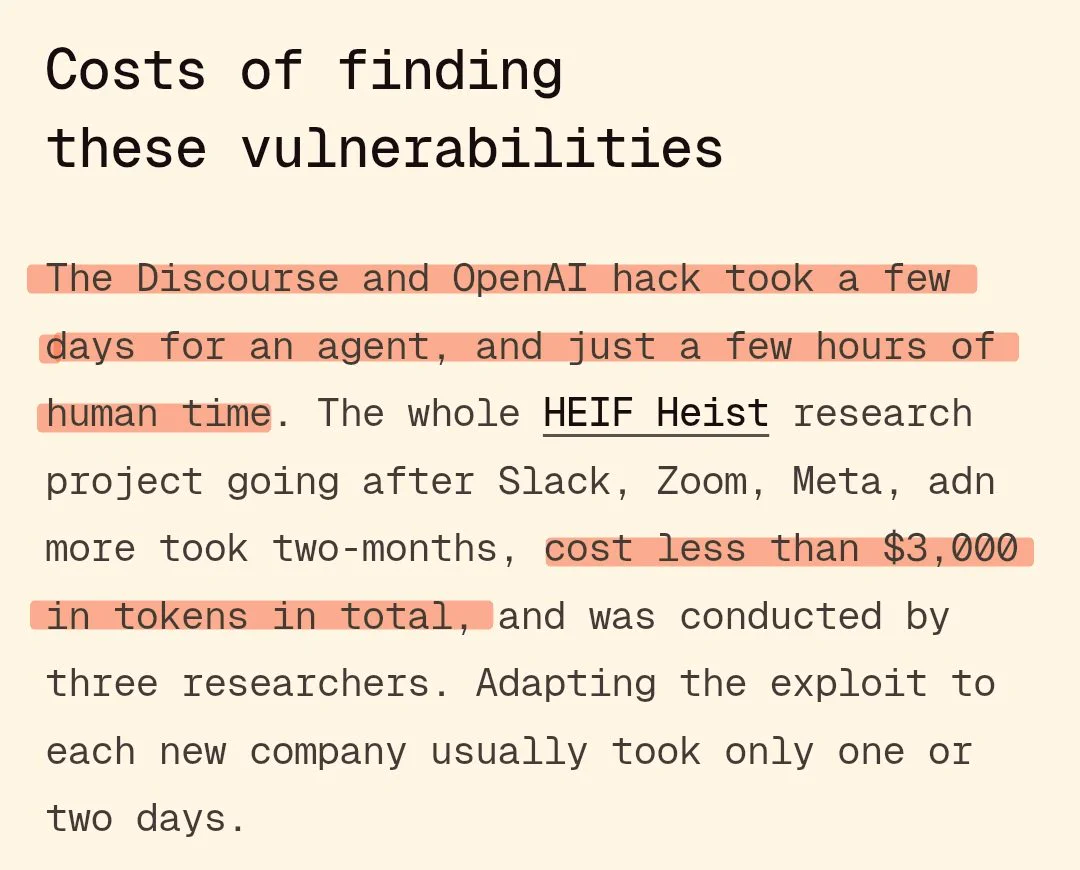
3 名安全研究人员使用 Claude Opus 5 仅用几小时、Token 成本不到 3000 美元,将图片上传漏洞扩展为 OpenAI 员工账户接管,并通过 Codex 提交内部 PR。
StepFun 发布旗舰模型 Step 5 Preview,主打 agentic 工作,覆盖软件工程与专业知识工作,在金融领域有特别优势
Mozilla 新报告称开源权重模型现在只比闭源前沿落后约四个月。Kimi K3 在 Terminal-Bench 上接近 Sol,GLM-5.2 以不到五分之一的价格逼近 Claude Opus 表现;OpenRouter 上按 token 量排名前十的最大模型中有八个是开源权重。闭源模型在最难任务上仍领先,但差距已明显缩小。
原文引用 Jev 完成大规模广告分析的演示,Token 成本仅 9 美分,即将在 StealAds + MCP 中可用。
Jev 仅用 40 秒分析 37 个品牌的 724 条广告,提取钩子、形式、Offer、CTA 等细节,Token 成本 0.09 美元,即将接入 StealAds + MCP。
作者宣布其项目已上线,所有人可玩,若使用 TypeSafe AI(JEV 官方 API)需自带 API。
阶跃星辰发布旗舰基座模型 Step 5 Preview,采用稀疏 MoE 架构,总参数量 600B、激活 27B,支持 100 万 Token 上下文和文本与视觉输入,在 Artificial Analysis Intelligence Index 得 44 分,居全球开源模型前三,单任务成本为 Claude Opus 5 的 1/8。
阿里发布 Qwen3.8-Omni-Flash 音视频多模态模型,具备 1M 上下文及工具调用能力,大幅减少 Token 消耗,仅提供 API。
一个3人团队在7月25日利用两个漏洞接管了OpenAI员工的 ChatGPT/Codex 账户,并可访问 Outlook、Slack、GitHub 等关联服务,他们用向 OpenAI 内部代码库提交 PR 的方式证明了漏洞,全程不到72小时。
TypeSafe AI 推出专注高频决策的大模型 Jev,不做对话和文字生成,只输出判断,速度比传统大模型快20~200倍,成本0.042美元/百万Token且输出Token免费
DeepSeek 发布 DeepSeek-V4.1-Flash,一个 552B 参数的多模态 MoE 模型,支持最长 100 万 token 上下文,模型权重已在 Hugging Face 开放。
Anthropic 让 Claude 在不到四周内优化了超过 30 个开源生物分子模型,平均提速约 4 倍、精度损失极小,输出完全一致时也有近 2 倍加速。优化代码全部开源,还推出低内存 Big 模式,可在单张 NVIDIA GPU 节点上对超过 10,000 token 的生物分子系统做准确预测。
OpenRouter 梳理其目录中的 DeepSeek V4 系列图像输入支持情况:V4.1 Flash 原生读图(2026年9月10日上线,$0.15/$0.60 每百万 token)。
DeepSeek 发布 V4.1-Flash,API 价格同步下调 — 点击查看完整日报
DeepSeek 发布 V4.1-Flash,采用新 Causal Encoder-Decoder 架构并支持原生视觉理解,为其新架构家族中最小模型。该模型为 552B 参数 MoE,输入处理激活 8B、输出生成激活 16B;KV cache 需求较上一代降至 HBM 的 1/4、SSD 存储的 1/8,API 价格更低。
DeepSeek AI 发布多模态 MoE 模型 DeepSeek-V4.1-Flash,552B 主干加 196B Engram 参数,上下文窗口 1M,prefill 激活 8B 参数、decode 激活 16B,全局 KV 缓存降至每 token 890 字节