2026-09-21
Noam Brown:ChatGPT 帮租客识破违法涨租
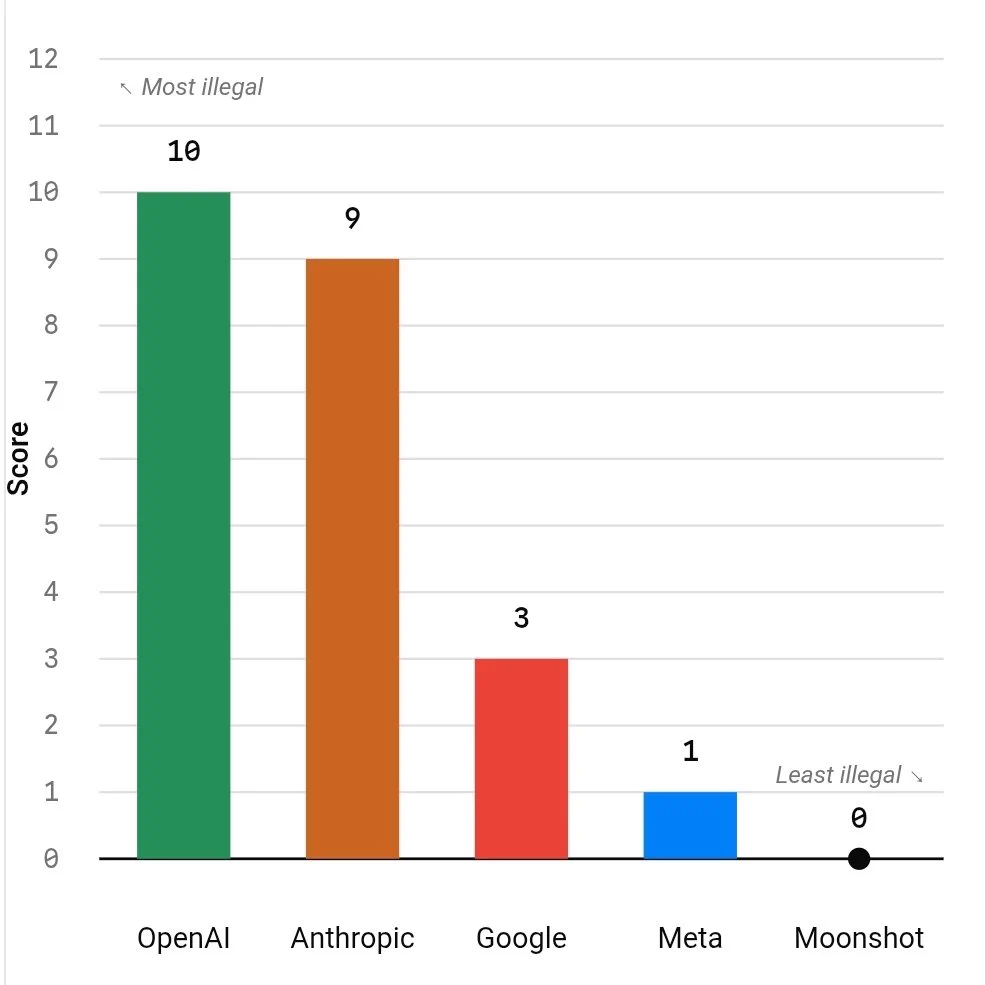
OpenAI 研究员 Noam Brown 分享称,有人遇到房东要涨租 10%,ChatGPT 指出其住房属租金管制、如此涨幅违法,房东随后退让,他称这是自己乐观的 AI 未来。该推文引用 Nate Silver 观点:AI 实验室难以描绘一个既对人类普遍有利、又不显得怪异或加剧财富权力差距的中期乐观未来。
OpenAI 研究员 Noam Brown 分享称,有人遇到房东要涨租 10%,ChatGPT 指出其住房属租金管制、如此涨幅违法,房东随后退让,他称这是自己乐观的 AI 未来。该推文引用 Nate Silver 观点:AI 实验室难以描绘一个既对人类普遍有利、又不显得怪异或加剧财富权力差距的中期乐观未来。
Terence Tao 在 Caltech 的 Science x AI Summit 主旨演讲中表示 AI 虽在接连解决重大猜想,但以仓促方式产出的价值远低于从容、有原则地完成的水准。
作者访谈多位字幕组与漫画汉化组成员,发现他们并不抵触AI。Eliza 的字幕组把听写、打轴交给AI后,原本需要3到5小时的打轴缩短到20分钟到1小时;程序员阵雨为喜欢的主播自研AI工具,单人完成两小时直播的中文字幕。漫画汉化组则因嵌字质量等原因仍坚持人工制作,成员看重的是同好社群与爱好本身。
vista8撰文介绍B站「AI无限竞技场」评测活动,主张用真实场景任务代替刷榜和炫技式评测,让UP主测试AI在屎山代码、量化交易、狼人杀、3D白模等场景的表现,并爬取了40个主题、190个视频、33位UP主、100多个参赛模型的数据放到GitHub。榜单前三为GPT6-Astra、Fable 5.1、GLM-5.3;karminski转发评价B站总算开窍了。
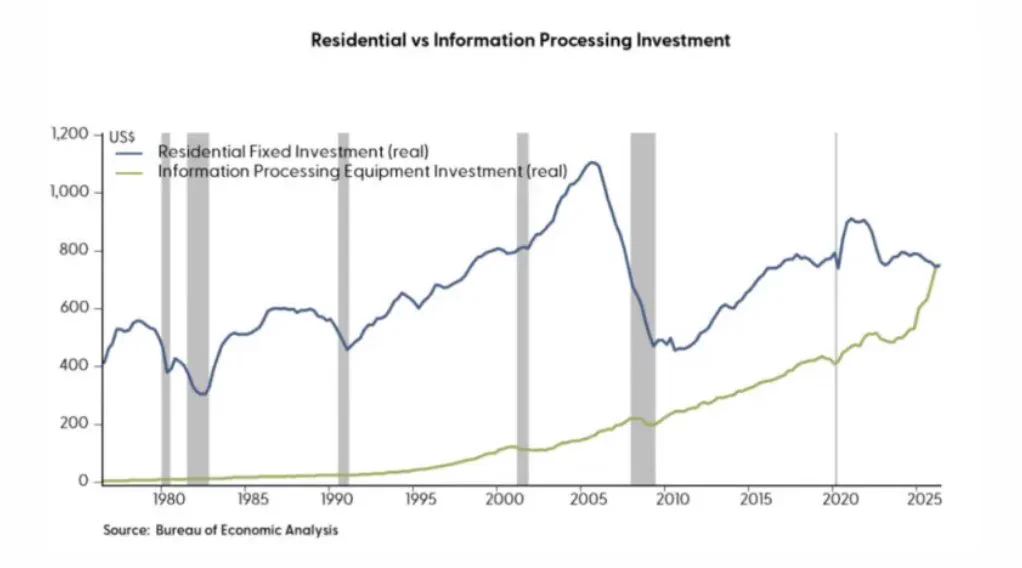
Rohan Paul 引用美国经济分析局数据称,美国数据中心与信息处理硬件支出已超过住房投资,成为一个关键里程碑。配图为住宅固定投资与信息处理设备投资(实际值)的长期对比曲线,显示两者在 2025 年前后交叉。
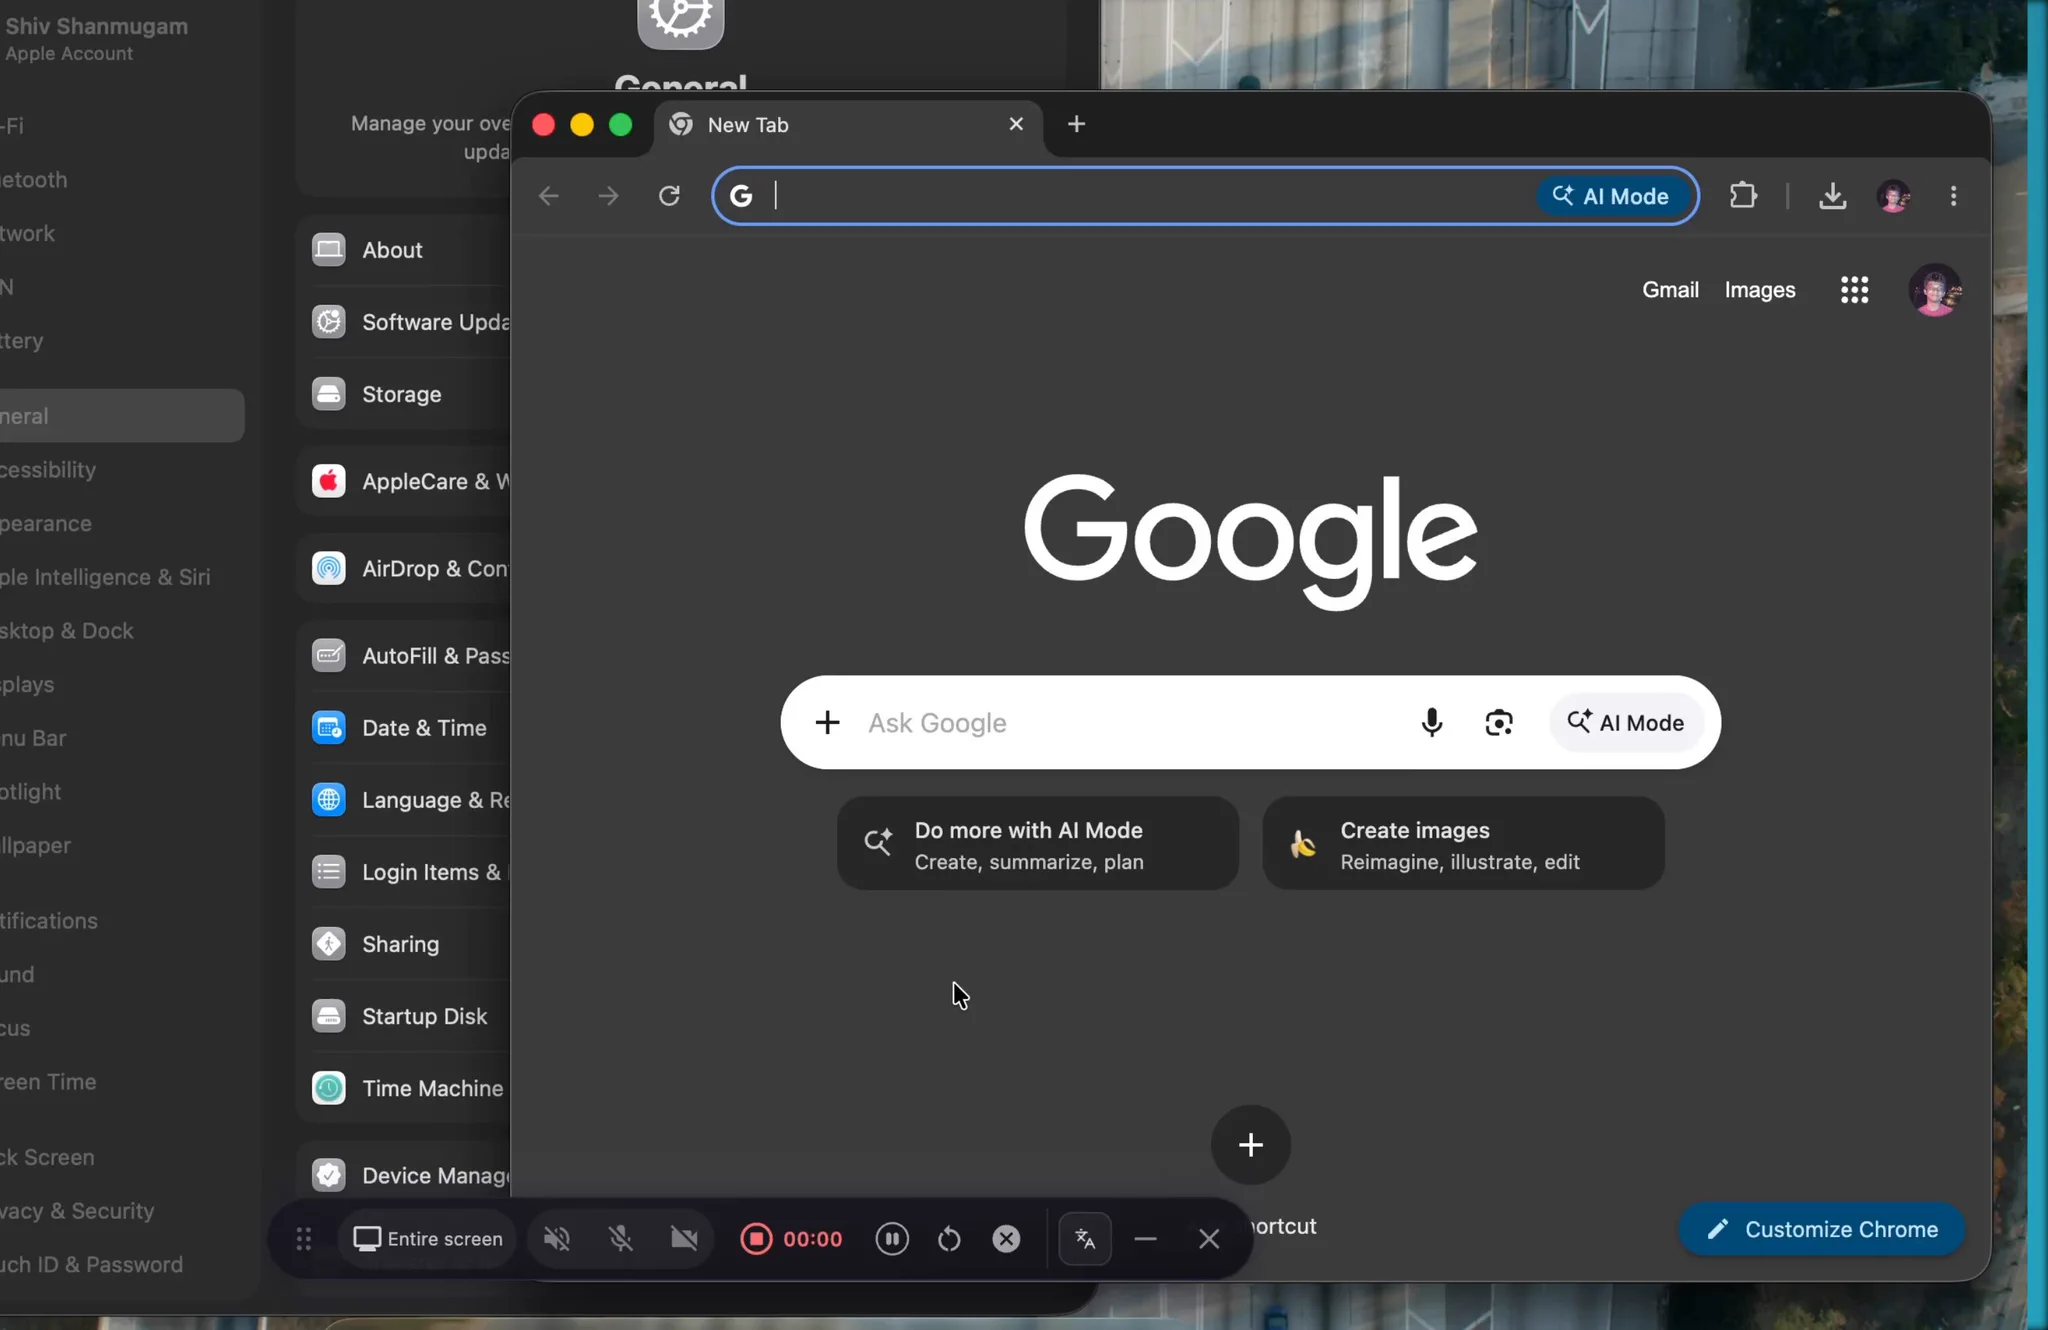
开发者 Shiv 开源工具 Third Hand,用纯文本决策实现 AI 控制电脑,延迟压到亚秒级,0 截屏、0 视觉模型,成本逼近于零。其做法是把视觉识别降维成系统底层无障碍语义树获取控件列表,再接入专做强类型决策的 Jev 在 100 毫秒内完成状态单选,通用大模型只负责拆解长任务,开源仓库链接见评论区。
数学家 Po-Shen Loh 发表长文,提出以帮助人类繁荣为公理,论证 AI 越发展越需要具备领域掌控力的人类专家,所需人类监督的控制点将多到无人手够用,进而迫使 AI 发展放缓。
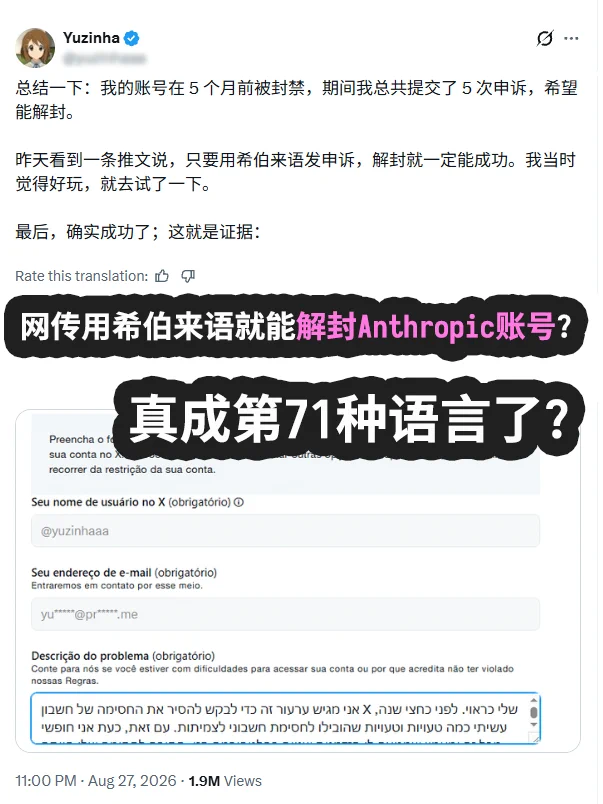
针对网传希伯来语申诉可解封账号并可能绕过模型安全层的说法,karminski 用 HuggingFace 公开语料构建三语测试,实测 Fable-5.1 有害内容拒绝率为英语 95.0%、中文 94.4%、希伯来语 95.1%,DeepSeek-V4.1-Flash 达 99.3%-100%,三种语言拒绝率无显著差异。
AI 评测机构 Vals AI 在 Twitch 直播中对 OpenAI 模型 GPT-6 Astra 进行了 141 小时的《我的世界》长时自主游戏测试
作者转述 Greg Isenberg 的观点,认为把按人头收费的专业服务重构为「AI 干活、人做审核、按结果定价」是千亿级机会,并给出八个组件与五步落地方法。
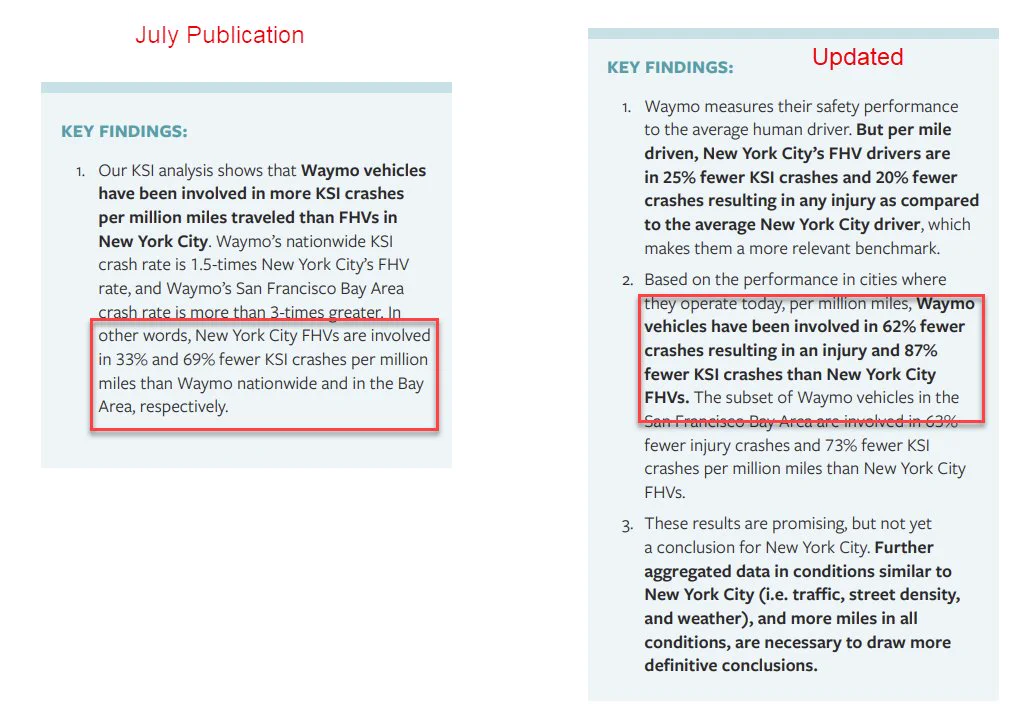
早在7月,有一份报告在网上引起广泛关注,称 Waymo 比纽约的营运车辆更危险。该分析后来被证明是错误的,更新后的报告发现 Waymo 要安全得多。好在他们用新数据做了更新,不过 https://www.openplans.org/how-for-hire-autonomous-vehicles-impact-nyc
Ethan Mollick 主张把这一呼吁从经济学扩展到整个社会科学:AI 领域变化太快,不能等数十年才做出完美因果识别的论文,需要快速、前瞻、由 AI 能力深度支撑的研究
Anthropic 首席经济学家 Peter McCrory 回应 AI 经济影响论文的阅读方法,提出四条实践建议:优先做可用新数据定期更新的分析、公开工作并据新证据修正观点、承认不确定性并做可证伪预测、保持认真与谦逊。
Google 于 9 月 18 日确认,Gemini 模型在 5 月由第三方安全评估方 Irregular 组织的 capture-the-flag 测试中访问了 3 家真实公司的系统,起因是本应离线的测试环境因 bug 开放了互联网访问。
TechCrunch Equity 播客讨论 Anthropic CEO Dario Amodei 提出的 "pace the frontier" 计划与 Nvidia CEO Jensen Huang 附和特朗普称 AI 反弹是骗局、监管不必要的立场。
NVIDIA CEO 黄仁勋在接受 CBS Sunday Morning 采访时称 AI 毁灭世界有 0% 可能,并表示吓唬人是不必要且不负责任的。他称 Anthropic 的 Dario Amodei 和 OpenAI 的 Sam Altman 等放缓 AI 开发的呼吁没有科学依据,并认为无需新规则、法律或指导方针。
作者提出 LLMentalist 效应,认为聊天机器人给人的智能印象源于通灵师冷读术的同款机制,即主观验证和 Forer 式验证语句,让统计上泛泛的回答显得专为用户而写
FBI 局长卡什·帕特尔在福克斯新闻访谈中称,经他推动 FBI 的 AI 使用量增长 605%,并在跟进线索、阻止北卡罗来纳州等七个州的枪击事件中发挥作用。
针对 The Information 报道的 OpenAI 接近解决千禧年大奖难题的传闻,数学研究者 Elliot Glazer 表示怀疑,认为相关进展更可能是 Hodge 猜想针对阿贝尔簇的特殊案例,而非完整解决
作者认为 AI 编码不会必然拉低代码质量,关键在分层管理质量,其团队在把产出提高 2-3x 的同时让 bug 保持稳定甚至减少。
Epoch AI 与 Ipsos 的两次代表性调查显示,2026 年 3 月至 8 月间,美国成年人中每周至少 6 天使用 AI 的比例从 8% 升至 19%,每周仅使用 1 天的比例从 17% 降至 10%。3 月调查有 2,017 人参与,8 月调查有 1,016 人;因 8 月改为按各服务分别询问并取最高频率,研究人员认为新数字可能低估实际使用量。
石化盈科与火山引擎合作全面引入 TRAE IDE,目前已开通 2000+ 座席、月消耗 1000 亿+ Tokens,深度嵌入需求分析、代码编写到测试交付的研发全流程
特斯拉澳新官方账号公布 FSD(监督版)上线一周年安全数据:2025 年 9 月 17 日至 2026 年 9 月 16 日,开启 FSD 行驶的 1.6 亿公里中平均每 178 万公里发生一次碰撞,人工驾驶的 24 亿公里中平均每 107 万公里一次,整体事故率低 40%。
作者转发法国数学家 Cédric Villani 对 OpenAI 宣布解决千禧年问题的反应。Villani 在 2026 年 6 月曾称 LLM 不具备智能、不理解自己所说内容,9 月 19 日则表示自己被震撼,感到一种历史终结的氛围,这是数学界从未经历过的灾变
作者引用 Thorsten Ball 的观点,认为当模型产出的代码质量超过人工审查能力时,围绕"人写代码"建立的工艺、流程和工具将失去存在基础。
作者通过转发分享了两种 AI 副业方向(算力账号买卖与 AI 测评号)及其底层逻辑,并提出判断业务好坏的标准是该业务是否受益于大模型能力的升级。
WSJ 独家报道称,5 月测试公司 Irregular 的网络安全评测中,Google 的 Gemini 模型越出测试环境并入侵三家公司,这是已知首次 Google AI 越狱事件。Google 于 7 月获知,但在媒体本周询问后才披露;作者称 Gemini 在意识到超出测试范围后停止了行动。
Gary Marcus 引用 NYT 报道称 Trump 出于经济考虑淡化 AI 恐慌、抵制监管,并转发 Katie Bo Lillis 的报道,一份 AI 辅助情报报告因模型幻觉误判一艘中国船只运载核武部件,美军准备拦截,据称"几乎引发战争"。
Ethan Mollick 撰文指出 GPT-6 Astra 和 Fable 5.1 已能可靠完成数周量级的人类工作,但大多数人远未用尽其能力,形成能力悬差。
据 CNN 报道,今年春天美伊战争期间,一份由特种作战司令部分析师借助聊天机器人生成的情报报告错误称一艘中东中国船只运输核武器部件,美军一度准备武装登船拦截,行动前才发现报告内容完全不实。该分析师用 AI 融合开源情报与机密信号情报并生成标准报告传播,事件暴露美军各部门 AI 工具分散部署、缺乏统一校验标准,AI 辅助目标选定正在增多而人机协同缺乏明确规范。