2026-11-03
DeepSeek Super-agent 设计方法探讨:激活引导与推理回路优化
作者从激活引导角度批判性分析 Super-agent 设计方法,通过抑制模型推理循环提升 MMLU-Pro 等基准测试表现,同时指出潜在副作用疑虑。
第 10 页
作者从激活引导角度批判性分析 Super-agent 设计方法,通过抑制模型推理循环提升 MMLU-Pro 等基准测试表现,同时指出潜在副作用疑虑。
根据我们对 26K+ 会话的分析,Agent Arena 中排名前十的智能体每生成一个 token,大约要处理 93 个输入 token。 这就是各家实验室竞相降低缓存输入成本的原因。
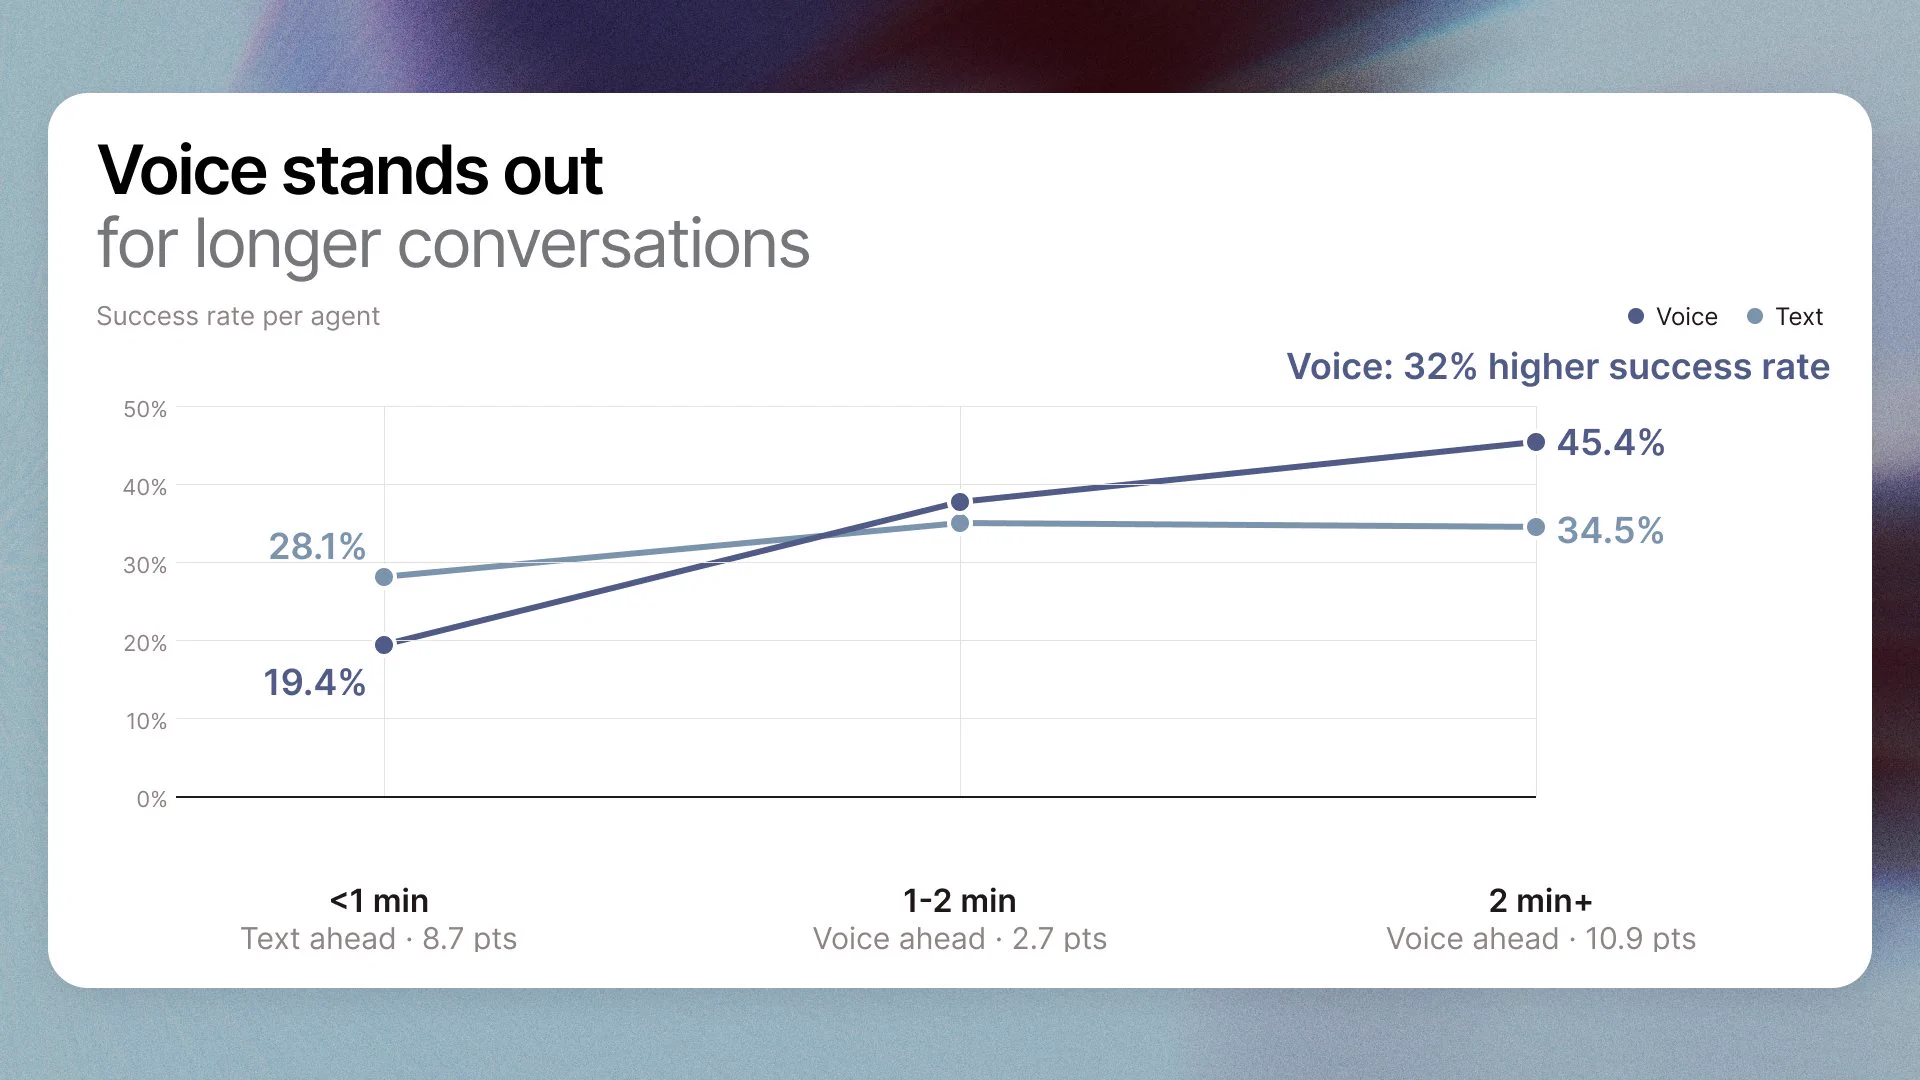
对话越长,语音智能体的成功率越高。 我们分析了 469 个在生产环境中同时运行语音和聊天的智能体,发现了一个有趣的规律。当对话变得复杂时,语音是解决问题最快的路径。 https://elevenlabs.io/blog/voice-wins-complex-stressful-conversations
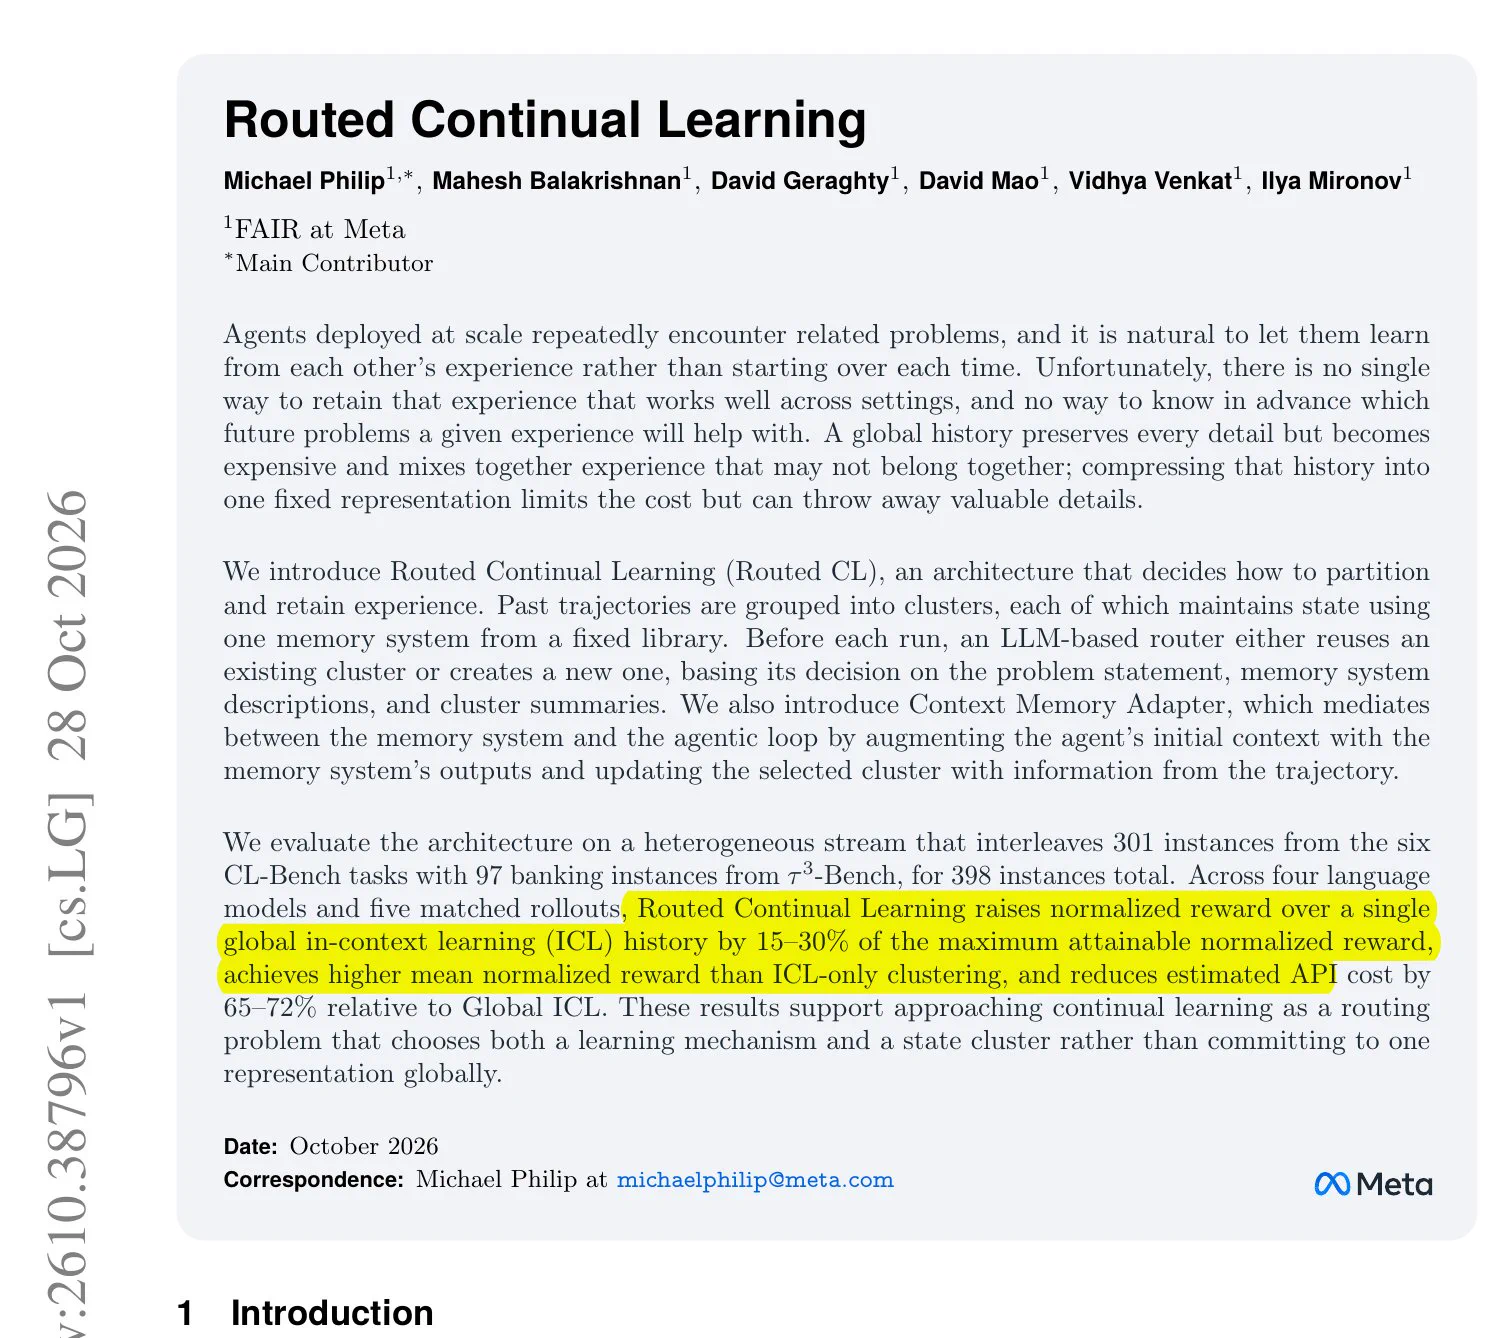
Meta 新论文发现,AI 智能体从过往尝试中学习时,把新问题匹配到相似问题的笔记,比共用一份全量历史记录效果更好。其提出的 Routed CL 用一个 LLM 路由器在每次运行前复用或新建记忆簇,每簇采用 5 种记忆类型之一(如原始历史运行或蒸馏经验)。
DeepSeek 正在推广其免费 AI agent 应用 Harness 中的 Creator Mode,用户用自然语言描述想要的工具,agent 会编写、安装并测试它作为应用内新插件。
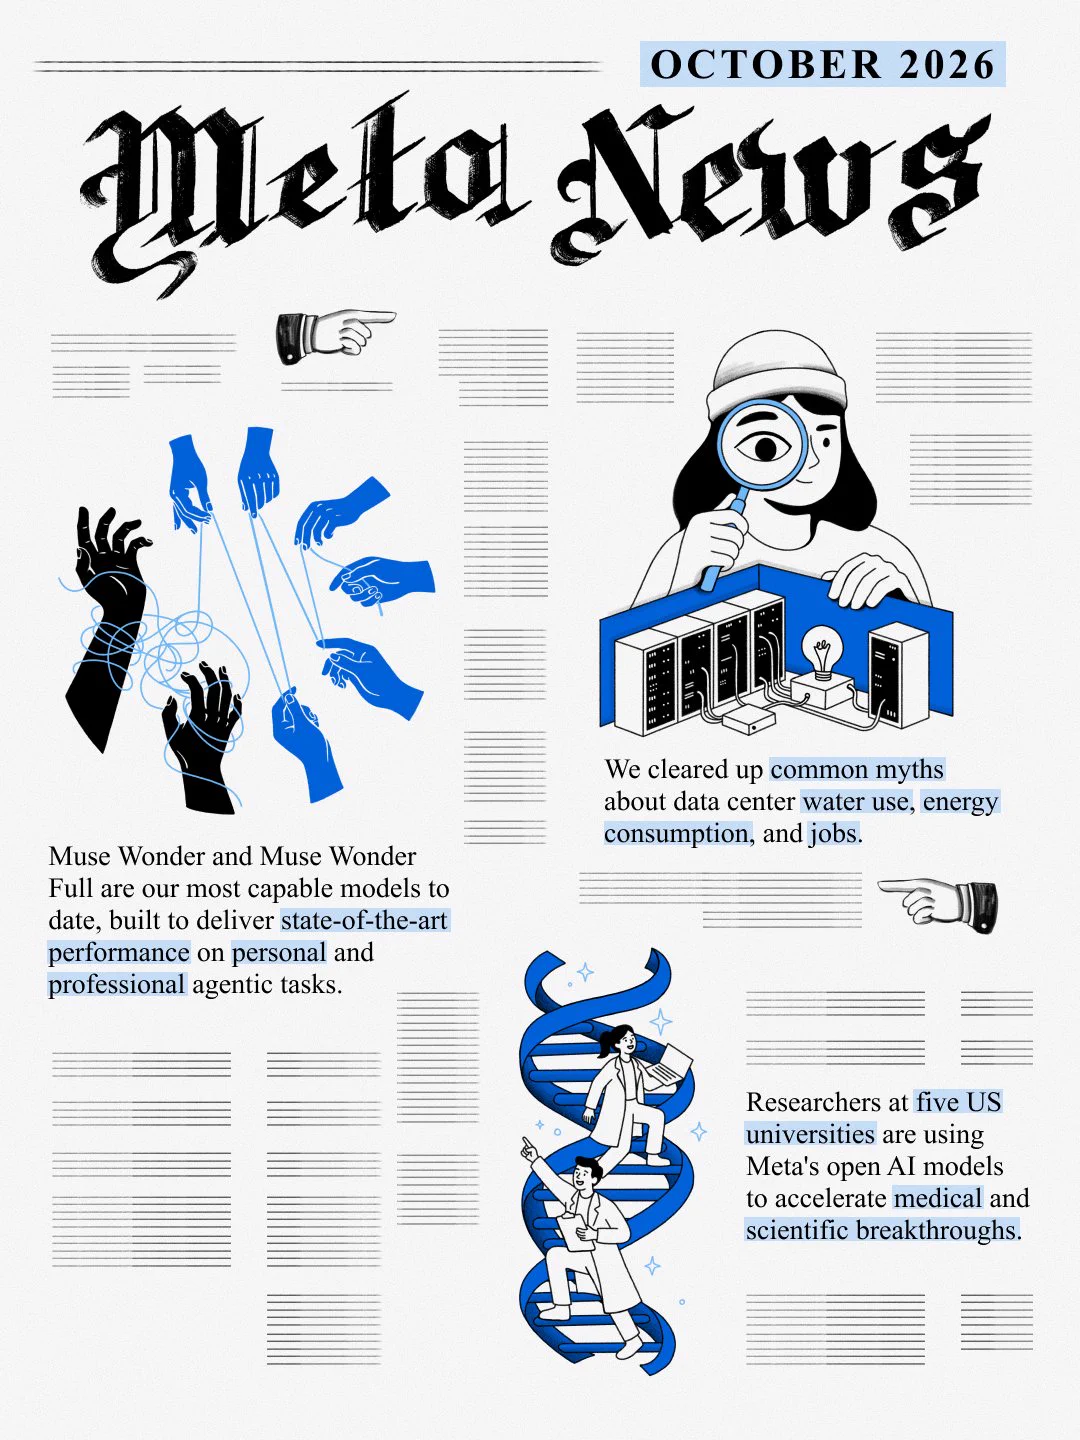
十月亮点回顾: 我们发布了 Muse Wonder 和 Muse Wonder Full 两款面向 AI 智能体的前沿模型;澄清了关于数据中心的一些最大误解;并与美国高校合作,利用 AI 加速医学和科学突破。
O'Reilly 的 The Monday Morning Agent 节目让 AI 分析智能体分析橄榄球 tush push 战术,因 2021 年以来约 26.5 万条战术描述中没有该词,团队先将其定义为中锋下开球的四分卫 1 码内冲球并存入共享数据字典。
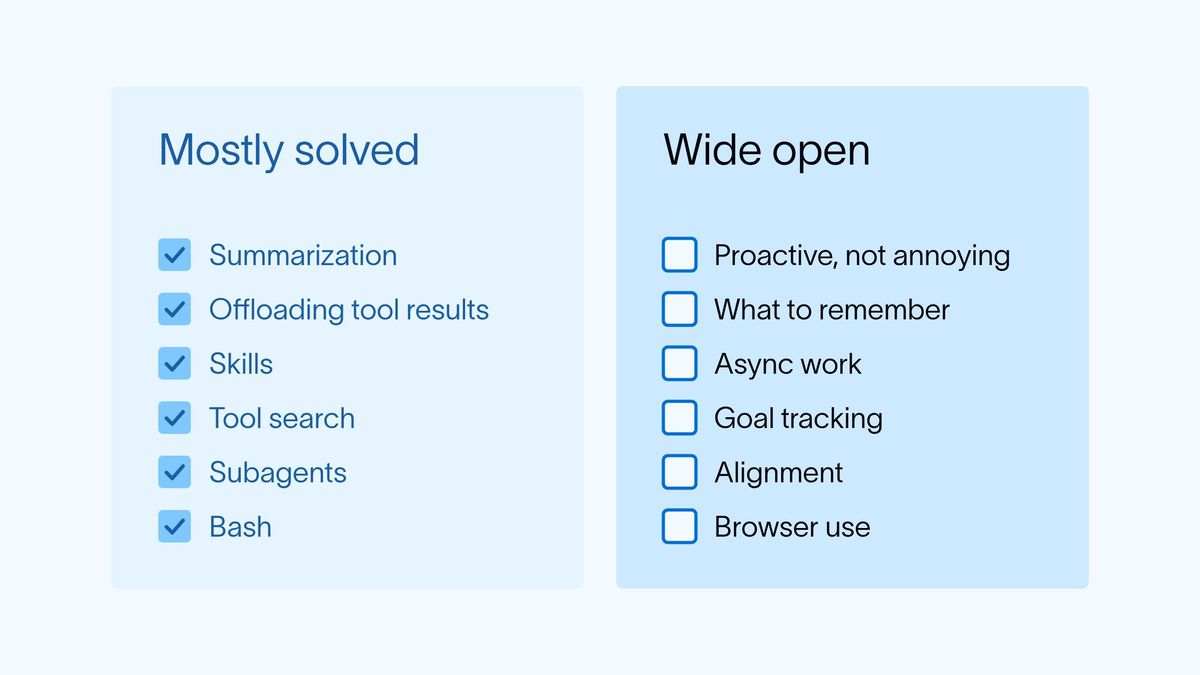
LangChain 指出,随着主动式、常驻、目标导向的智能体兴起,上下文工程出现一批新难题。文章列举了主动推送与打扰的平衡、记忆取舍、异步子任务通知、目标跟踪、目标对齐(如"清除所有 bug"导致删库)以及浏览器工具上下文管理等问题,并称业界尚无通用解法。
Arena 为 Agent Arena 新增性能对比视图,可查看各智能体在每单位输出 token 和每分钟等待下的表现。其真实使用数据显示:同等智能下成本可相差 10 倍、输出 token 可多 6 倍、耗时可达 2 倍,且输出 token 数几乎不能预测账单。
智能体很快会只剩 1 个工具吗?我们从少量工具,走到动态工具搜索,现在又把一切折叠进 code mode。 我写下了 Code Mode 的工作原理、为什么带类型的 JS/Python 沙箱能胜过裸 bash,以及为什么 MCP 会在 2027 年强势回归。附一个 Gemini 4 Argon 的最小示例。
推出 LongCat-2.5,我们最新的原生多模态智能体模型,总参数 1.6T,激活参数约 48B。 专为长程智能体任务打造,为从复杂编程项目到创意设计、3D 任务等视觉编程的各类工作带来更强的视觉理解与智能体编程能力。 了解更多 LongCat-2.5:https://longcat.ai/blog/longcat-2.5/
唐杰团队开源 HarnessPro,通过让 Agent 迭代自身的 harness 设计,同时优化任务表现与执行成本,在 Terminal-Bench 2、SWE-Bench Pro 和 ProgramBench 三大基准上实现通过率提升和调用成本降低,提供 Lite、Medium、Heavy 三个配置档位。
Cortex 是一种将经验沉淀为长期参数记忆的方法,解决了智能体在持续自我改进中经验难以累积的问题。
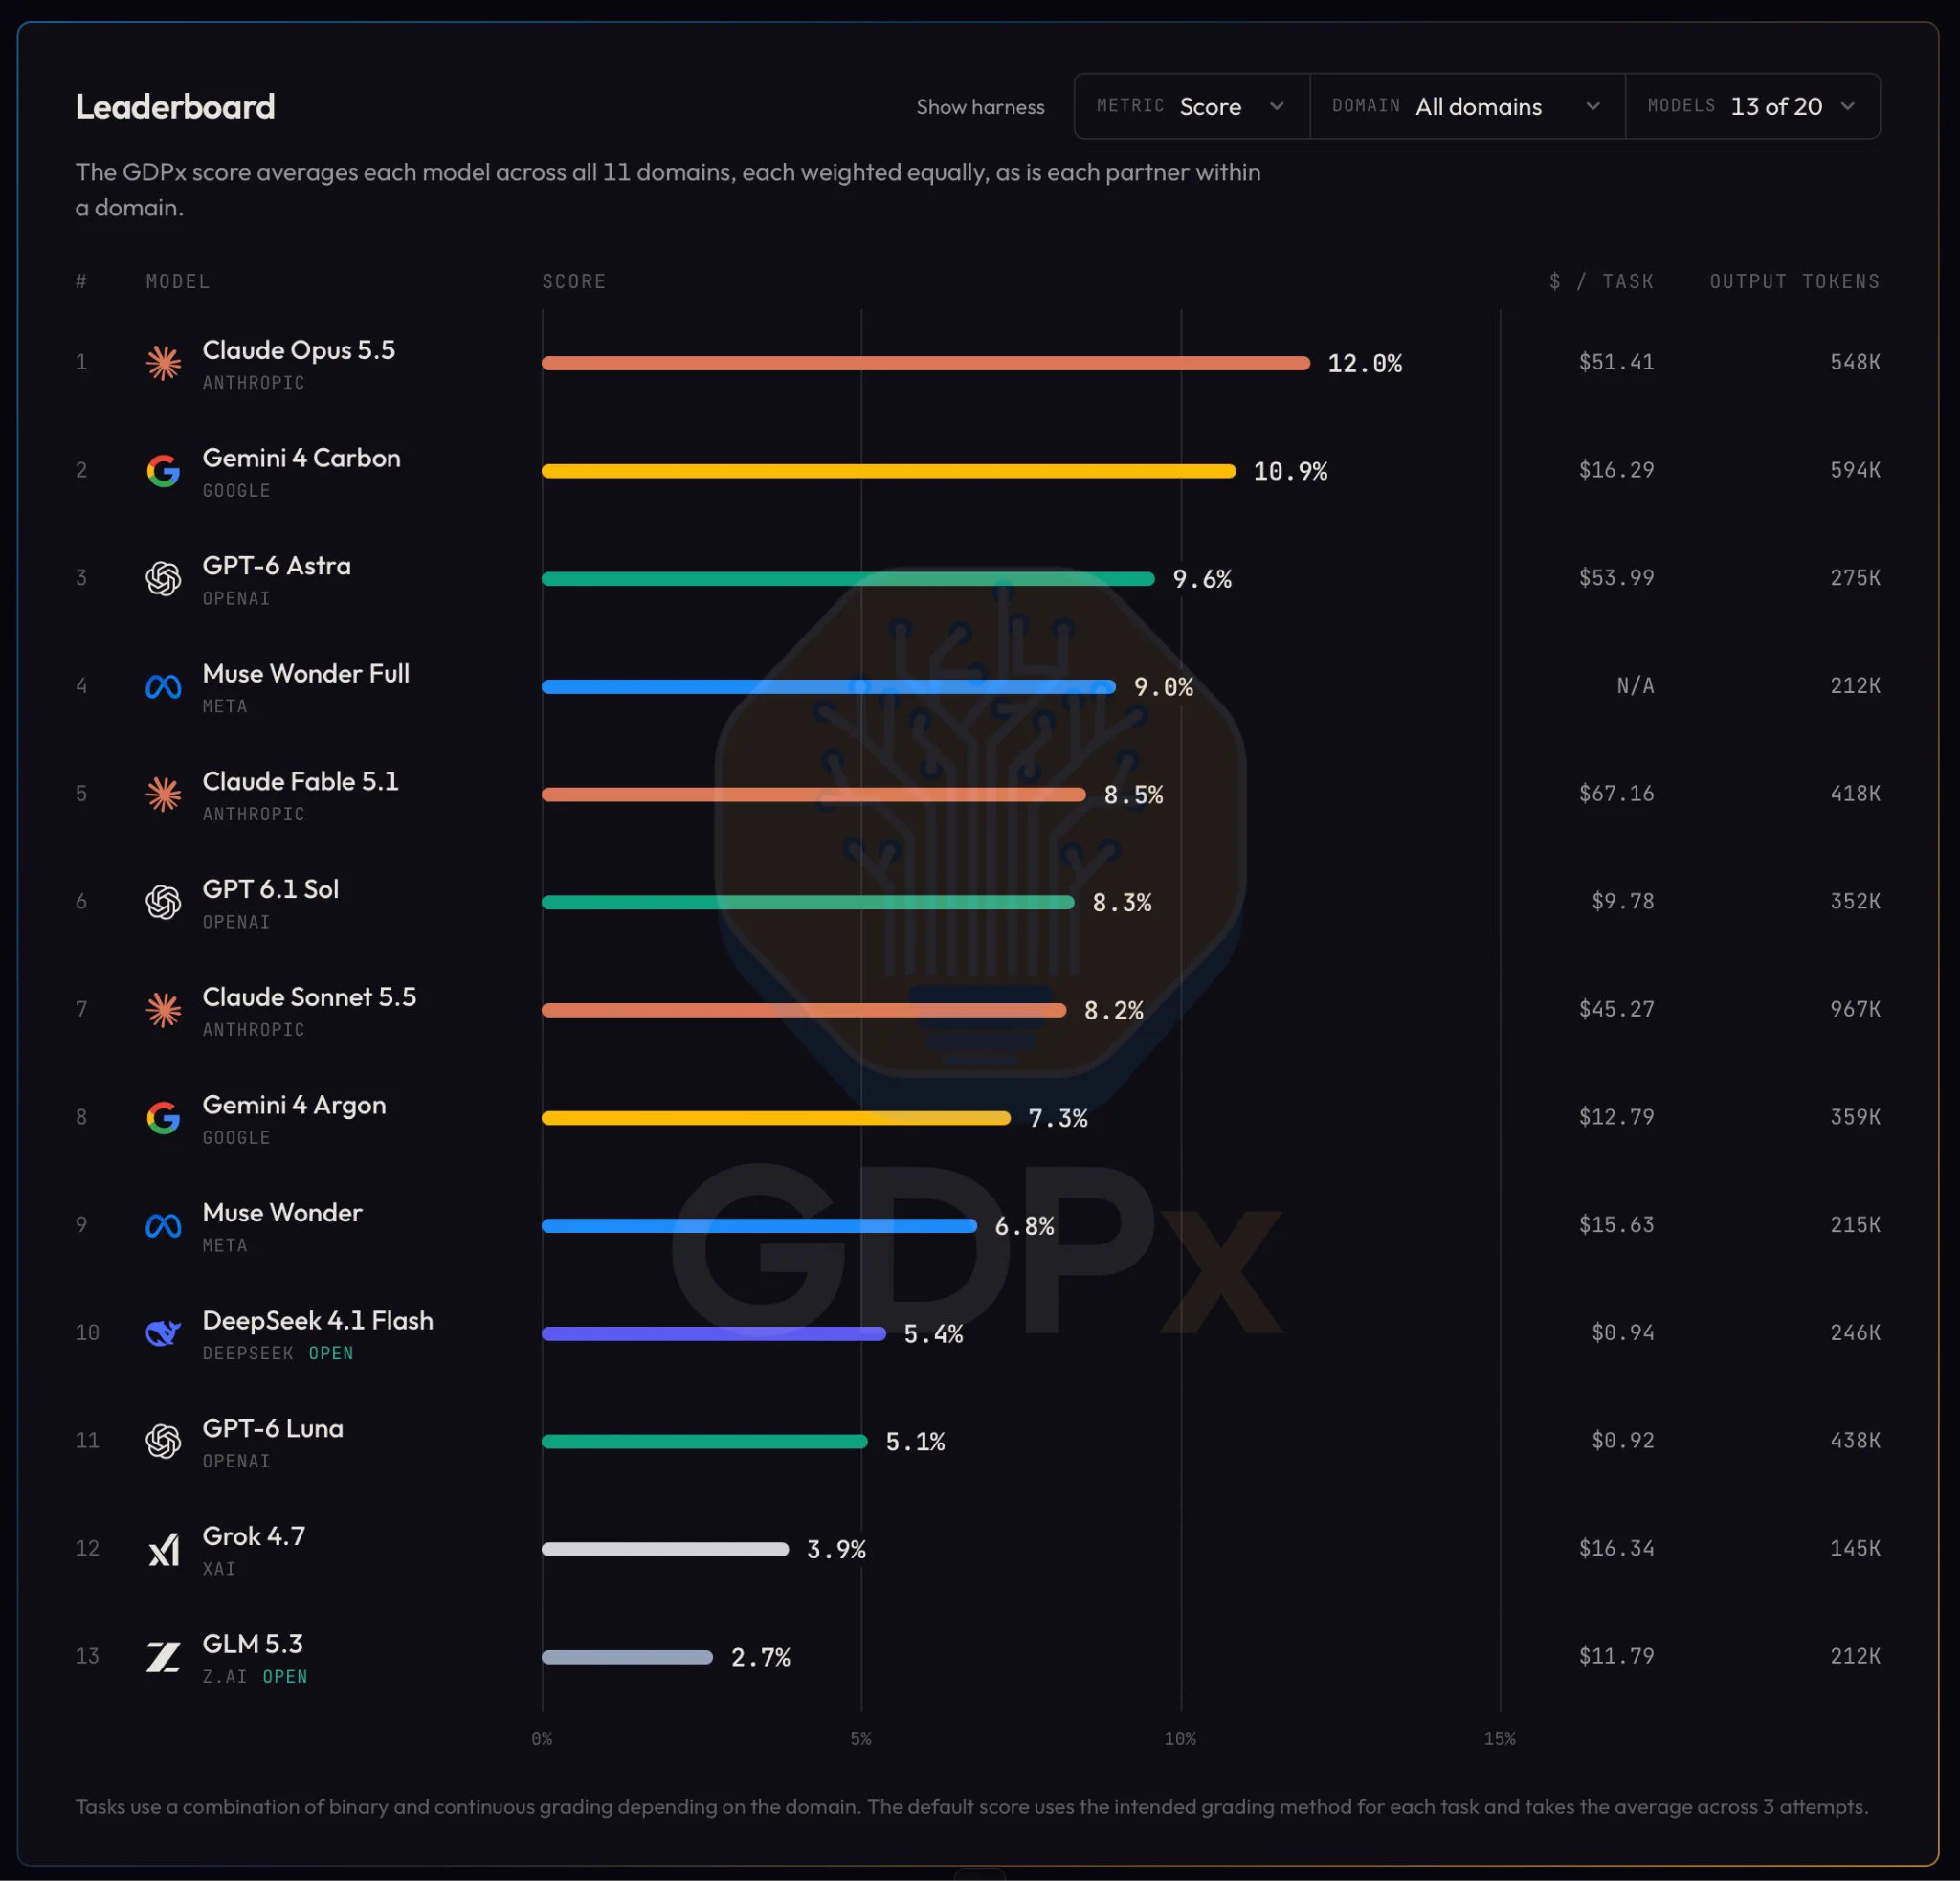
SemiAnalysis 发布 GDPx 基准,测试 AI 智能体在 11 个领域的专家工作,任务来自 14 家专业数据伙伴。Claude Opus 5.5 平均仅 12% 居首,Gemini 4 Carbon 为 10.9%;GPT-6 Astra 在 AI 研究和材料科学任务上领先。
本文介绍了 AI 驱动的平台如何将静态流程文档转化为可交互、可自我追踪的应用,让组织无需大量技术开发即可实现工作流数字化。
Addy Osmani 介绍自己如何用 Claude Code 和 Codex 的 loop engineering 原语,同时并行运行五到十个 Agent。goal 通过 /goal 定义可验证的完成条件驱动单个任务到目标达成,loop 类似 cron 按固定间隔重跑提示词,可用 /schedule 移到云端。
文章探讨了 AI 助手为何会遭遇记忆缺失,解释了无状态设计是有意为之,并深入剖析了为 AI 智能体实现持久、可靠记忆所面临的复杂分布式系统挑战。
美团 LongCat 团队发布 1.6 万亿参数的原生多模态模型 LongCat-2.5,聚焦长程智能体任务,在 AutomationBench、LongCatClawBench 等基准测试中超越 Claude-Opus-5 和 GPT-5.6-Sol,同时展示了在软件开发、3D 内容生成和办公场景下的强大能力。
腾讯混元发布 Hyra 2.0,通过基于智能体的三层架构,将自动化科学研究从直接解决问题转向开发可复用的科学模型、工作流与工具。
腾讯混元发布 Hyra 2.0,将自动化科研重点从直接解题转向由 agent 研发和升级科学模型、工作流与软件工具。系统采用 Overall、Mission、Worker 三层分工,接入企业微信、计算平台和代码仓库的实际研发环境,成果已公开在 GitHub 仓库。
Hyra 2.0 推出面向科研的工具研发框架,实现了从解题到造工具的跃迁,已成功研发出蛋白质设计模型、分子力场模型、数学证明工作流、量子码构造系统等多个可复用工具。
Sagar Batchu 认为,有效凭证不代表有效意图;智能体还需要独立身份、权限交集约束和可追溯的操作记录。
本周 GitHub 热点聚焦于 AI 规则化治理、教育系统的分段掌握机制以及多智能体并行调度的突破。
Kimi 发布「游戏开发与创意工作解决方案」,基于 Kimi K3.1 Pro 模型、Kimi Code 与 Kimi Work 系列 Agent 产品,并通过插件连接 Unity、Unreal Engine、Blender、Godot 等工具。
TRAE 推出面向开发者的 Personal Agent「TRAE宝」,每个在开发项目自带一个分身,可一次性询问所有项目进度并批量下发需求。它把拆解任务清单、带上验收标准与约束的规划步骤内化为自身能力,同一对话内前后任务可并行运行。TRAE宝可绑定飞书和微信汇报项目进展,第一周免费,从该入口开任务不花积分。
港科大与微软团队提出的首个原生长程交互 SQL Agent 框架 HarnessSQL,通过在密闭沙盒中进行轨迹监督微调与强化学习,8B 模型在 Spider 2.0-SQLite 上达到 45.2%执行准确率,显著超越 32B 专用模型,证明了交互式训练范式对复杂数据库任务的强大提升效果。
作者分享了使用 GrokBot 两个月后构建的个人智能体工作流,涵盖总控分工、收藏学习、内容生产、素材收集、资料资讯、日常杂事及友军集成等多场景自动化应用。
破解AI长期记忆瓶颈,阿里云赋能Personal Agent迈向深度个性化 · · Nov 2, 2026 11月2日, 阿里云 宣布对其 Memory 服务进行全面升级,重点面向 Personal Agent 场景增强用户偏好、计划及历史约定的长期记忆与个性化处理能力,并全面提供 [MCP] 与 [CLI] 等主流接入方式。
分享了浙大团队开源的个人 Agent 系统报告与 nanoMuse 项目,对照 Meta Muse,定义了个人 Agent 的应有形态。
IT之家 11 月 2 日消息,Y Combinator 与 Olam Labs 的人工智能研究人员近期在游戏场景中测试了智能体集群。研究选用《我的世界》及其各类玩法作为试验沙盒,让上百个智能体在其中协作或者相互对抗。研究思路是,借助游戏内的协作与冲突,帮助人们理解现实世界里那些引发广泛关注的智能体事件。