2026-10-27
OpenAI 发布 GPT-6.1 Terra
OpenAI 官方宣布 GPT-6.1 Terra。官方称 Terra 在 max effort 下 token 效率是 Claude Opus 5.5 的三倍以上,每 token 价格为其四分之一,每任务成本约低 9 倍;完成任务速度比 GPT-6 Astra 和 GPT-6.1 Sol 快三倍以上。作者称其为柏林 DevDay 级别的发布。
第 8 页
OpenAI 官方宣布 GPT-6.1 Terra。官方称 Terra 在 max effort 下 token 效率是 Claude Opus 5.5 的三倍以上,每 token 价格为其四分之一,每任务成本约低 9 倍;完成任务速度比 GPT-6 Astra 和 GPT-6.1 Sol 快三倍以上。作者称其为柏林 DevDay 级别的发布。
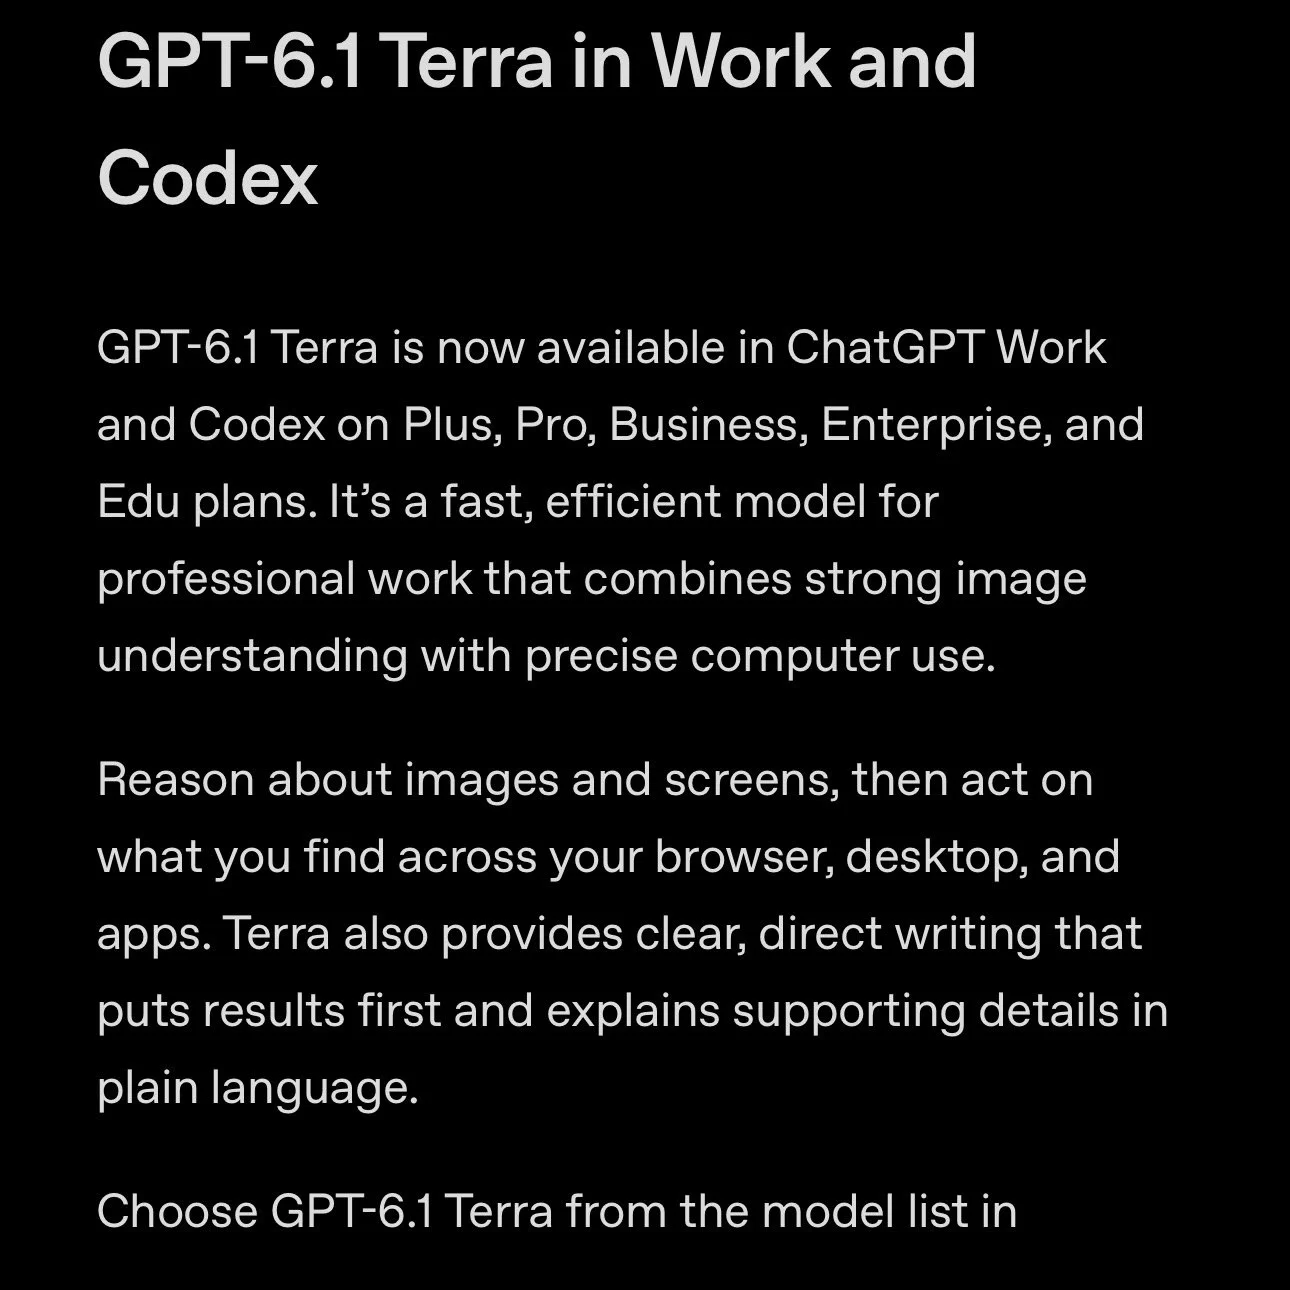
OpenAI 已发布 GPT-6.1 Terra,这是一项重大模型更新,现已通过 ChatGPT 和 OpenAI API 为所有 Plus、Pro、Enterprise 和 Edu 用户提供服务。
TestingCatalog 发现 API 出现新的 gpt-6.1-terra 模型标识,并出现在最新 Codex 更新日志中。
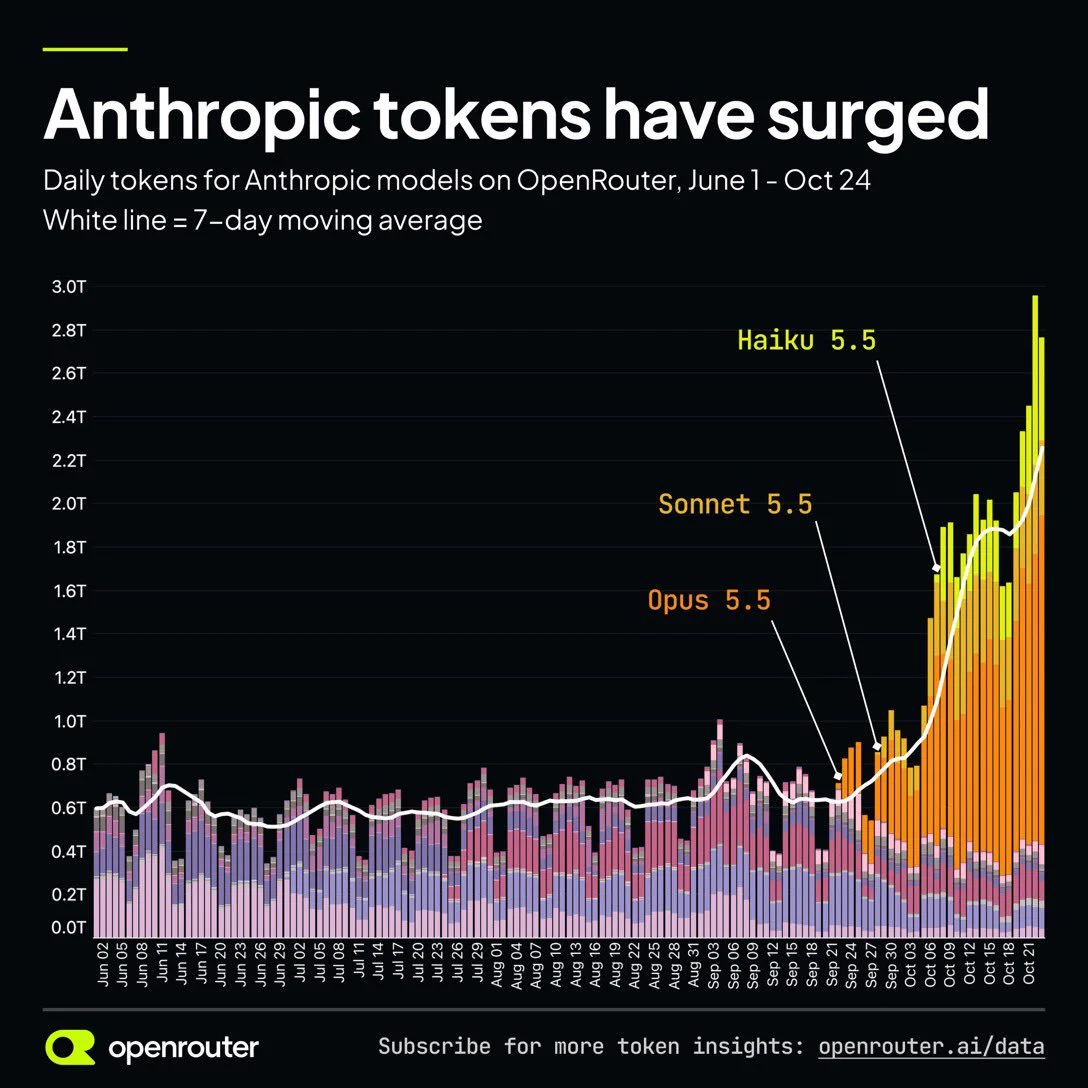
Rohan Paul 转引 OpenRouter 数据,Anthropic 模型 7 天日均 token 从 9 月 22 日约 0.65T 升至 10 月 24 日约 2.25T,约 3.5 倍。
Anthropic 与美国总务管理局(GSA)扩大合作,政府伙伴购买 Claude Enterprise、Claude for Government 和 Claude API 可享 40% 折扣,预计为政府节省 10 亿美元,且不设最低消费承诺。
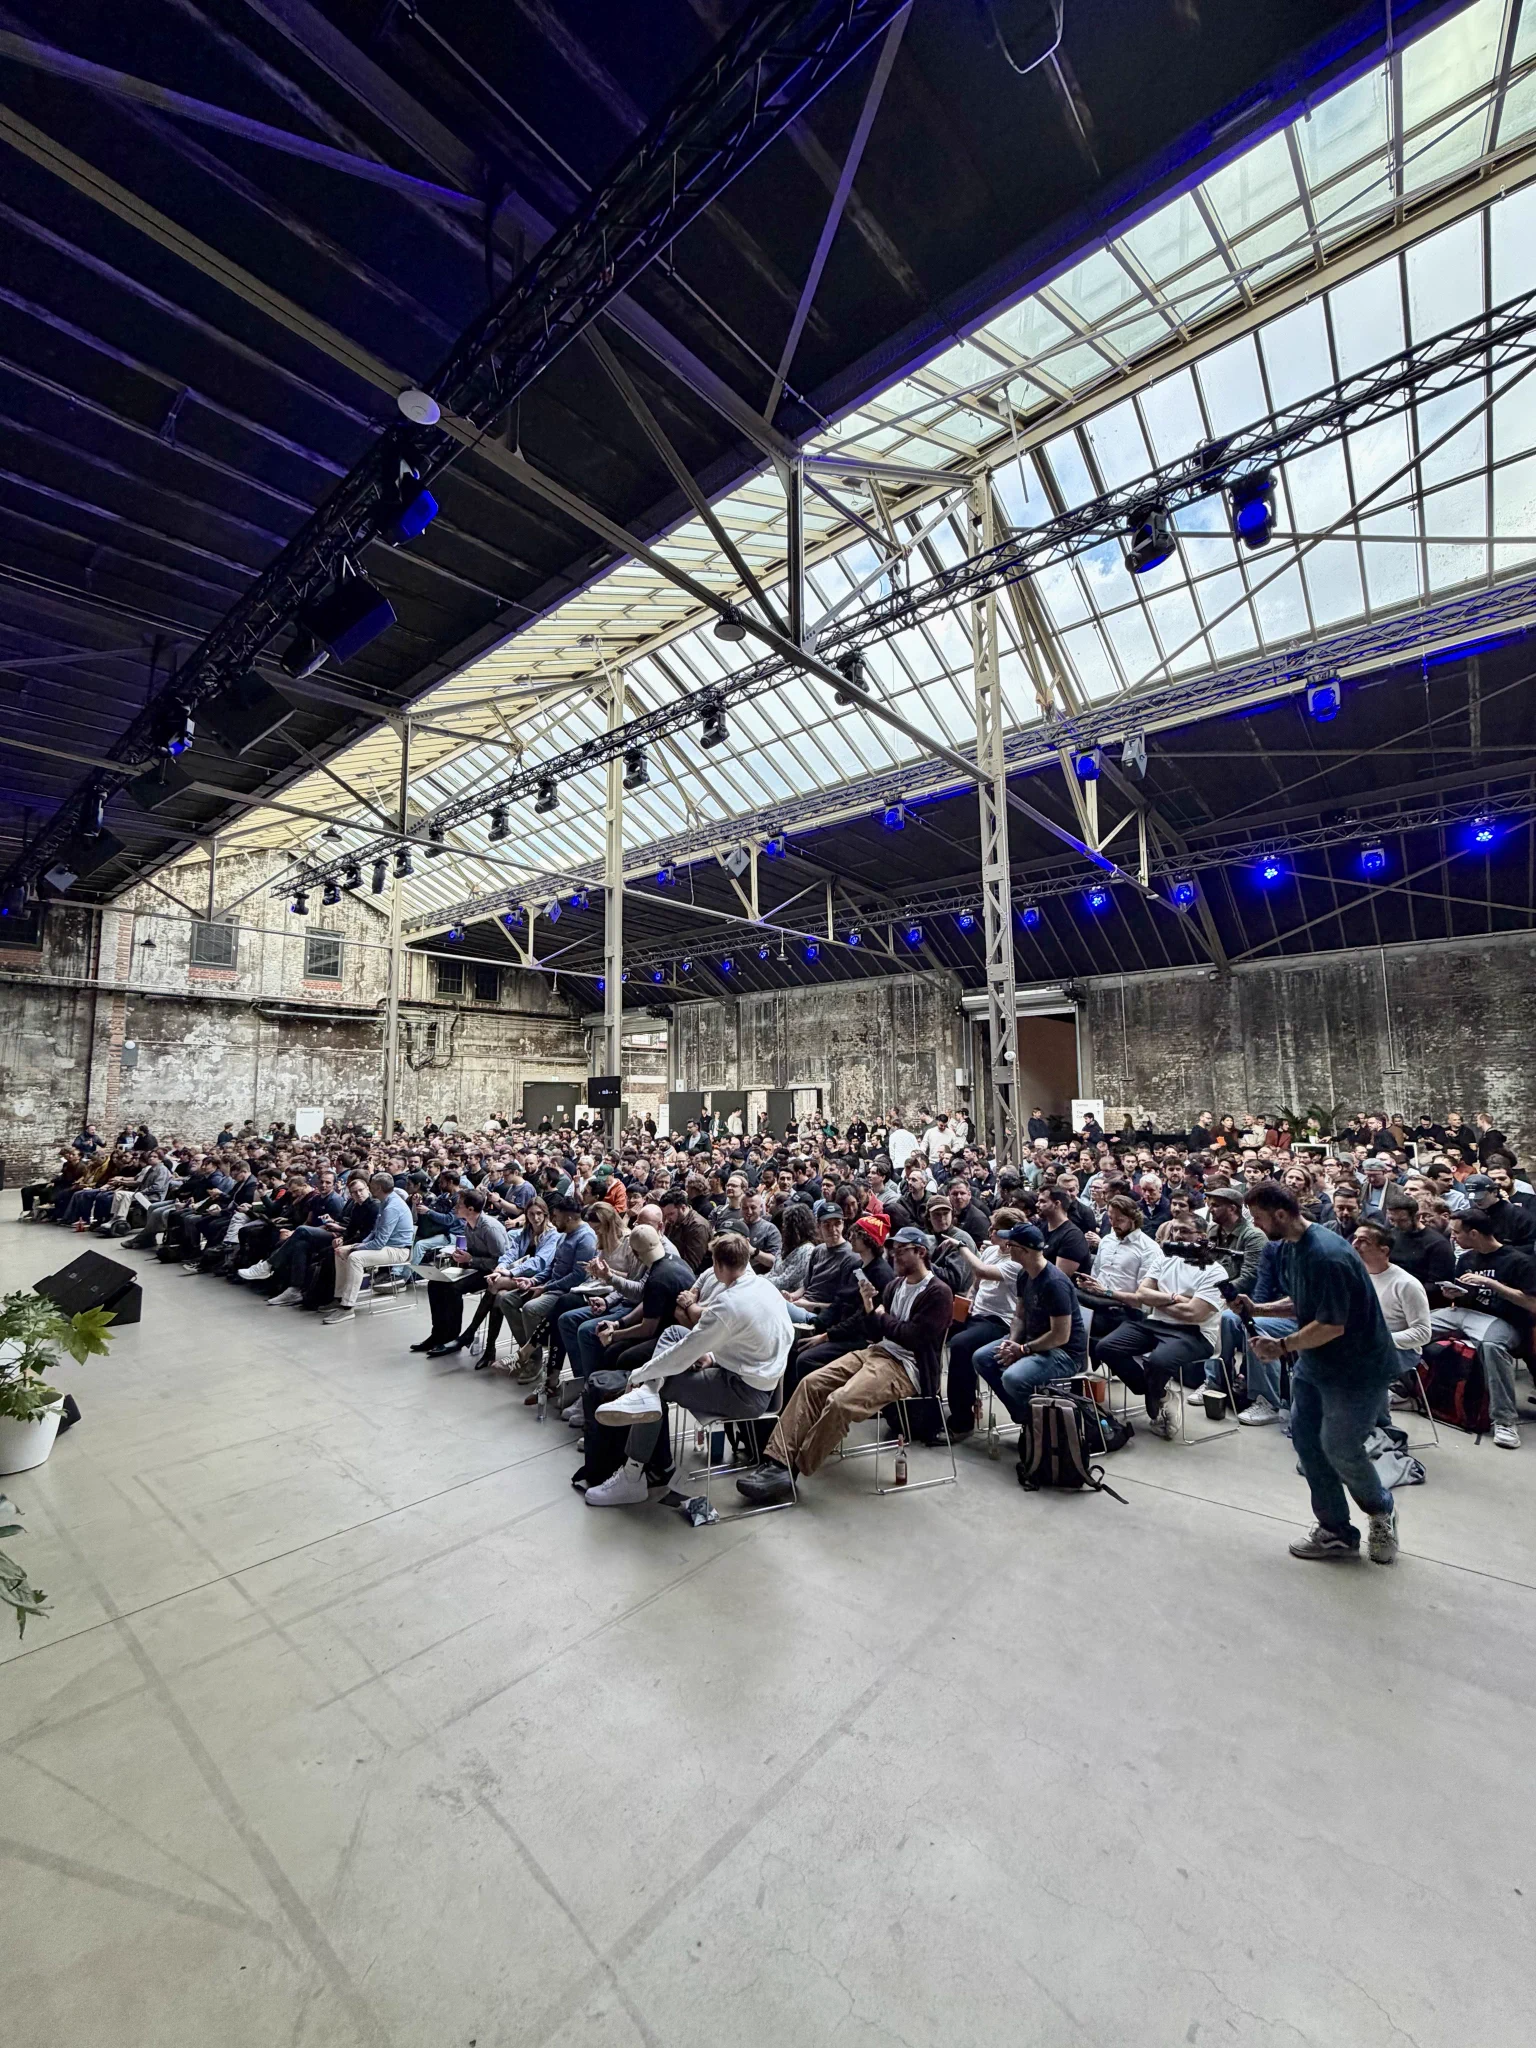
很兴奋在柏林启动我们的 DevDay Exchange,德国正热火朝天地用 Codex!!🇩🇪 - 自 1 月以来周活跃用户增长了 20 倍 - 近 70% 使用桌面应用 - 每 5 个桌面用户中就有 1 个用技能处理文档、幻灯片和电子表格 德国现在在活跃 API 开发者数量上位列全球前五。 感谢我们所有社区成员和大使的支持与热爱。
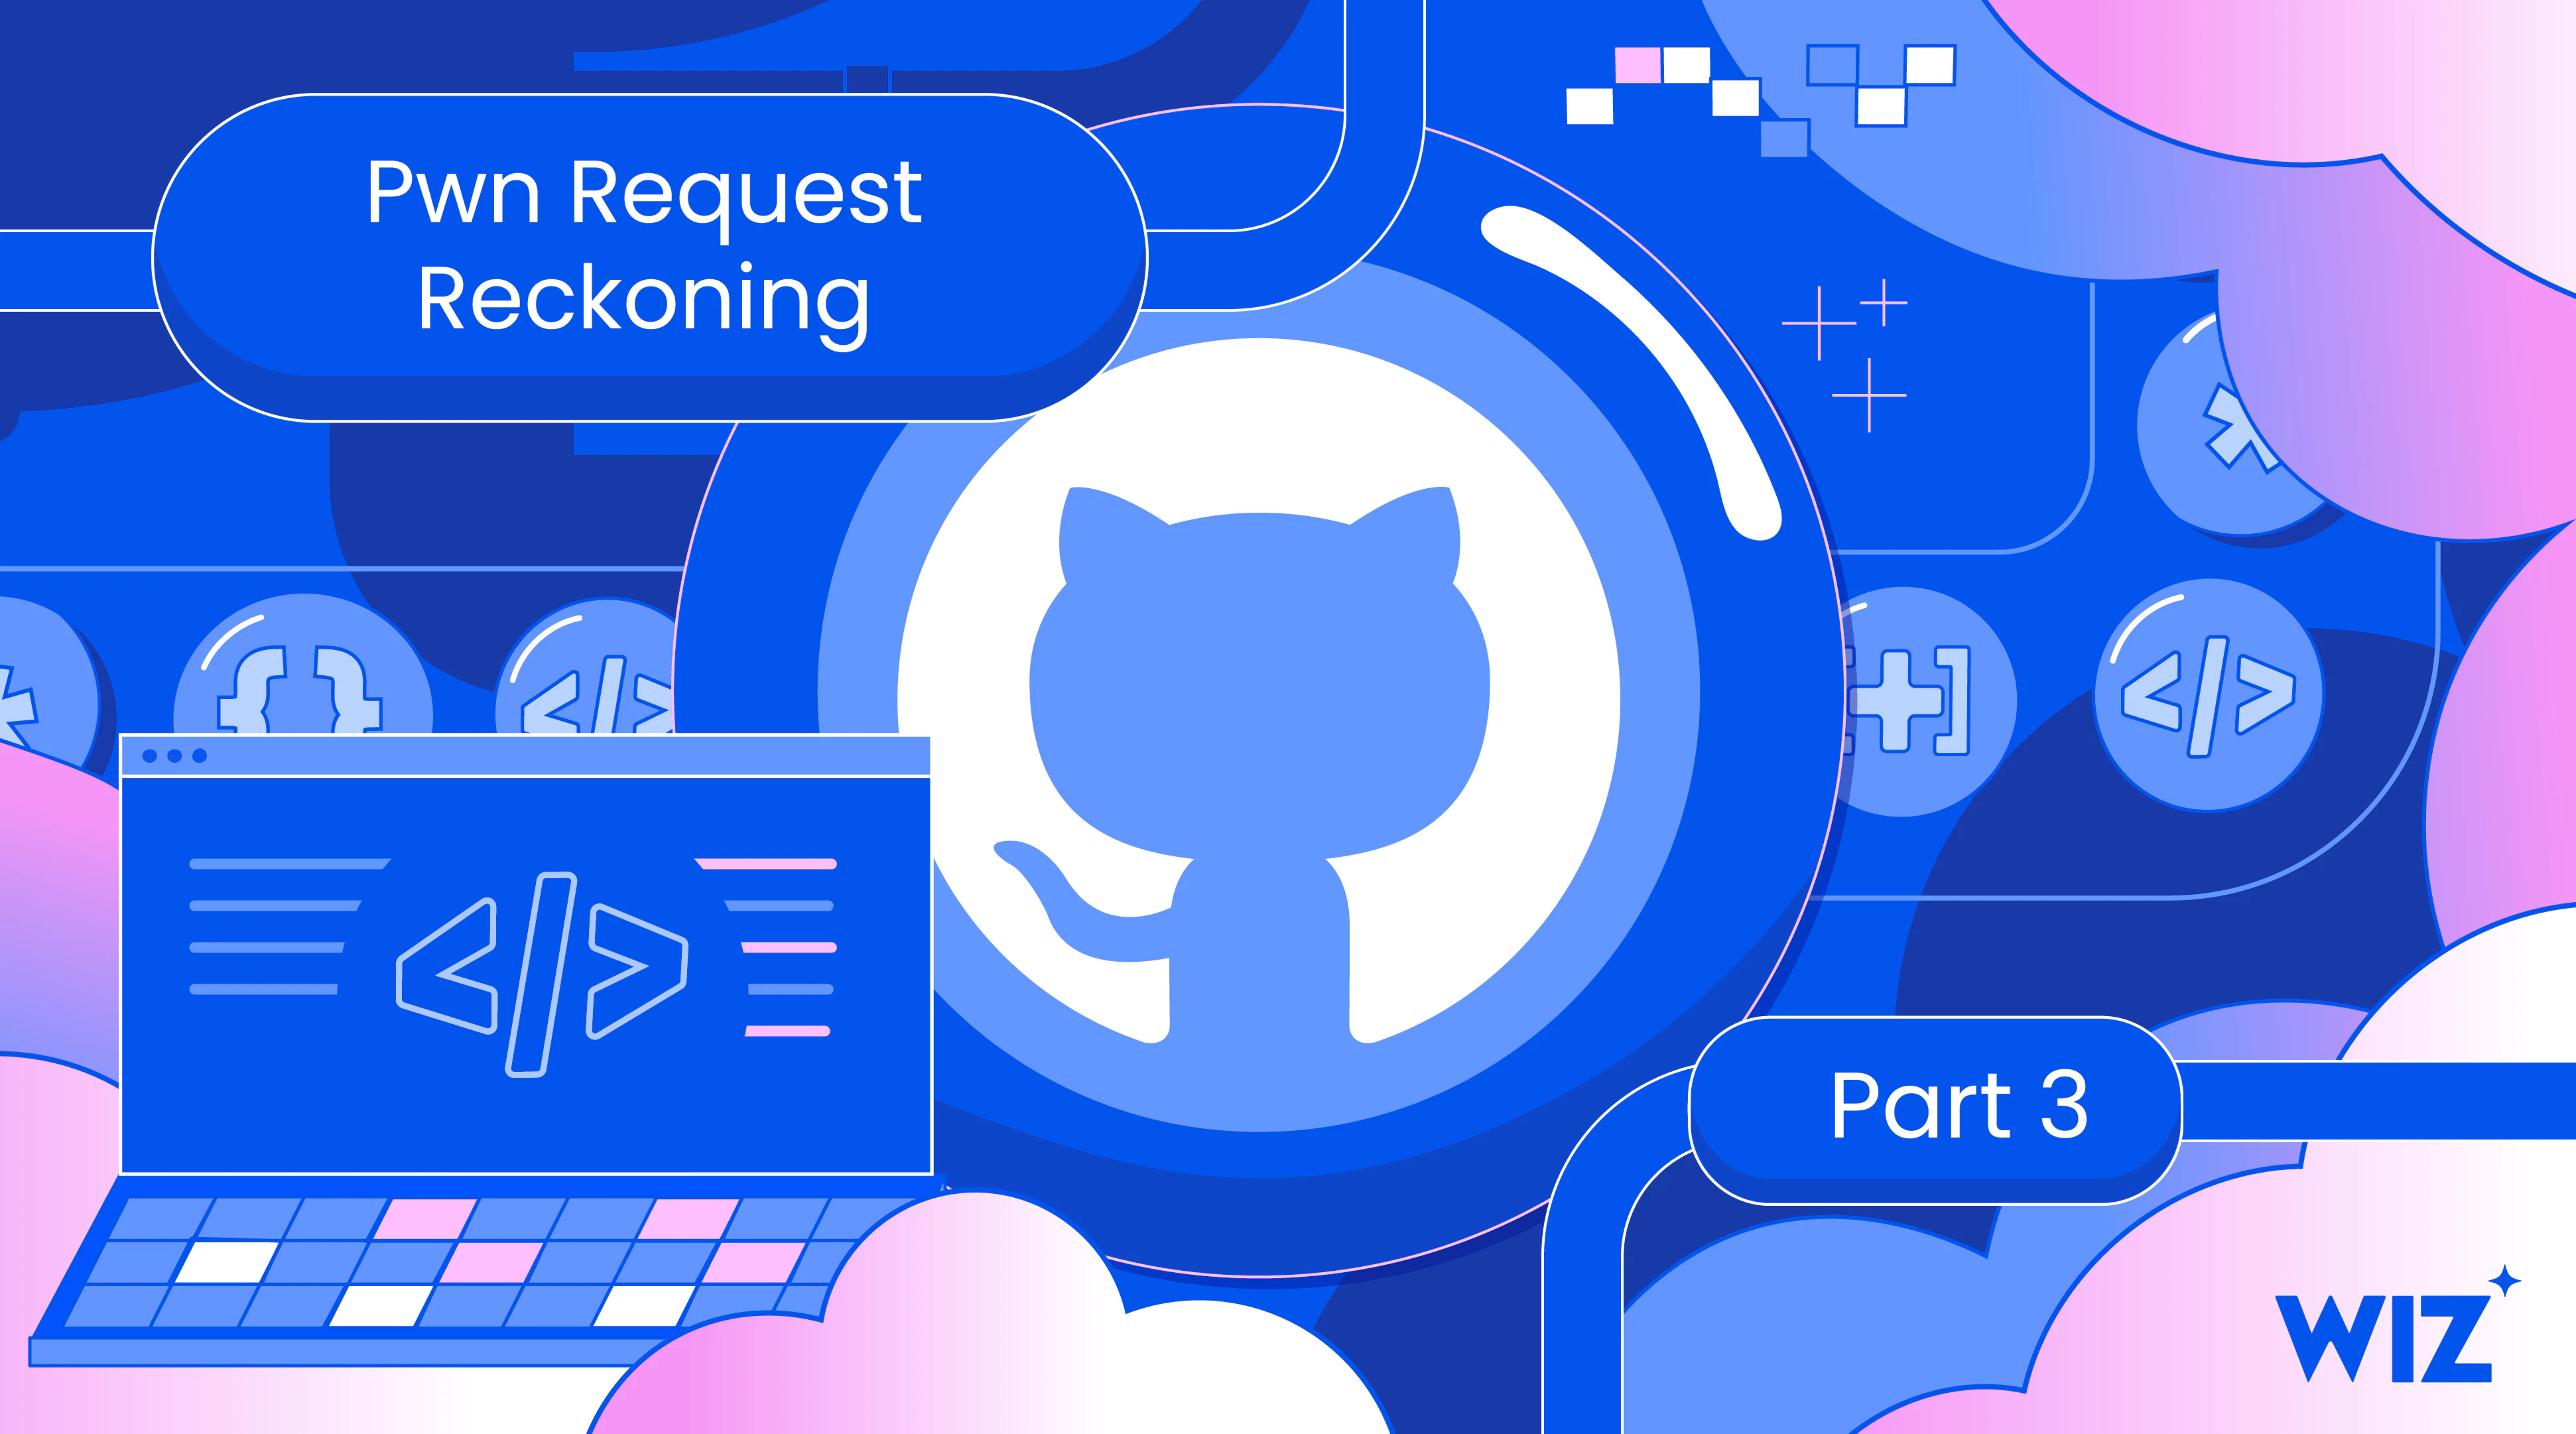
Wiz 发布 GitHub Actions 系列研究第三部分,评估 GitHub 2026 年针对 Pwn request 的平台防护效果:checkout 检出保护、只读 cache token 和事件策略让默认利用显著变难,12 月 2 日起公共仓库将默认阻止无显式事件策略的 pull_request_target。
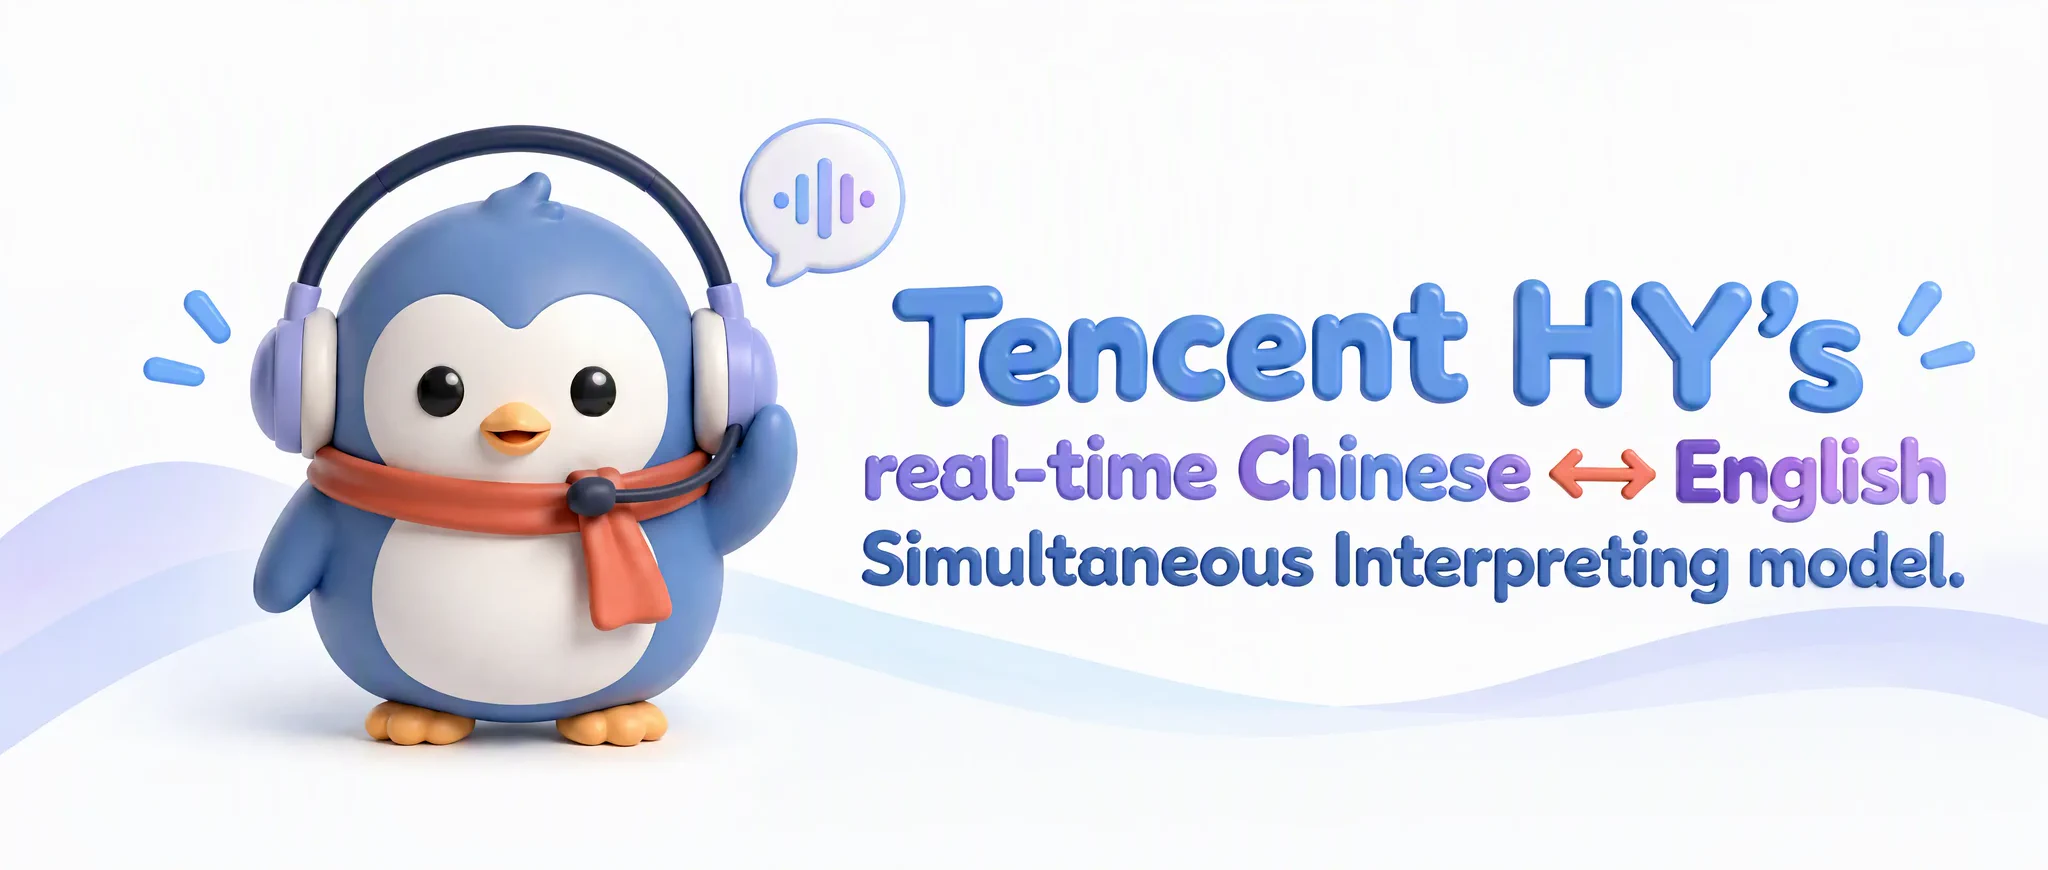
腾讯混元宣布开源实时中英同声传译模型 Hy-SimulMT。官方称其延迟约 3 秒、准确率高、支持实时声音克隆,性能超过多数开源模型和商业 API。模型已在 Hugging Face、ModelScope 和 GitHub 提供,可下载试用和开发。
腾讯混元发布 Hy-SimulMT 同声传译大模型,支持中英语音实时翻译,响应时间约 3 秒,翻译质量超越主流开源模型和部分商用 API,并提供实时音色克隆功能。
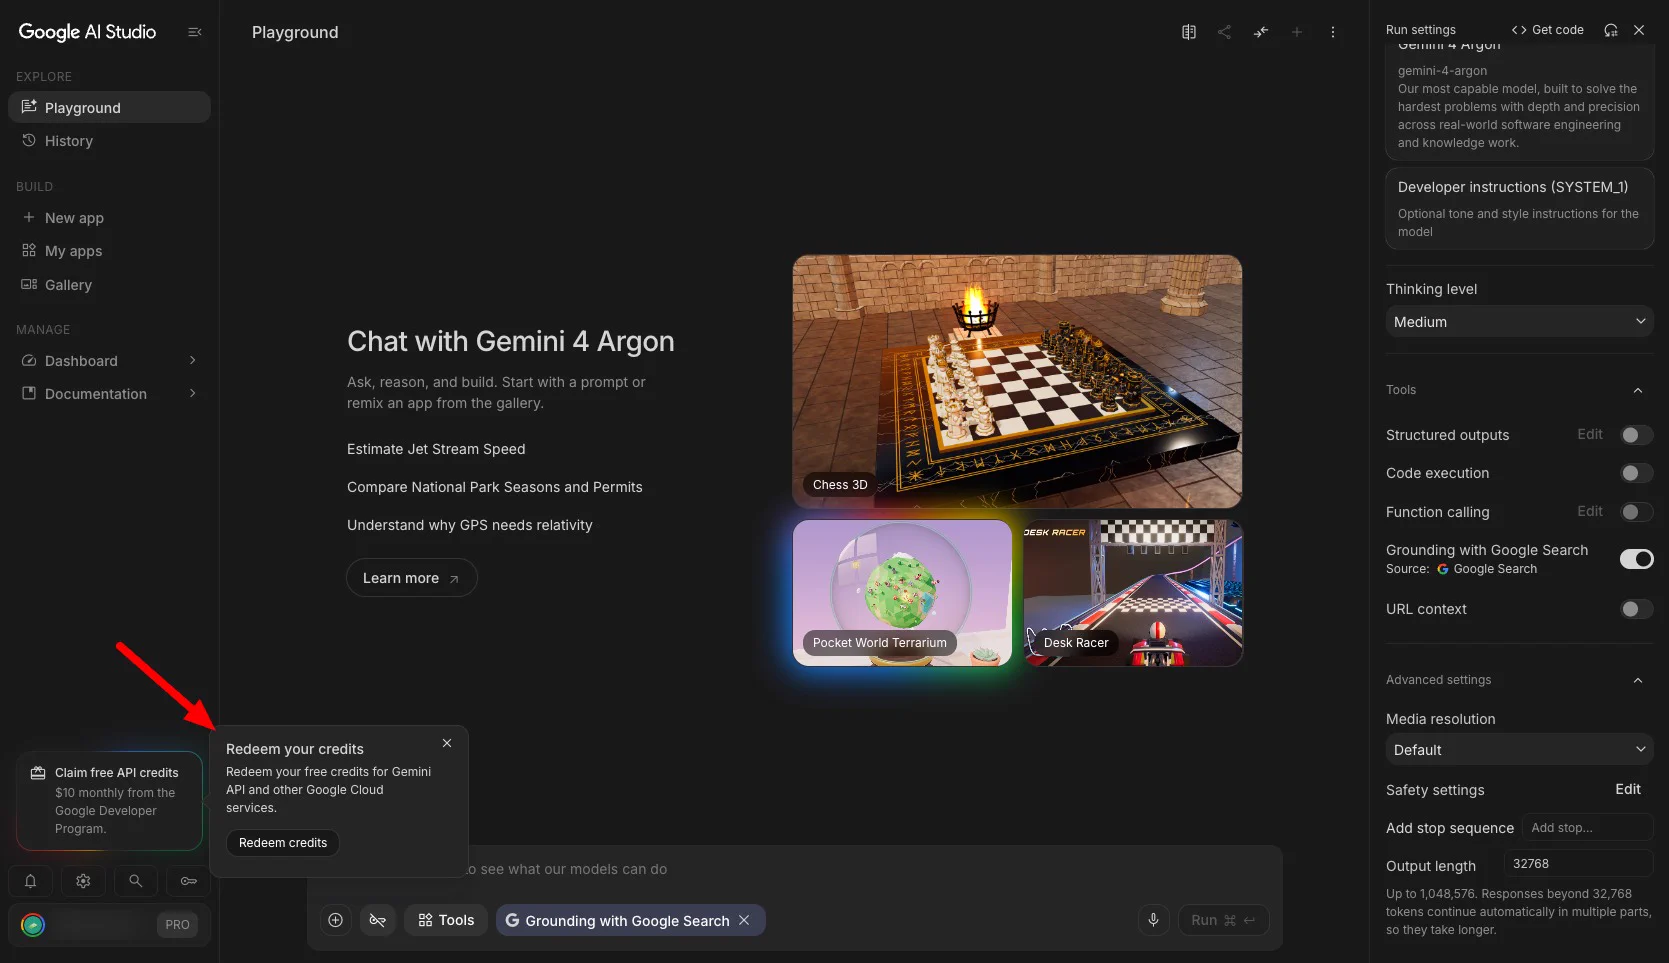
补记 👀:作为 Google Developer Program 权益的一部分,Google AI Pro 或 AI Ultra 用户每月可获得 10 美元、40 美元或 100 美元的 Google Cloud 额度。 这些额度仅可在 Google AI Studio 和 Google Cloud Vertex AI 中使用。
Runware 宣布 Kling 4.0 发布首日上线其 API,可生成最长 30 秒的 1080p 视频,并支持原生音频。功能包括多关键帧(首、中、尾帧)、单请求最多 15 个输入(关键帧、参考图、参考视频与元素)以及基于提示词的已有片段编辑。
OpenAI 发布 GPT-6.1 Terra,定位快速高效的计算机使用与视觉推理模型,标准 API 定价比 GPT-5.6 Terra 和 GPT-6.1 Sol 低 50%,为每百万输入 token $1、缓存输入 $0.05、输出 $5。
IT之家 10 月 26 日消息,据 Axios 报道,Anthropic 旗下人工智能模型 Claude 绕过付费墙 (Paywall),在未经人类授权的情况下调取了美国佐治亚州原本对公众(付费)开放的选民数据。 Anthropic 发言人表示:“在一次模型训练运行期间,Claude 抓取了佐治亚州向公众收费开放的汇总计票数据。
Hugging Face 与中关村学院、TIGEM/那不勒斯费德里科二世大学发布开源 DNA 语言模型 Carbon-X,14.8B 参数、40,960 token 上下文,基于 Qwen3-14B,用混合 tokenizer 加入 5,515 个 DNA token,可直接读 DNA 并用英文回答突变致病性预测等任务,权重采用 Apache 2.0。
Artificial Analysis 评测 OpenAI 发布的 GPT-6.1 Terra,称其在低中 effort 下达到智能与成本的 Pareto 前沿,价格为 GPT-5.6 Terra 的一半或更低($1/$5 每百万输入/输出 token)。
本文演示了一种微调技巧:用 Gemma 4 自己生成的截短答案(上限 64 个 token)来训练模型,从而在 GSM8K 题目上保持高准确率的同时显著减少 token 用量。
要在使用规模扩大时保持 AI 成本可预测,必须将 token 视为经济单位,实施提示词缓存、模型路由和批处理等策略来优化单次请求成本,而不是依赖静态预算。
Interconnects 播客第20期围绕 AI 界动荡一周展开辩论,重点讨论 Kimi K3.1 Pro 为何在亮眼 benchmark 下反响不一、能否被采用。节目还质疑此前对开源权重模型与网络安全风险的判断是否有误,并探讨为何网络安全专家与 AI 专家对近期事件的解读差异巨大。
斯坦福和 UC Berkeley 研究者发布 TokenGate,一种给现有 LLM 加上可学习 token 剪枝的模块,在 Qwen3-1.7B 上实现 1.4x 至 11.3x 的 TTFT 加速,峰值 prefill 显存降低 1.5x 至 3.4x 且无精度损失。
可灵(Kling AI)转发 Runway 官方消息,Kling 4.0 已在 Runway Dev 上线,可通过 API 与 Kling 全系列模型一起调用。该模型可生成最长 30 秒带原生音频的视频,支持最多 15 个参考图和 10 个关键帧以实现精准控制,11 月 30 日前 Kling 4 享 20% 折扣。
Convovo 研究室要求 GPT 与 Grok 模型通过 API 在近 500 个选区中指定一名候选人,Grok 4.7 在 92% 的回答中推荐共和党候选人,GPT-6.1 Sol 在 97% 中推荐民主党,两者一致率不足 10%。
某网站首页和信息流连续四天停留在周一的数据上,尽管发布流程成功、API 响应正常,原因是早前部署遗留的静态文件遮蔽了动态路由。
本文详细分析了 Transformer 模型的键值(KV)缓存内存需求,包括计算公式、主流模型的每 token 内存占用,以及根据上下文长度和模型规模选择合适 GPU 的实用指南。
可灵官方转发 fal 消息,Kling 4.0 现已在 fal 公开上线,API 面向所有客户开放。模型支持最长 30 秒带音频的原生视频生成、最多 15 个图像/视频/元素参考、最多 10 个关键帧的精确控制,并改进了运动、角色一致性和电影化叙事。
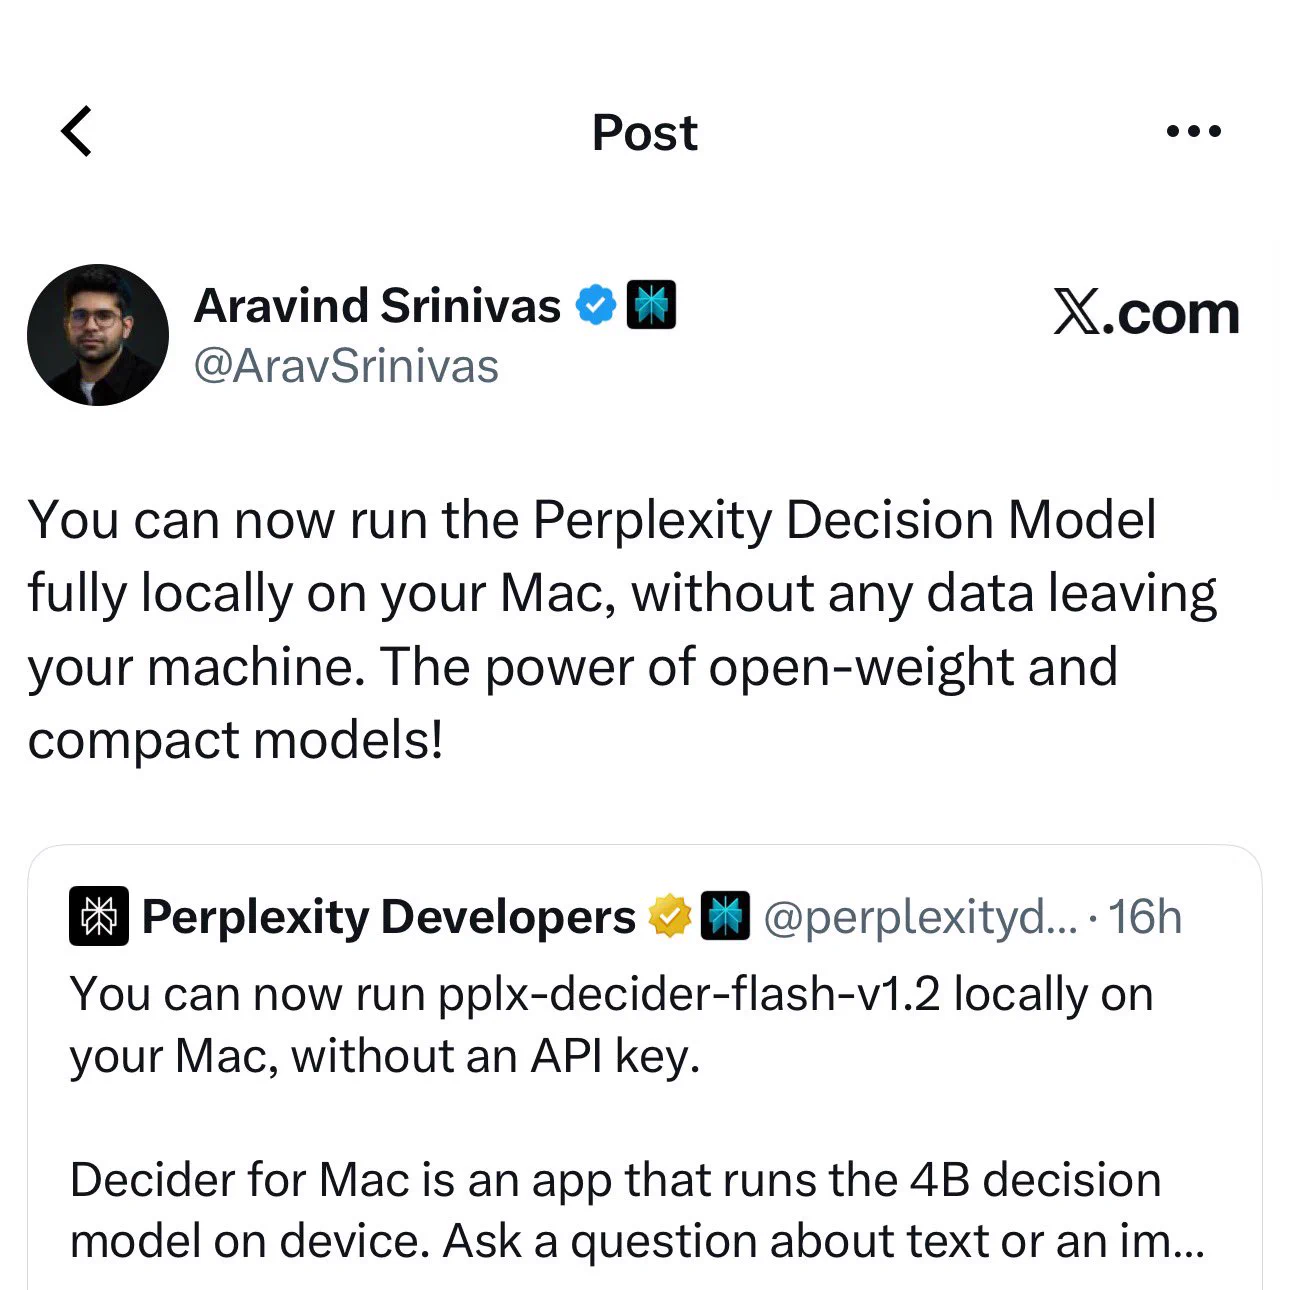
补充一下 👀:Perplexity 发布了 pplx-decider-flash-v1.2 决策模型,以 Mac 应用形式在本地提供决策 API。 该模型占用 5.8 GB 空间,需要 16 GB 内存。 100% 真实 🤖
月之暗面发布 Kimi K3.1 Pro,2.8T 参数 MoE 模型(104B 激活)、1M 上下文,已在 Kimi 网页、移动端和 API 上线,开放权重定于 11 月 4 日。
Moonshot 发布 Kimi K3.1 Pro,为 K3 的大规模后训练版本,2.8T 总参数、104B 激活的多模态 MoE 模型,上下文窗口 1M token,API 已上线,权重承诺 2026 年 11 月 4 日开放,Highspeed 版输出速度快 2-3 倍、价格为标准版两倍。
Kimi 于今天凌晨发布旗舰模型 Kimi K3.1 Pro,参数规模2.8T,支持100万Token上下文,完整模型权重预计11月4日前开放,API输入每百万Token 13元、输出68元,比K3基本砍半。
月之暗面发布旗舰模型 Kimi K3.1 Pro,参数 2.8T,支持 100 万 Token 上下文,完整模型权重预计 11 月 4 日前开放。API 输入每百万 Token 13 元、输出 68 元,相比 K3 基本砍半,并同步推出输出速度约 2 到 3 倍、价格翻倍的 Highspeed 版本。
月之暗面发布旗舰模型 Kimi K3.1 Pro,参数 2.8T,支持 100 万 Token 上下文,完整模型权重预计 11 月 4 日前开放。API 输入每百万 Token 13 元、输出 68 元,相比 K3 基本砍半,并同步推出输出速度约 2 到 3 倍、价格翻倍的 Highspeed 版本。