2026-09-10
DeepSeek V4.1 Flash 模型正式发布:全面超越 V4 Pro、原生多模态视觉理解,API 定价下调
IT之家 9 月 10 日消息,深度求索今日正式发布 DeepSeek V4.1 Flash 模型 。这是其全新模型结构系列中的最小尺寸的模型,具备原生多模态视觉理解能力。 新模型结构的设计初衷是:能力上限更高、推理速度更快、吞吐更大、可扩展到更大参数模型
第 3 页
IT之家 9 月 10 日消息,深度求索今日正式发布 DeepSeek V4.1 Flash 模型 。这是其全新模型结构系列中的最小尺寸的模型,具备原生多模态视觉理解能力。 新模型结构的设计初衷是:能力上限更高、推理速度更快、吞吐更大、可扩展到更大参数模型
DeepSeek Harness v0.1.5 发布,新版本与 DeepSeek V4.1 Flash 模型训练深度结合,模型在 Harness 的不同配置中均做了专项训练和优化。同时推出实验性的 Agent Teams 功能,主打"一切皆插件",团队仍在开放招聘。
中国联通董事长董昕在 2026 中国联通合作伙伴大会上表示,公司连接总规模已突破 13 亿,并将在"十五五"期间预计撬动千亿级投资用于算力网建设。他提出要全链条经营 Token,增强其创造、存放、转运、清洗、应用能力,并全面开放 Agent 加 Token 加 AI 云的运营体系。董昕还称将打造拖拉拽商城、开放即取即用能力组件,以差异化产品破解同质化竞争。
Mistral 帮一家欧洲能源公司将运行多年的 Fortran 77 油藏模拟系统迁移到 C++,项目共 30 万行代码,第一阶段完成 4 万行(https://mistral.ai/news/legacy-code-modernization/)。
作者归纳 Anthropic 公开的企业级电商 Agent 实战指南,总结出架构、上下文分层、UI 卡片、模型选型、缓存、权限与记忆七条要点。
Mistral 帮助一家欧洲能源运营商将 40000 行 Fortran 77 储层模拟器迁移到 C++,并复盘了方法与经验。
作者以 GPT-6 Astra 的視覺操作表現為切入點,提出其能力躍升更可能來自 GUI 環境、軟體操作影片預訓練與強化學習的結合,並將 Agent 競爭的 Scaling Law 概括為對交互環境的擴展。
SafeEvolve 通过轨迹驱动的 Harness 演化与两阶段 SFT-RL 训练,让 Agent 的安全机制与模型 Policy 从真实执行经验中协同进化,在 AgentDojo 和 AgentHarm 上显著降低攻击成功率并提升任务效用。
Datawhale 发布九月组队学习活动,涵盖 LLM 推理与显存优化、Agent 工程实践、AI 工具应用、算子开发和深度学习等 11 门课程,强调动手实践与开源协作。
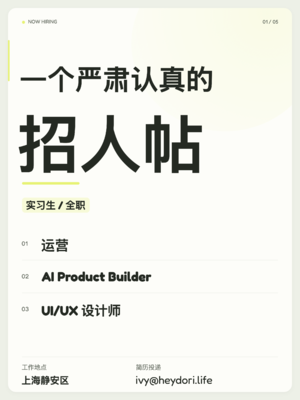
这是一则严肃的招聘启事,团队正在寻找对 AI 有热情、真诚、聪明的年轻人,共同打造生活方向的 AI Native App,并构建一个效率与自由交织、Agent 与人融合的小团队。
8 月 AI 产品趋势显示,用户从网页转向手机系统和浏览器侧边栏等入口,办公智能体如阿里千问办公和腾讯 WorkBuddy 增长迅猛,头部格局向 B 端和入口集中,垂直赛道冷热不均。
实测讯飞星火 X2.5,通过 3D 粒子交互网页、财报拆解、论文实证、电商数据筛查和游戏官网设计等任务,验证其在代码与智能体能力上的交付水平,并探讨 Agent 从聊天走向交付、国产算力从适配走向全链路闭环的行业趋势。
Hugging Face 联创 Thomas Wolf 回应 OpenAI 用下一代模型(强于 GPT-6 Astra)的 agent 群组证明 Navier-Stokes 千禧年问题猜想为假的结果,称其令人印象深刻。
2026 年 8 月 AI Web 数据显示,千问办公和 WorkBuddy 等办公智能体增长爆发,整体网站访问下降,表明 AI 使用正从打开网站向各类入口深度渗透。
蚂蚁百灵发布首个金融增强开放模型 Ling-3.0-flash-Fin,瞄准投资研究完整工作流,并同步开源金融搜索 Agent 评测基准 FinFIRST,推动金融 AI 从“会回答”走向“能干活”。
HAM-VLN 通过四层分层记忆和深度几何绑定的世界图,将大模型推理与记忆检索合并,令零样本视觉语言导航在三大基准上刷新 SOTA,且上下文 Token 削减 67%。
花叔用 800 字故事让视频 Agent「够搭」自动拆成 17 场戏、生成设定图和视频片段,拼出 5 分钟成片,并验证了成片后局部修改不推倒重来的能力,认为 AI 视频创作进入更可控的「单反级交付时代」。
EMNLP 2026 论文提出 SCOPED-Hiring 框架,揭示 LLM 多智能体招聘系统中即使最终录用率看似公平,决策轨迹中仍存在隐藏的不公平,并通过诊断驱动的 Fair Skills 修复将公平负担降低 72.3%。
清华团队开源的教育 AI Agent OpenMAIC 登上联合国教科文组织讲台,其 v1.0 版本通过课程级规划、教学法 Skill 和名师课堂复刻等功能,将 AI 备课从单课生成推向整门课程的深度交互,并揭示教育正成为 Token 消耗的下一个大场景。
腾讯开源 teamai-cli,用 Git 与 PR 审核流程把 skills、规则、hooks、MCP 同步到 10 种 agent,解决「最会用 AI 的人经验烂在自己电脑上」的问题。
Meta 的 Muse 智能体产品开放更多用户试用,入口为 https://muse.ai/join,Meta 首席 AI 官 Alexandr Wang 称团队为产品倾注心血并感谢用户反响
OpenAI 宣布给出 Navier-Stokes 千禧年大奖难题的一个解,证明由一组智能体使用比 GPT-6 Astra 能力强得多的 OpenAI 下一代模型产出
OpenAI 宣布给出数学前沿难题之一的 Navier-Stokes 千禧年大奖难题的解,该证明由一组智能体使用一个能力显著强于 GPT-6 Astra 的 OpenAI 新一代模型产出。该问题关注 Navier-Stokes 方程描述的光滑三维流体运动是否会崩溃,已悬置约 90 年。
OpenAI 宣布由一组智能体使用一个能力显著超过 GPT-6 Astra 的下一代模型给出 Navier-Stokes 千禧年大奖难题的解,该问题关注三维光滑流体运动的描述是否会失效,已悬置约 90 年。
Tom Tunguz 引用 OpenAI 内部数据,分析其 3x 研究生产力增益的来源:每名研究员 8 小时班次对应 3.14 个 agent 工作日,通常并行运行 4 个 agent。