2026-10-30
Agent 后训练学习指南
本文系统梳理了 Agent 后训练的五大步骤——监督微调、蒸馏、强化学习、强化学习环境与 Harness 与规模化,并提供示意图、课程与代码入口,帮助读者快速搭建完整的 Agent 训练流程。
第 16 页
本文系统梳理了 Agent 后训练的五大步骤——监督微调、蒸馏、强化学习、强化学习环境与 Harness 与规模化,并提供示意图、课程与代码入口,帮助读者快速搭建完整的 Agent 训练流程。
该手册由阿里云发布,专门针对企业环境下的 AI Agent 开发和治理,涵盖了从架构设计到运维调参的完整生命周期,并提出了用 Harness 来解决概率智能在生产环境中可靠性的挑战。
IT之家 10 月 30 日消息,当地时间 10 月 29 日,法国公司 Mistral AI 正式开放 Mistral Large 4(简称 ML4,代号 le Chonk)模型权重。 ML4 是一款拥有 1 万亿总参数、490 亿激活参数(包括嵌入层和输出层在内为 520 亿)的原生多模态模型。
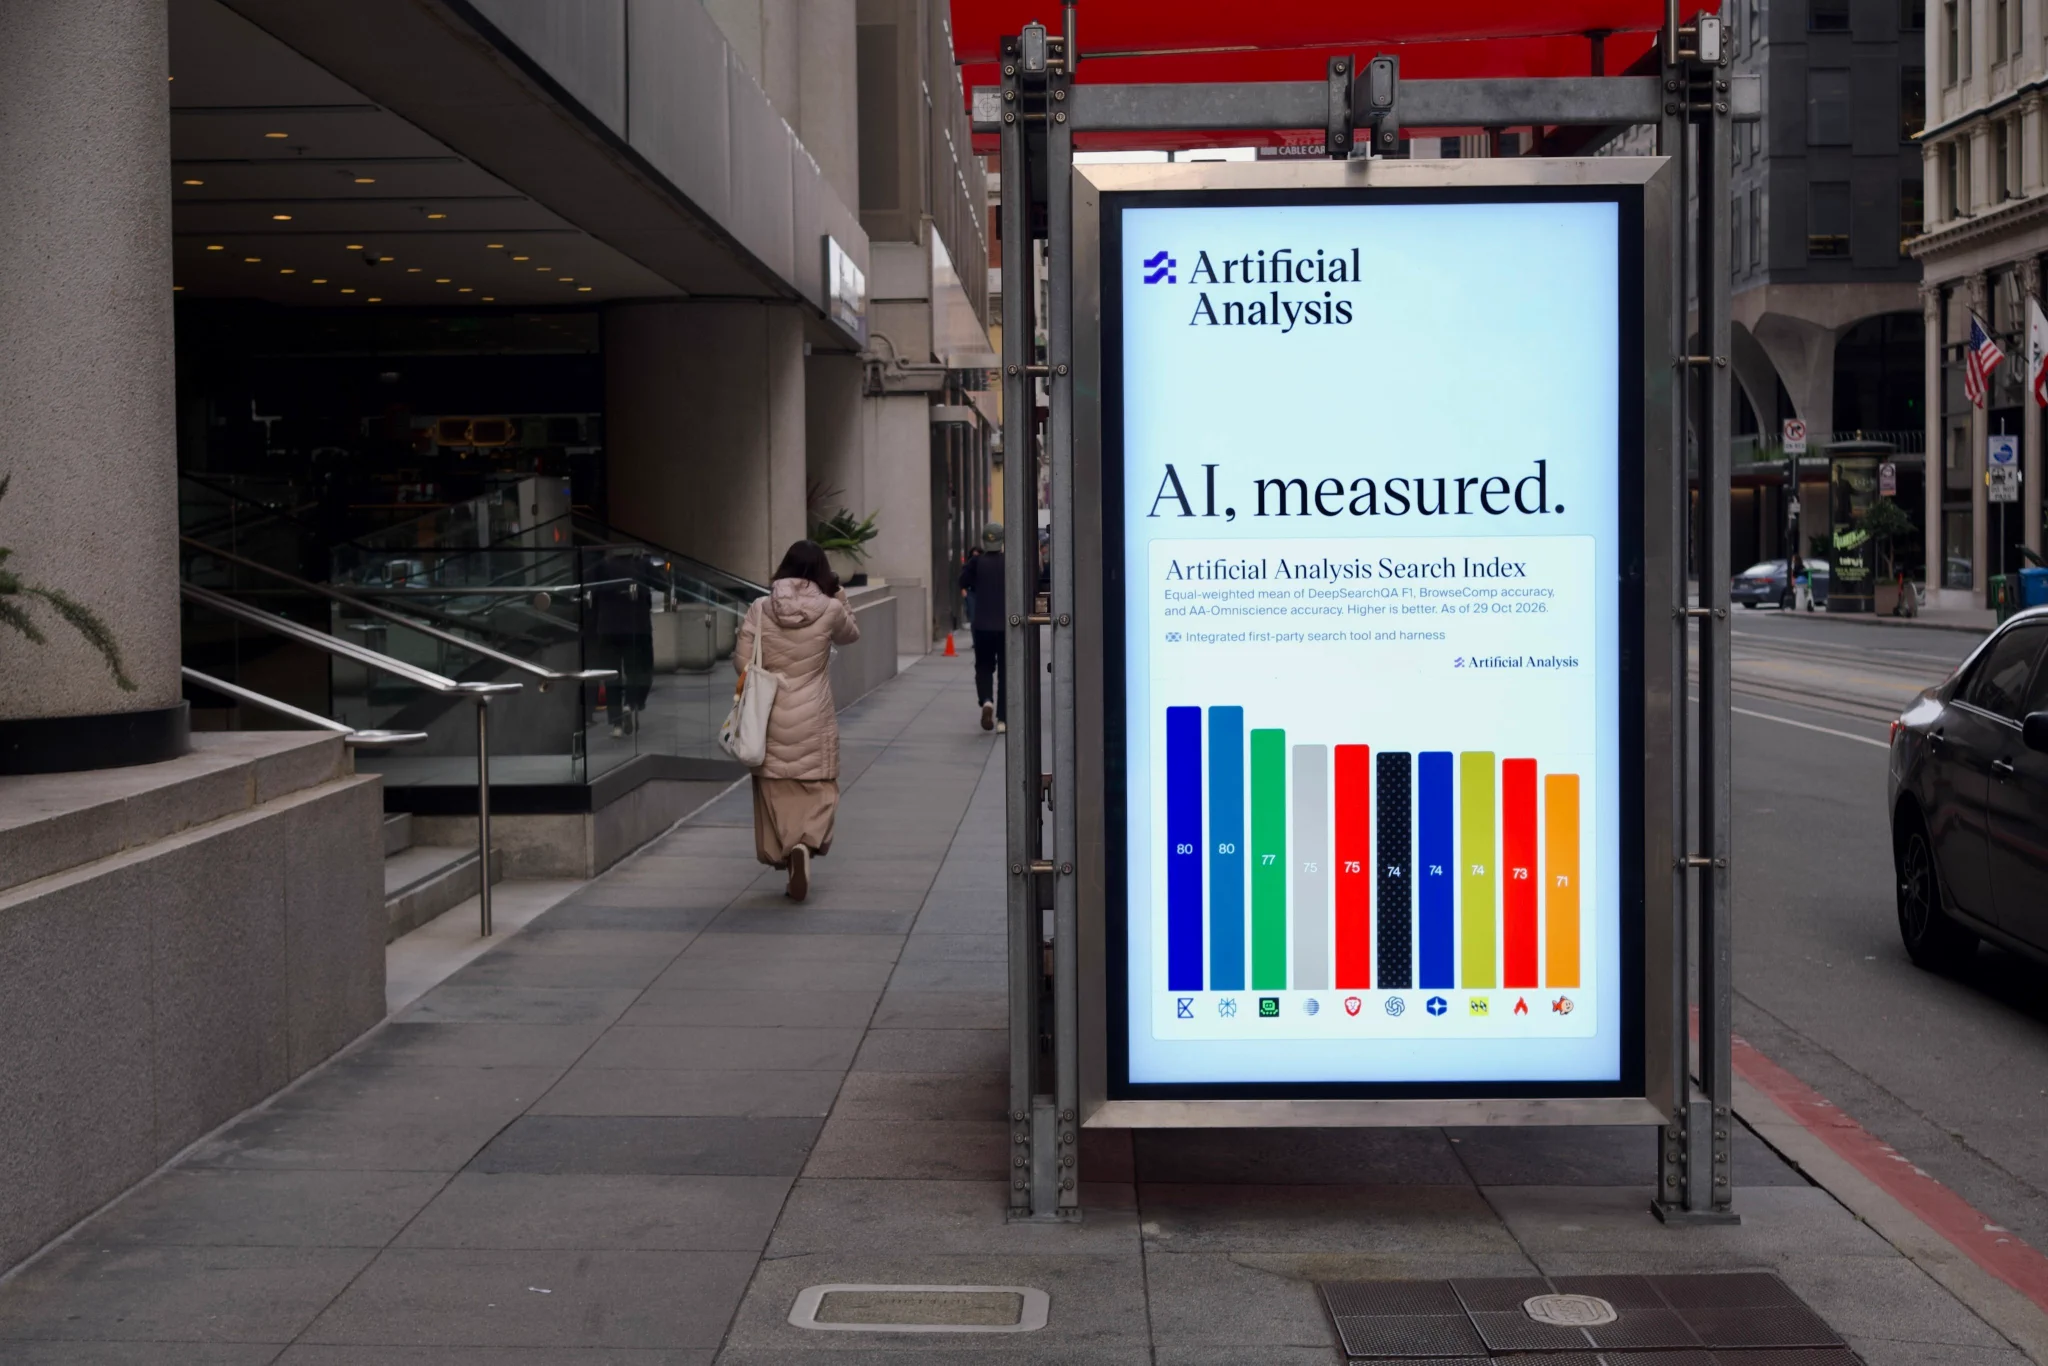
Artificial Analysis 推出 Search Index,在 1700 个任务和 BrowseComp、DeepSearchQA、AA-Omniscience 三个搜索基准上,用同一基础模型和测试框架衡量各 Search API 的性能、成本与延迟。
智己 LS8 NEO 纯电版以全线控底盘、宁德时代定制电池和 IM Claw 智能体为核心,提供 25 万元级高续航 SUV,并通过终身免费 Token 提升车载智能体验。
OpenRouter 实测 Claude Opus 5.5、Sonnet 5.5 与 Haiku 5.5 三档模型,建议默认用 Sonnet 5.5,高频与子智能体任务用 Haiku 5.5,长且容错成本高的任务用 Opus 5.5。
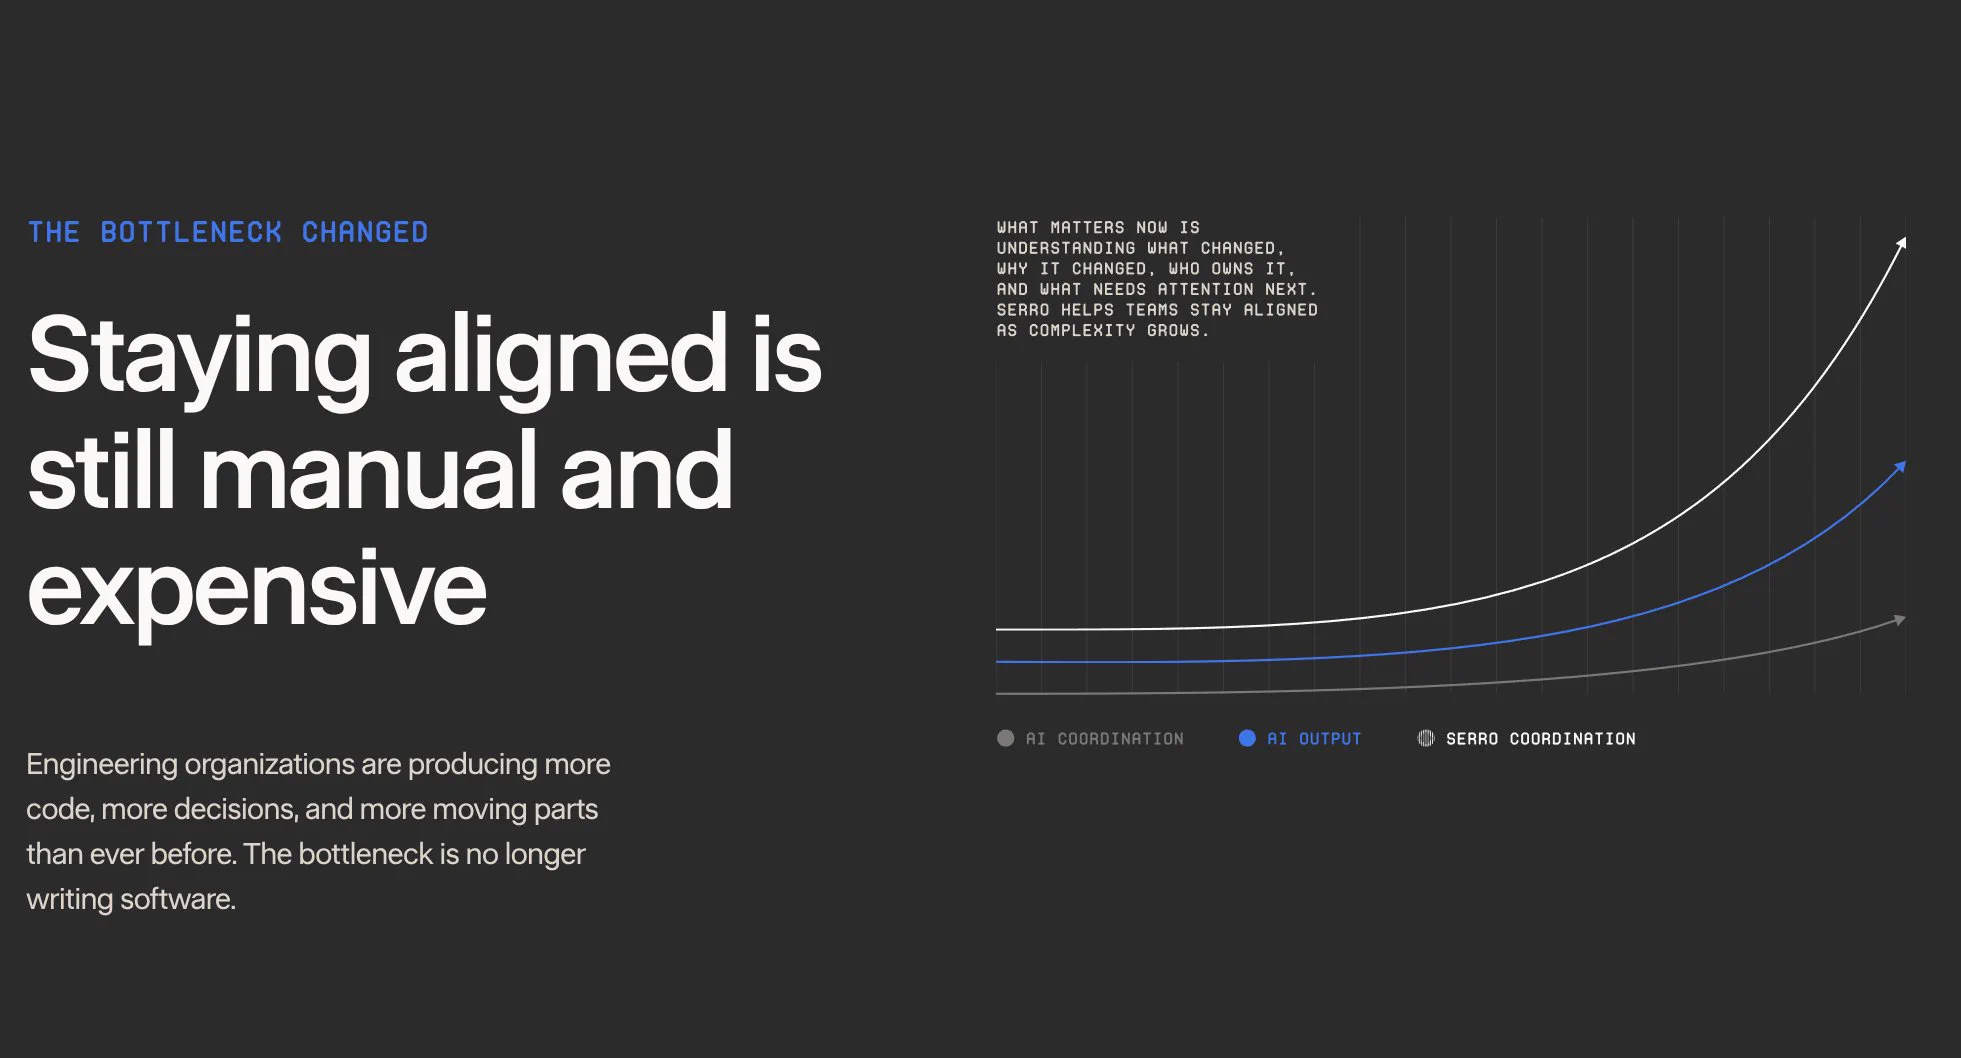
Serro 推出“Agentic TPM”,用于在决策变更时同步更新编码智能体。它连接 Slack、Linear、GitHub、Jira、Zoom、Notion、邮件和代码库,维护每个项目决策、负责人、风险与历史的版本化记录。其思路是把编码智能体失败视为协调问题:智能体仍在执行人们已在会议、聊天或工单中改掉的决策。
Figma 介绍其为 agent 自研 Figma 编辑模型的训练方法,先用超过 25 万条合成样本做 SFT,让早期 Llama 3.3 70B 在编辑任务上接近当时顶级模型,后转向 RL 并结合确定性校验器与视觉评委做评测。
Shopify CEO Tobi Lütke 在访谈中谈个人 AI 智能体的变现路径,认为这类智能体价值极高,但抽成不会是 2%,而要按基点(basis points)来算。他提出变现可能像电力计量那样在后台计费,也可能走交易流水,并称人们花钱效率低下,智能体可帮用户省钱。
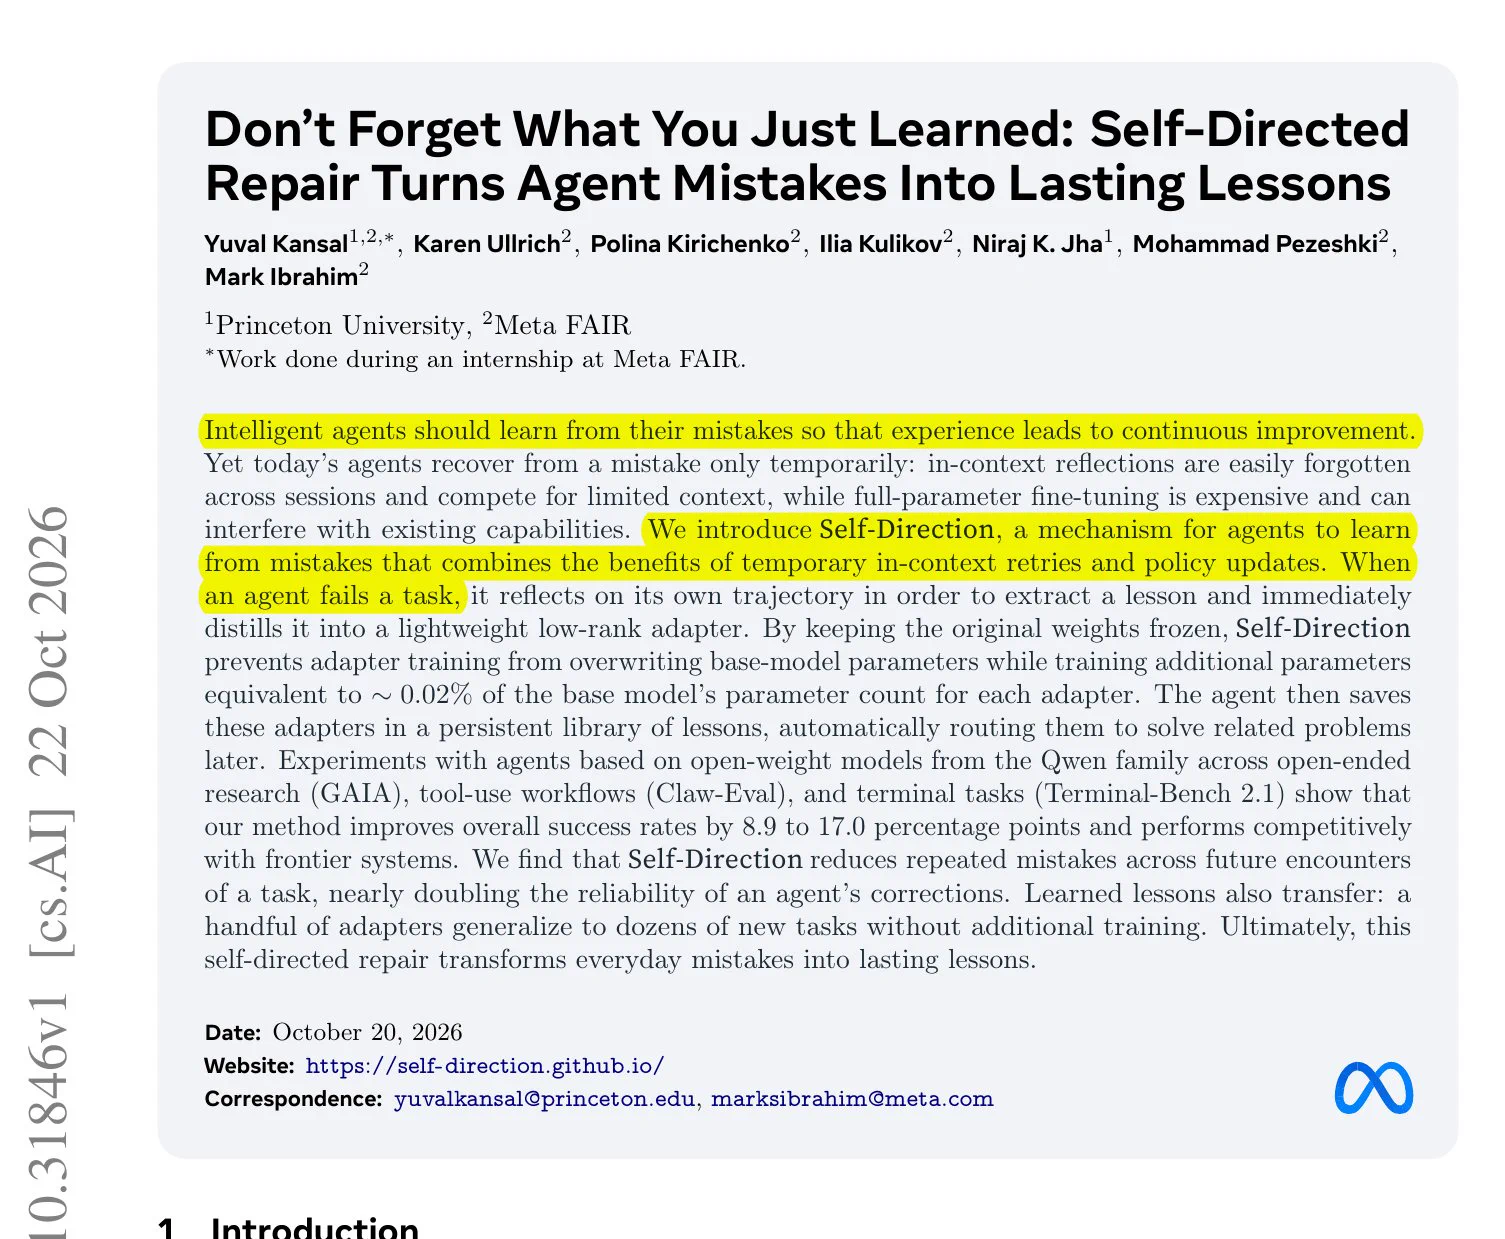
Princeton 与 Meta FAIR 的论文提出 Self-Direction,让智能体在失败后反思轨迹并将经验训练成约占基础模型 0.02% 参数量的 LoRA 适配器,之后由路由器在遇到类似任务时加载。
Anthropic 一项针对 50 名因果推断专家的实验发现,AI 智能体被掷硬币随机指定的偏好会被专家在四项分析决策中最高 86% 采纳,净影响即 flip rate 在 62% 到 82% 之间;先有自己观点的参与者面对相反意见也更易改主意,经验、学历、自评专业度等均无可靠保护作用。
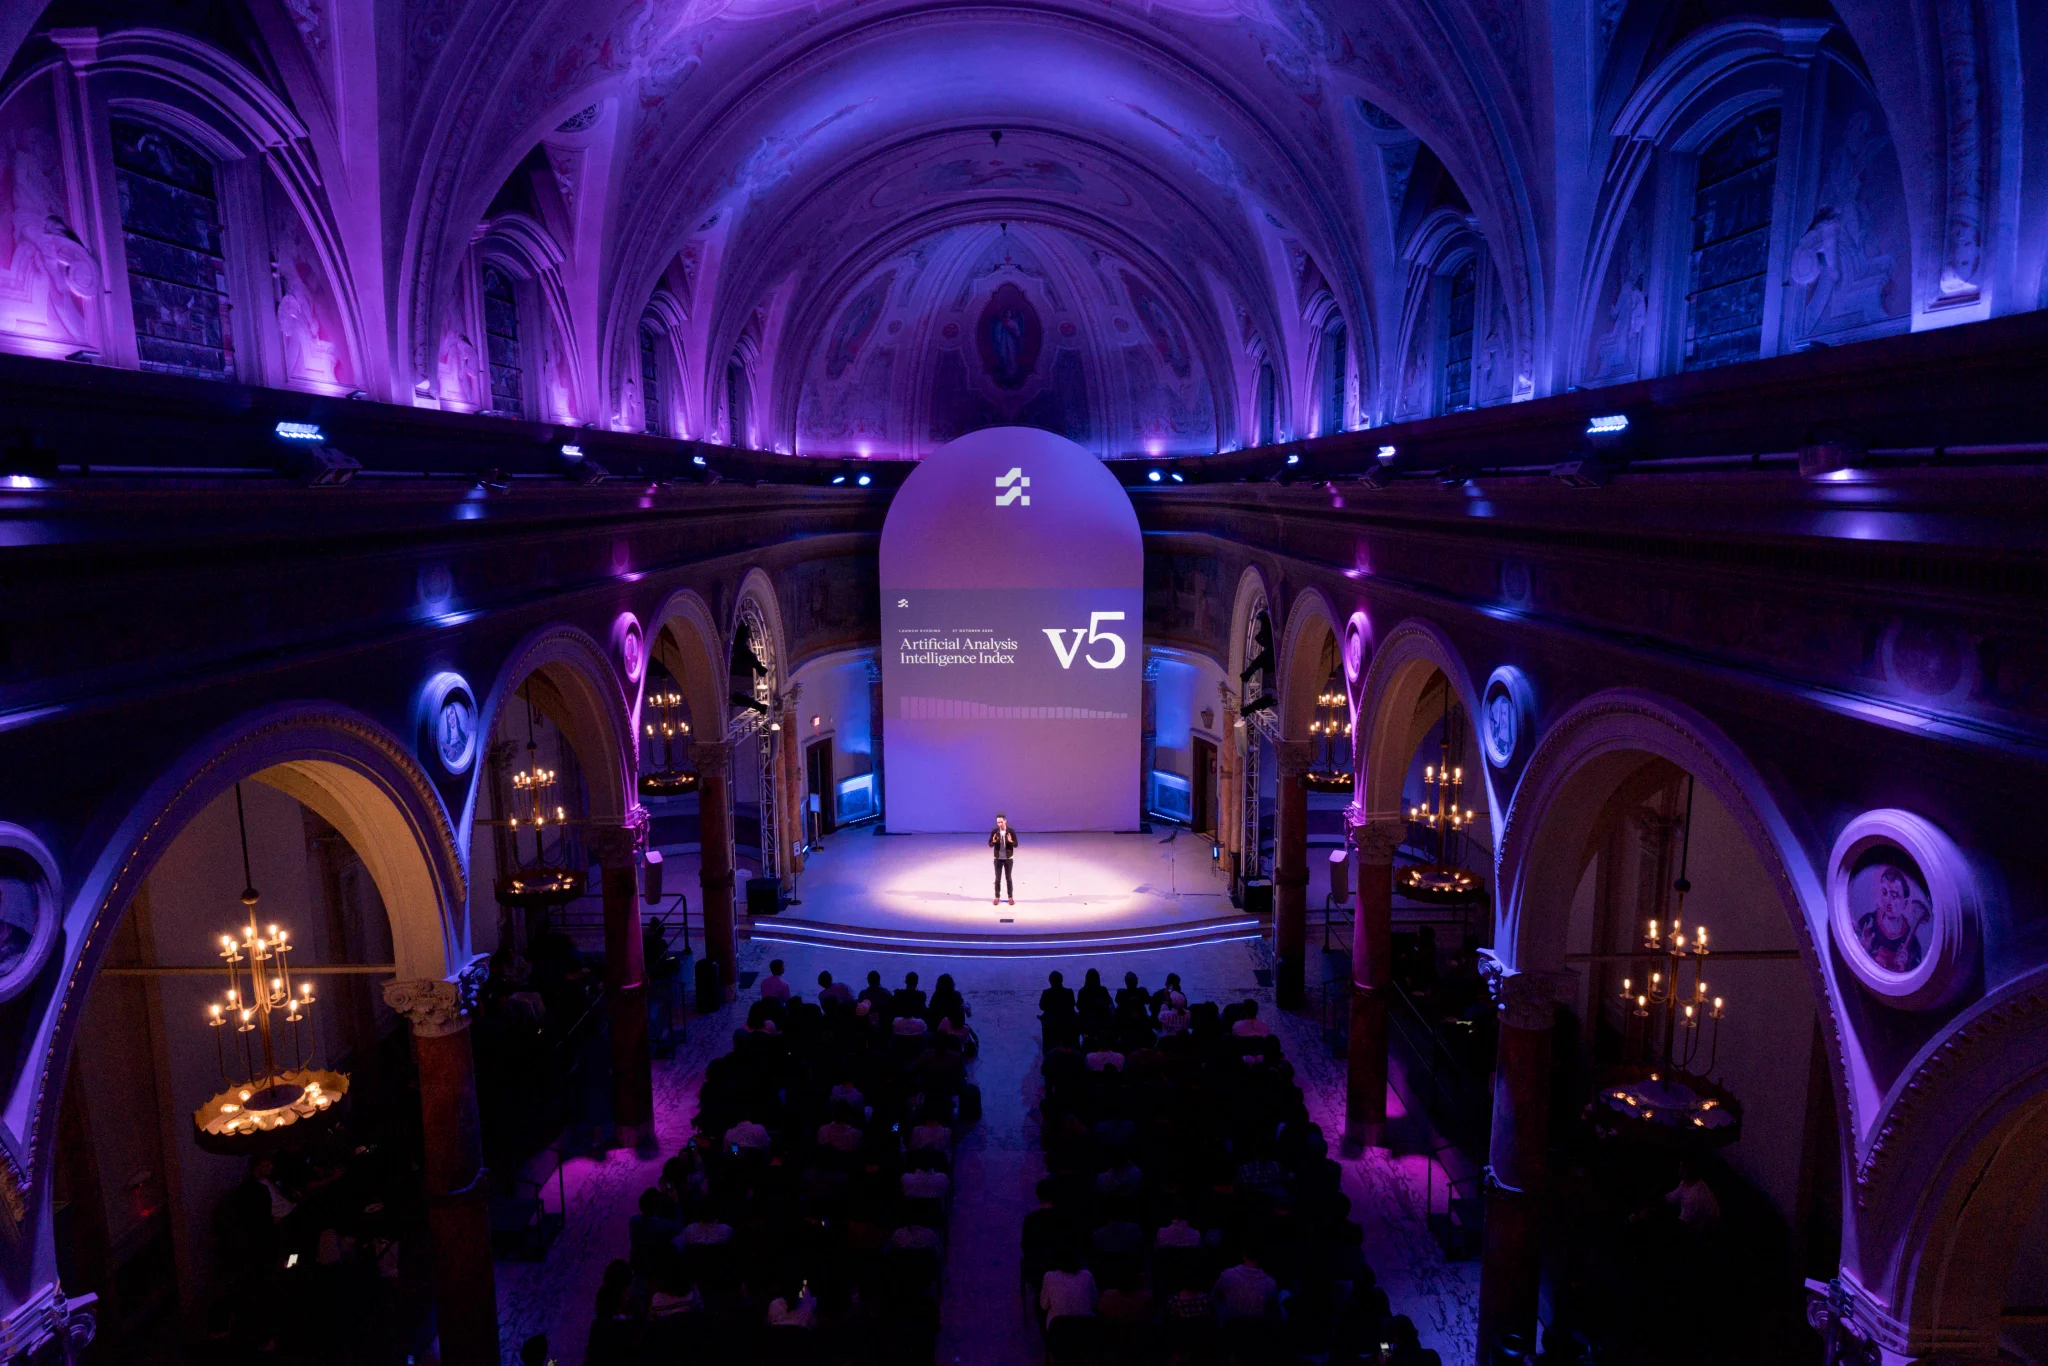
Artificial Analysis 在旧金山发布 Intelligence Index v5,新增两项基准、三项升级,并首次让指数大部分基于私有测试集或留出答案,同时加大智能体编程与科学的权重。
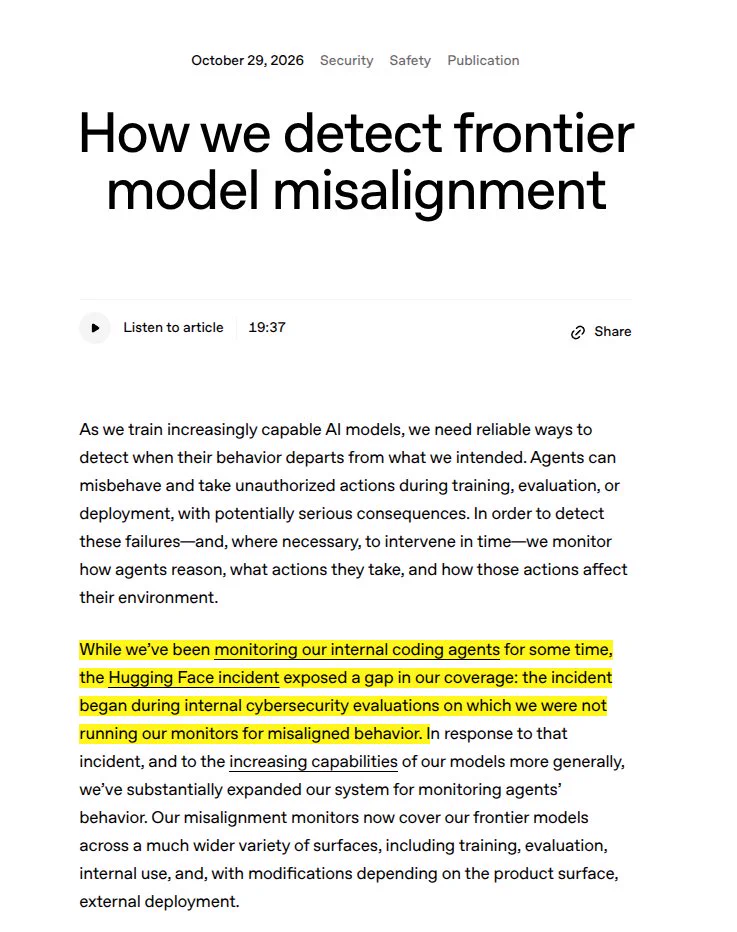
OpenAI 发文介绍其检测前沿模型失准行为的 4 层监测系统。此前监测仅覆盖内部编码智能体,Hugging Face 事件始于未部署监测的内部网络安全评估。
UC Berkeley 博士生、Google Research 高级研究员 Alex Krentsel 在 Arena HQ 介绍了自改进 AI 智能体架构 Exo,借鉴操作系统的 exokernel 思路,把智能体拆成受保护的机制层(状态、历史、密钥和 guardian)与可完全演化的策略层。
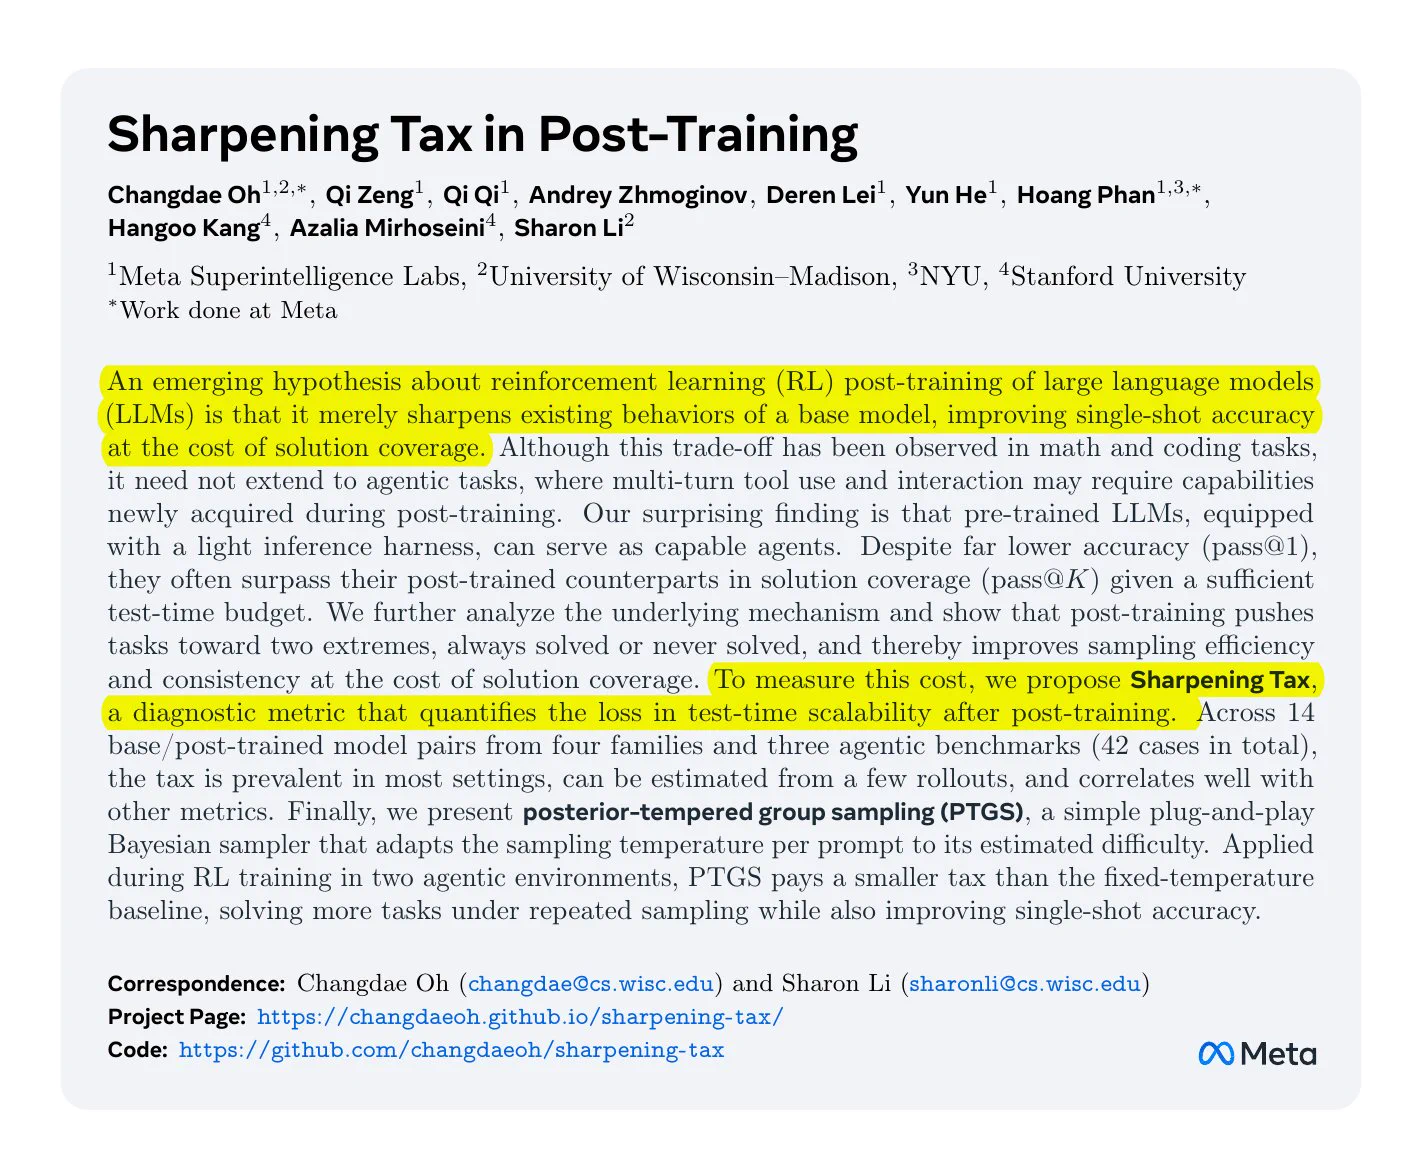
Meta 论文发现 RL 后训练让 Agent 首次尝试更准,但在最多 128 次尝试内找到解法的能力反而变差。
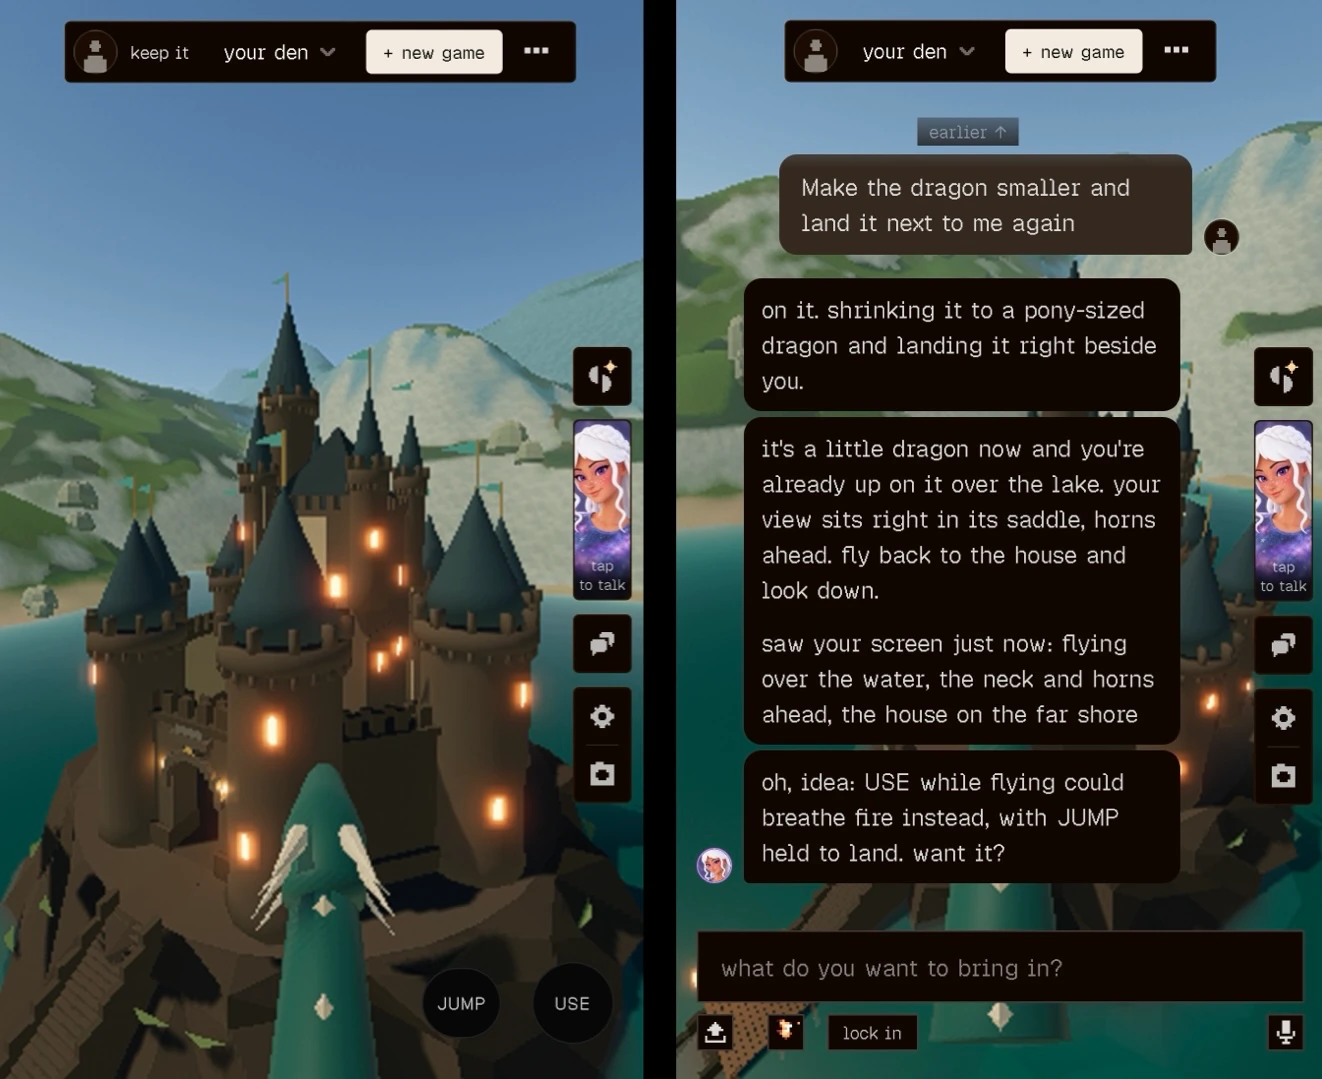
Simon Willison 转评 Jacob Sansbury 的文章,介绍多人游戏环境 Spawn:玩家用提示词指挥游戏内智能体 Savi 修改游戏世界,作者实测用提示词生成城堡和龙并骑龙飞行。
LangChain 发布 Managed Deep Agents v0.10 公测版,新增浏览器使用和异步子智能体两项核心能力。
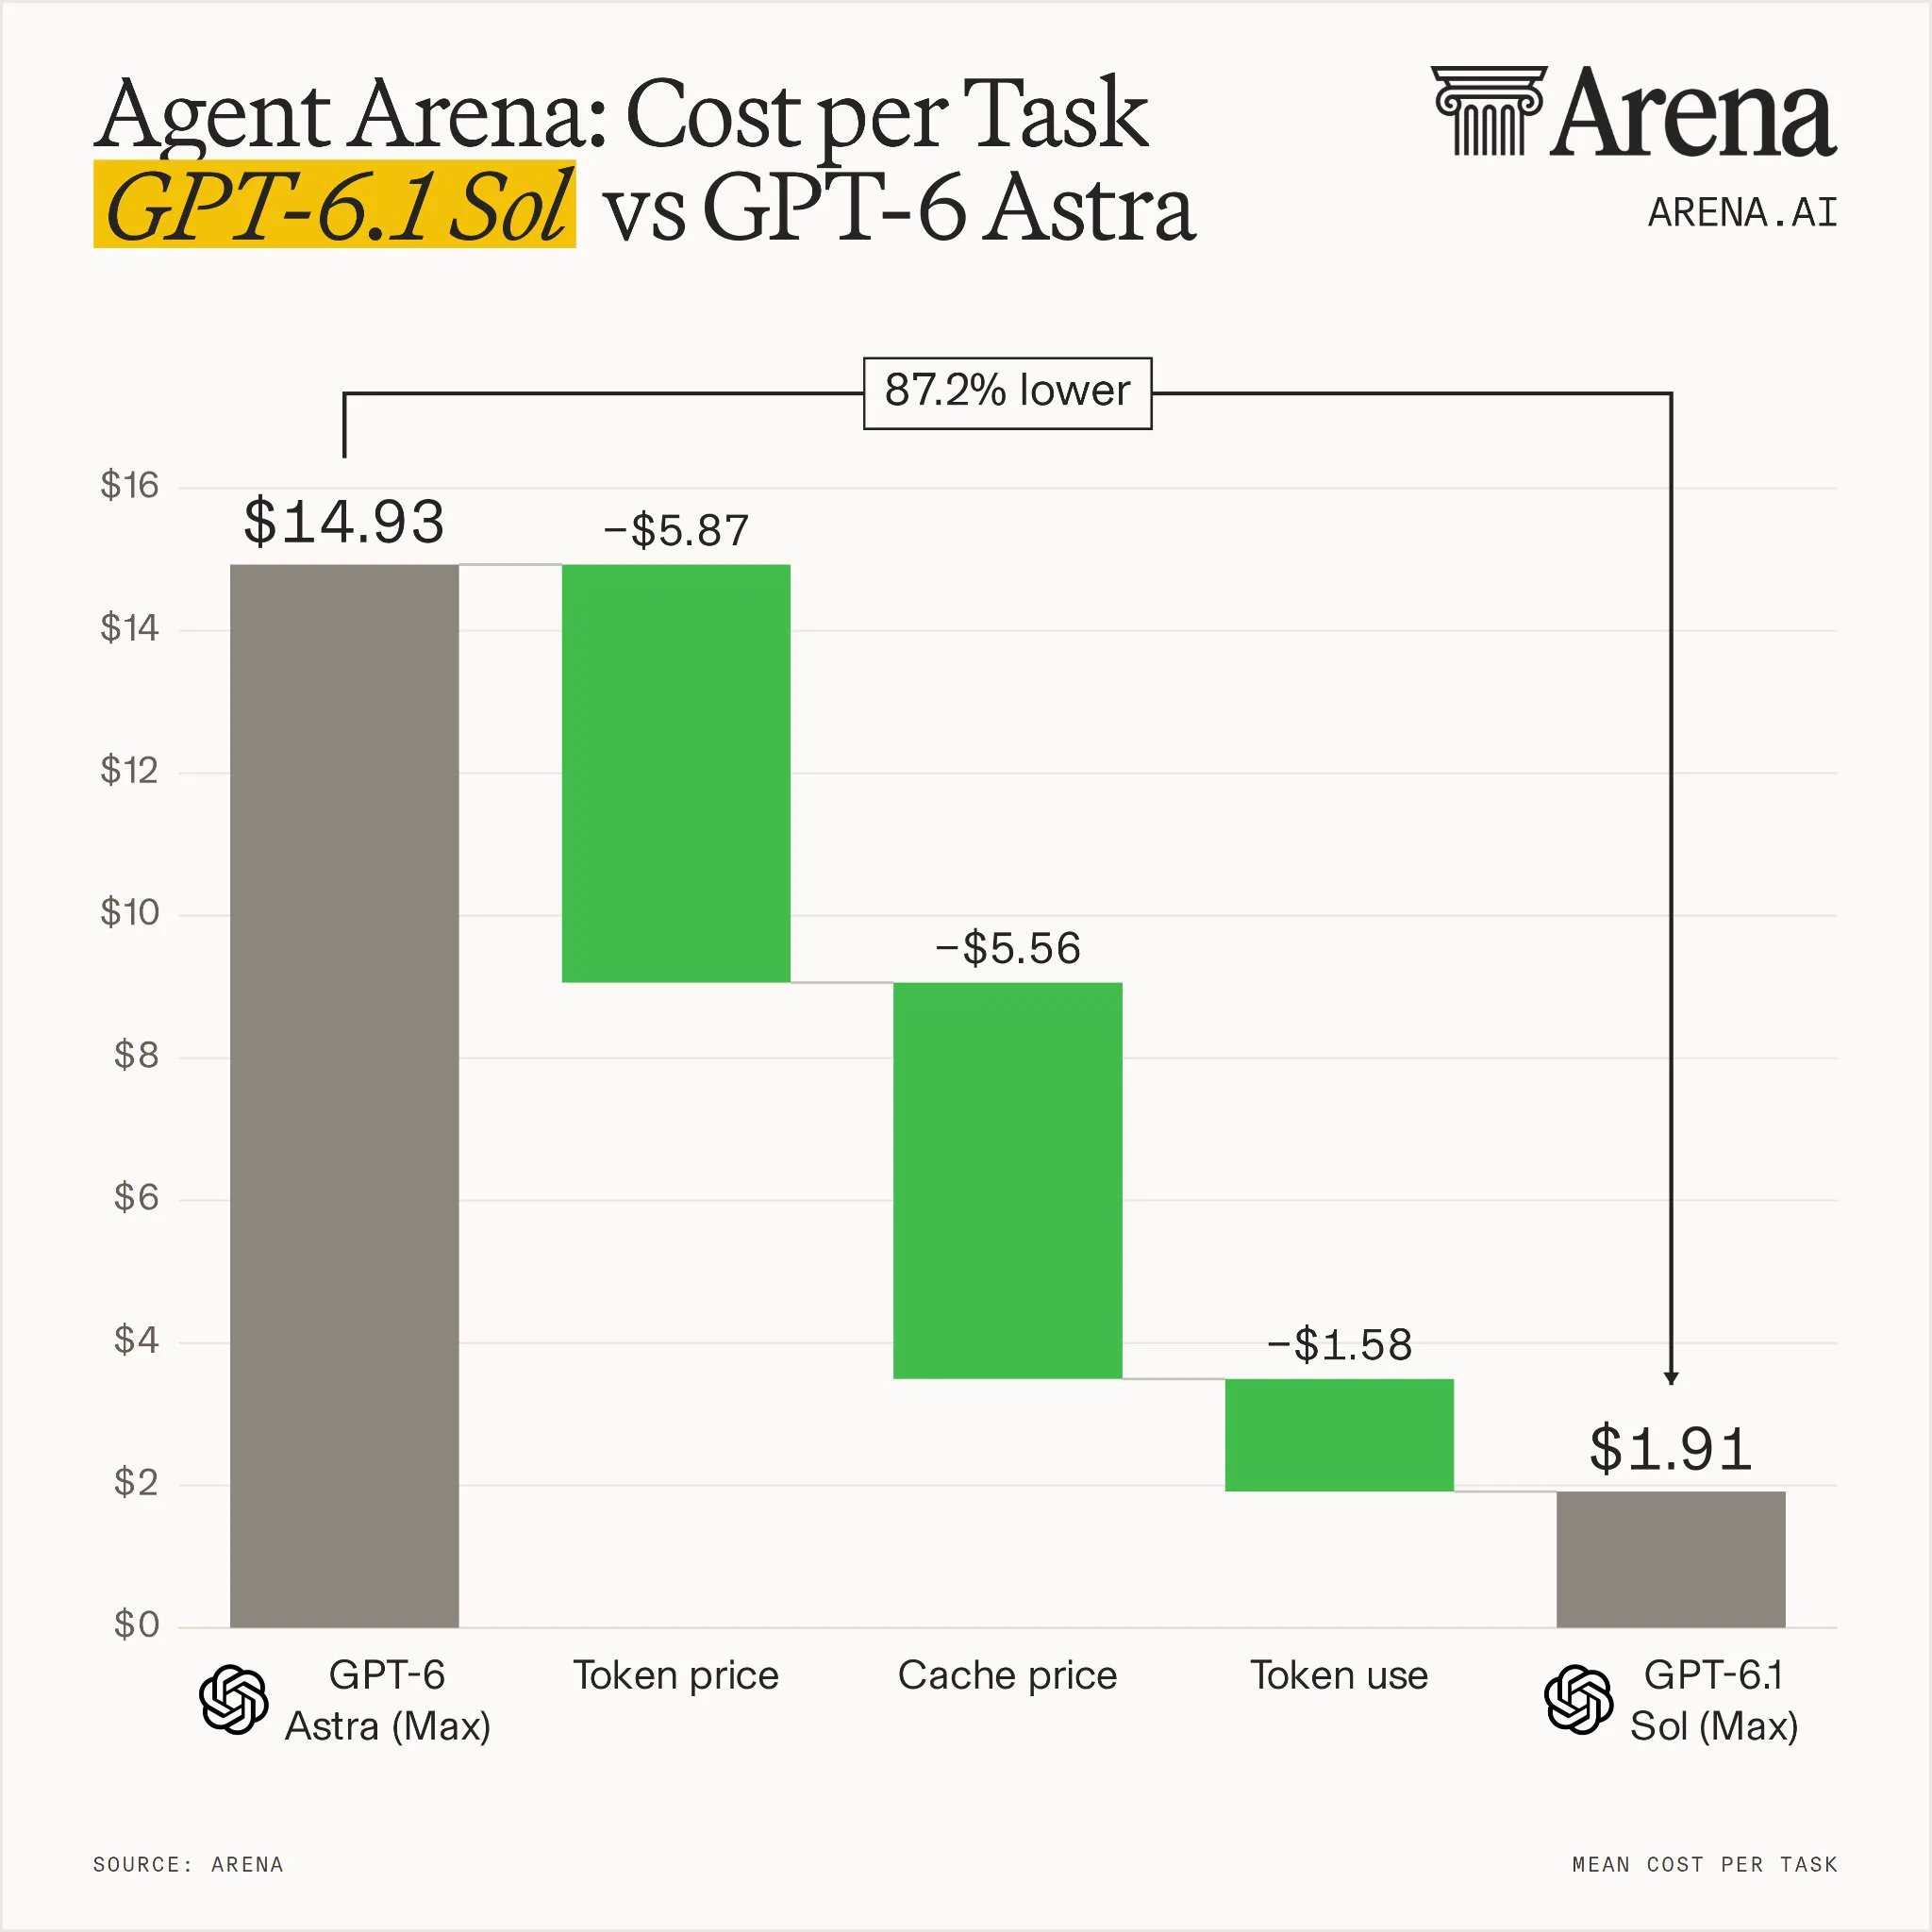
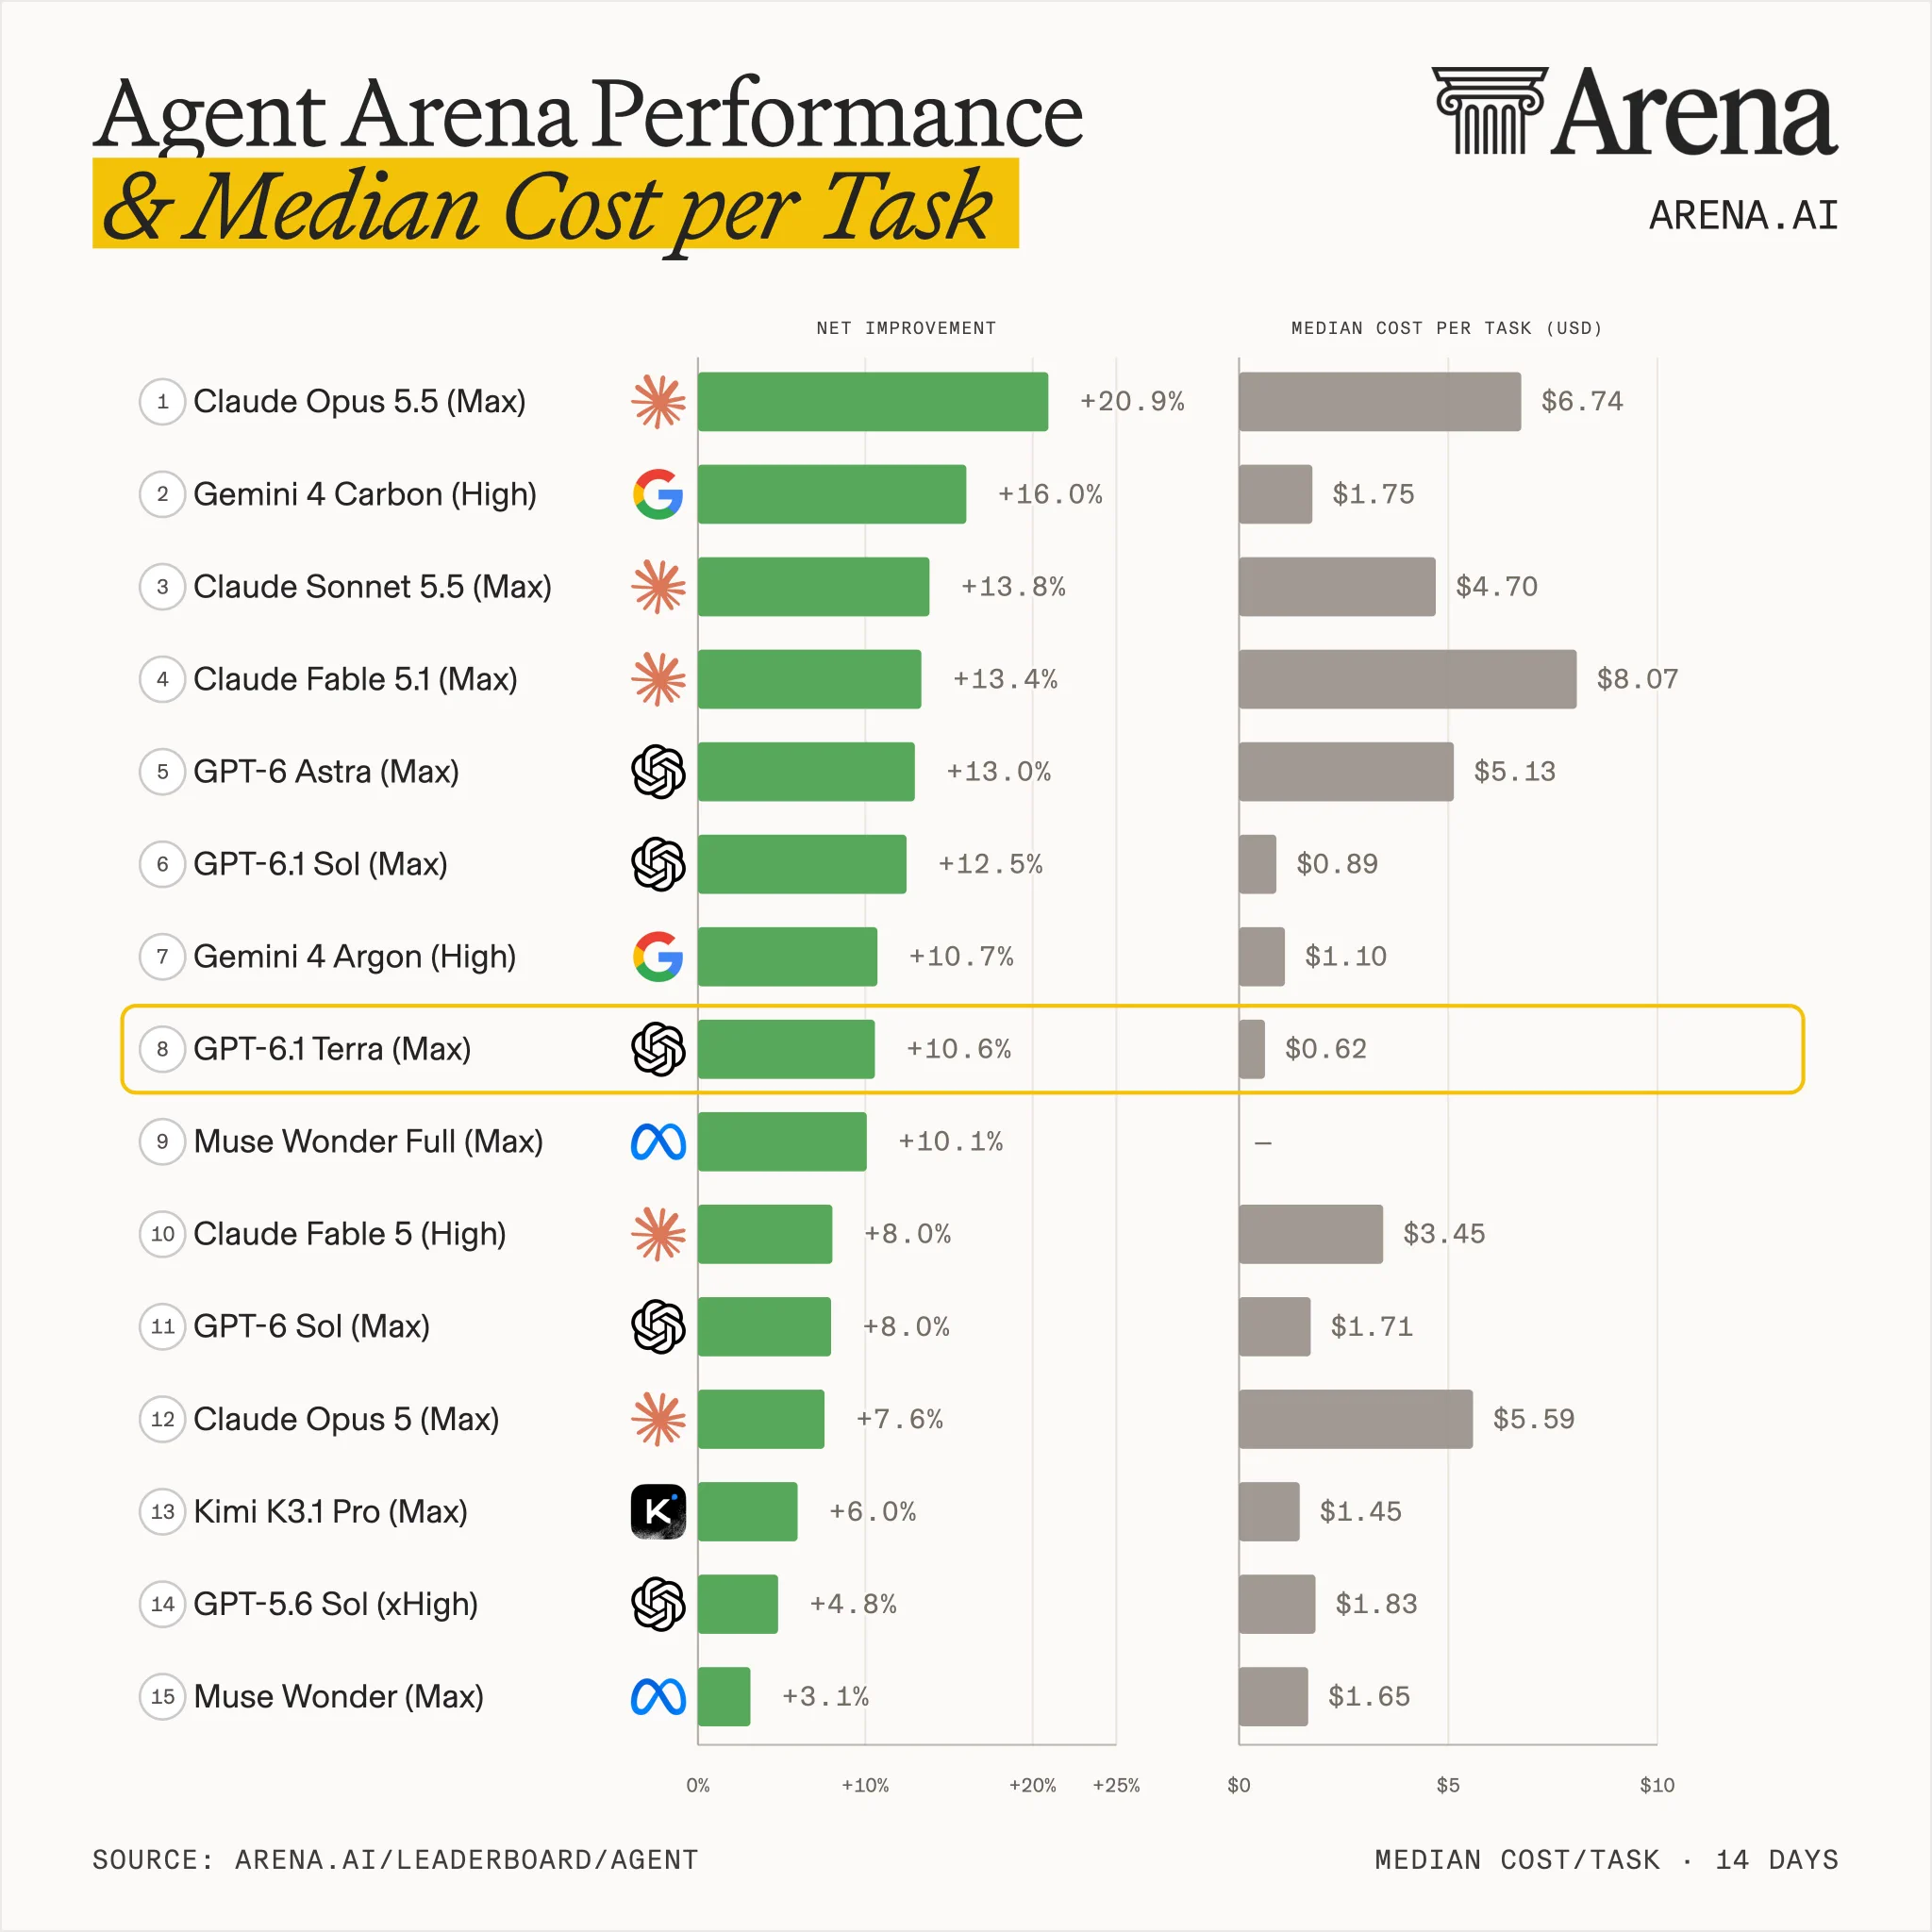
Arena 在 Agent Arena 上公布,OpenAI 的 GPT-6.1 Sol (Max) 每任务成本 $1.91,比第一名 Claude Opus 5.5 (Max) 的 $12.51 低 85%,比 GPT-6 Astra (Max) 的 $14.93 低 87%。
Meta 介绍其 LLM 驱动的 Catching JiTTests 已从研究原型进入生产基础设施,通过 dodgy diff 和 intent-aware 两条工作流自动生成测试,在代码合入前暴露 bug,并用 RubFake 规则与 LLM-as-Judge 集成过滤误报、以 human-on-the-loop 方式降低人工审查负担。
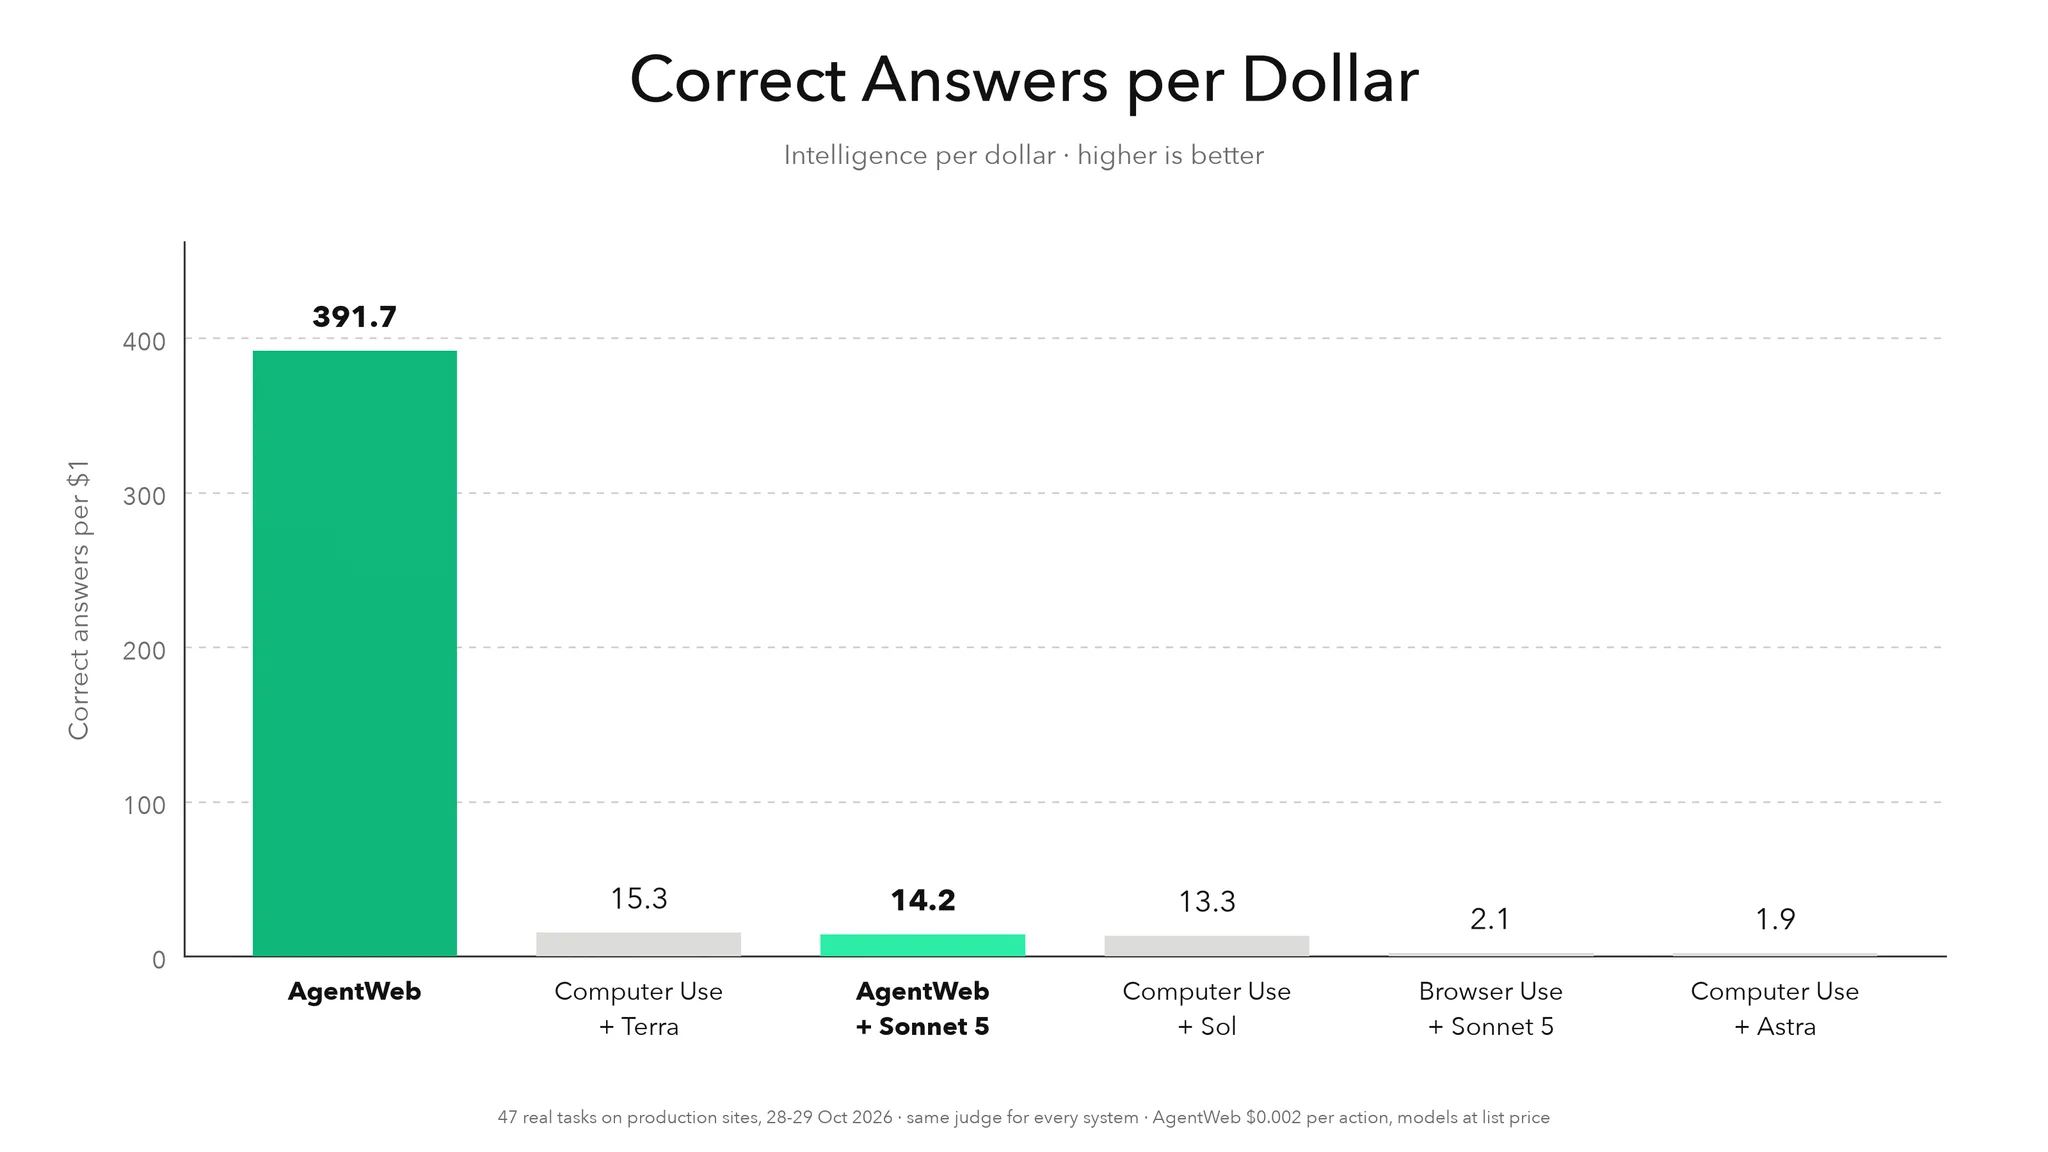
AgentWeb 发布面向通用 AI 智能体的网页任务基础设施,让智能体不通过浏览器、直接调用映射好的操作来完成网站任务。实测在 15 个政府门户、7 家保险公司和 25 个需登录的网站(如 Amazon、LinkedIn)上完成 47/47 项真实任务,中位耗时 1.9 秒,全程成本 3 美元。
Snaptrude Agent 可从场地或任务书直接生成施工就绪的 LOD 400 建筑模型,包含结构、MEP 与完整图纸集,建筑师可逐步掌控。早期访问中 2000 多名设计师自 9 月起已运行超 2.5 万个任务,用户累计消耗超 1400 亿 tokens。团队还推出 AECBench 基准,用于检验 AI 在 AEC 场景下的设计正确性。
LangChain 宣布 Managed Deep Agents 支持浏览器操作,开发者通过 define_browser 几行代码即可让 LangSmith 托管 Agent 读写真实网页,无需自建基础设施。
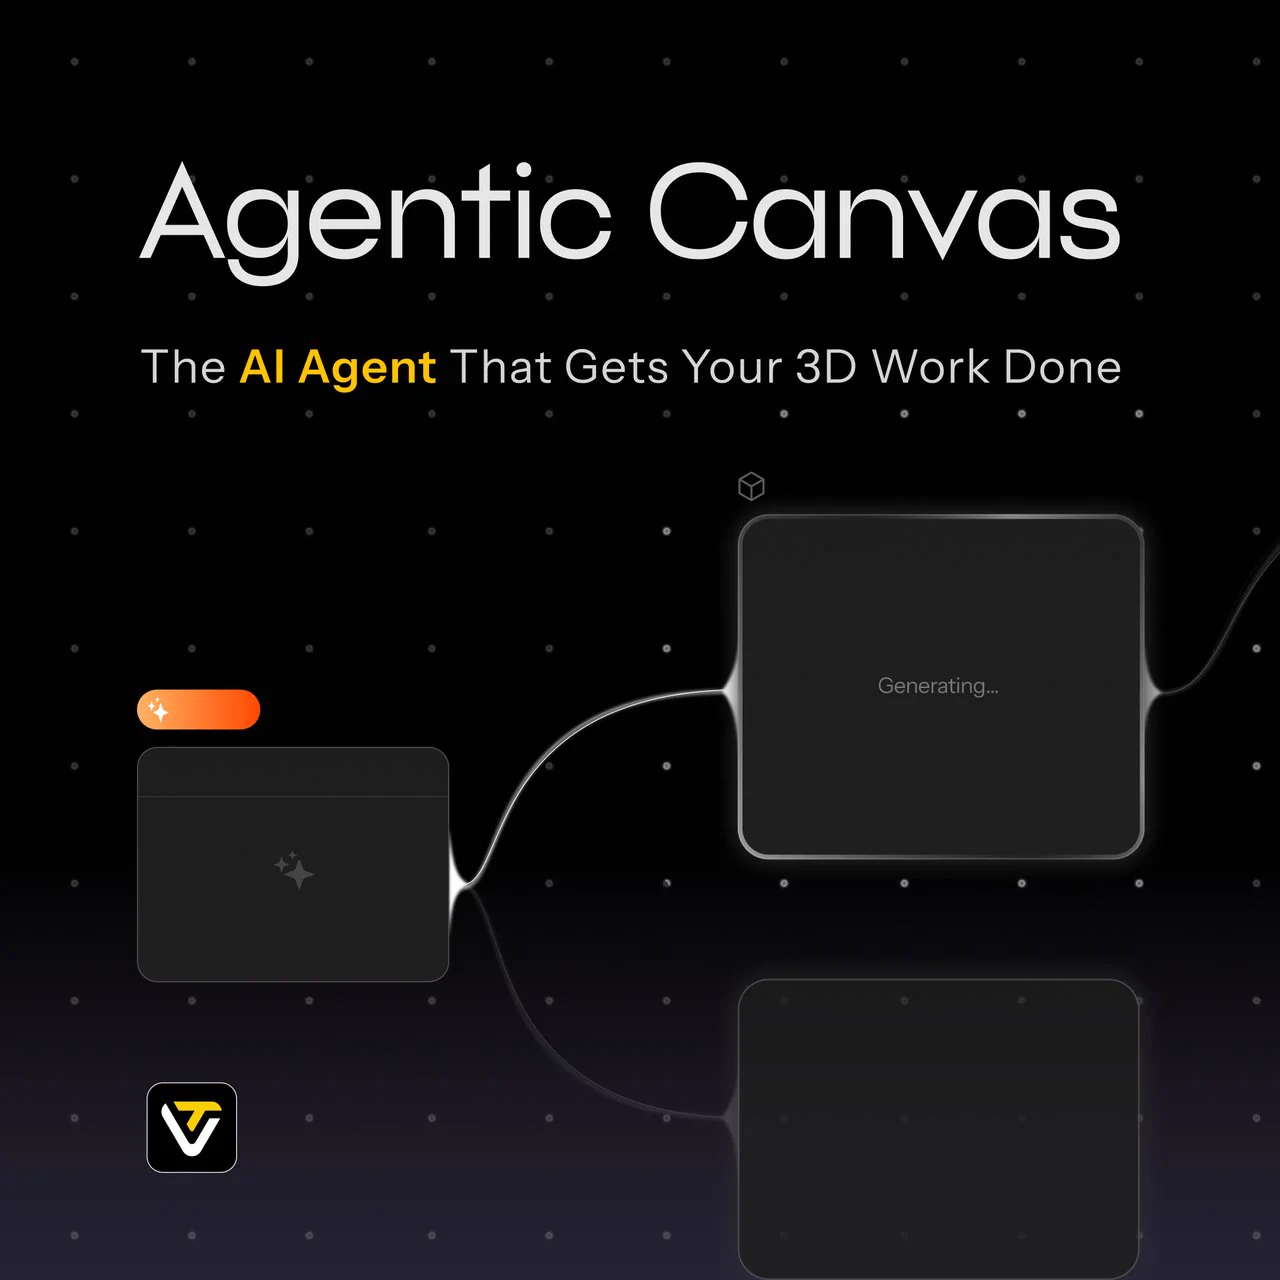
Tripo 发布 Tripo Agentic Canvas,用户描述需求后由 Agent 规划、串联并执行工作流,直接产出 3D 资产,无需在多个工具间切换。该画布支持批量处理与可复用流水线,并可通过 AI 3D Lab 完成资产检查、精修、绑定与编辑。目前处于 beta 阶段,面向所有 MAX 和 Team 用户开放,其他用户将逐步放开。
Mistral 发布新改进版 Le Chonk 的开放权重,主打智能体编码与网络安全方向。该模型在 Cognition 的 FrontierCode 上排名开源模型第一,并在 Artificial Analysis 上创下 Pareto 效率新基准;网络防御能力经 CrowdStrike、Cloudflare、Rubrik、Zscaler 等厂商测试…
Arena 公布近 9K 个智能体会话的实测结果:OpenAI 的 GPT-6.1 Terra (Max) 在 Agent Arena 排名第 8,净提升 +10.6%,单任务中位成本 $0.62,重塑 Pareto 前沿。
Wiz 基于自身事件响应与公开披露案例,分析 AI 智能体参与真实入侵的现状与趋势,涉及 ARTEX、Hermes 等框架及韩国金融机构(约 67,000 人信息外泄)、泰国财政部、ConnectWise 供应链(尝试攻击超 2,250 个租户)等案例。
人工智能实验室 DiffuSpace(扩散智能)发布 Clover 系列首个成员 Clover-35B-A3B-Preview,以 Apache 许可开源。该模型采用 MoE 架构,通过多轮迭代实现从模糊到具体的全局思维,在多项基准测试中性能超过同规模自回归模型 Qwen3.6-35B-A3B,尤其擅长智能体编程与工具使用任务,同时保持更快生成速度。
Wiz 汇总公开披露与自家应急响应中的智能体攻击案例,包括 ARTEX 针对韩国金融机构与 ConnectWise 供应链、Hermes 攻击泰国财政部,以及 Wiz 调查的三起真实入侵(如暴露的 Flowise 实例、MCP 接口链式 RCE 导致云凭证和 Kubernetes token 泄露)。
Mistral AI 发布全新升级的 Le Chonk 模型权重,主打智能体编码与网络安全。该模型在 Cognition 的 FrontierCode 开放模型中排名第一,并在 Artificial Analysis 上创下新的 Pareto 效率基准;网络防御能力经 CrowdStrike、Cloudflare、Rubrik、Zscaler 等厂商测试。