2026-10-24
Micron 在最新报告中公布至 2030 年的内存与存储芯片路线图
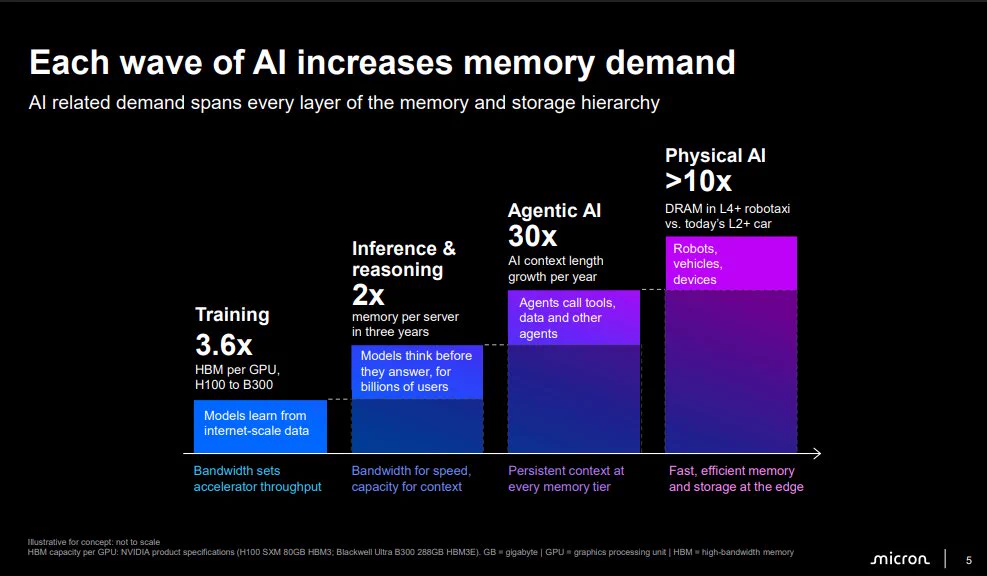
Micron 在最新报告中公布其计划到 2030 年推向市场的内存与存储芯片路线图。报告称单栈 HBM4 带宽达 2.8 TB/s,约 13 块顶级 AI GPU(每块 8 栈)的总内存带宽即可匹敌全球国际互联网约 282 TB/s 的容量;Nvidia GPU 单卡内存从 H100 的 80GB 增至 B300 的 288GB…
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
Micron 在最新报告中公布其计划到 2030 年推向市场的内存与存储芯片路线图。报告称单栈 HBM4 带宽达 2.8 TB/s,约 13 块顶级 AI GPU(每块 8 栈)的总内存带宽即可匹敌全球国际互联网约 282 TB/s 的容量;Nvidia GPU 单卡内存从 H100 的 80GB 增至 B300 的 288GB…
可灵官方转发 fal 消息,Kling 4.0 现已在 fal 公开上线,API 面向所有客户开放。模型支持最长 30 秒带音频的原生视频生成、最多 15 个图像/视频/元素参考、最多 10 个关键帧的精确控制,并改进了运动、角色一致性和电影化叙事。
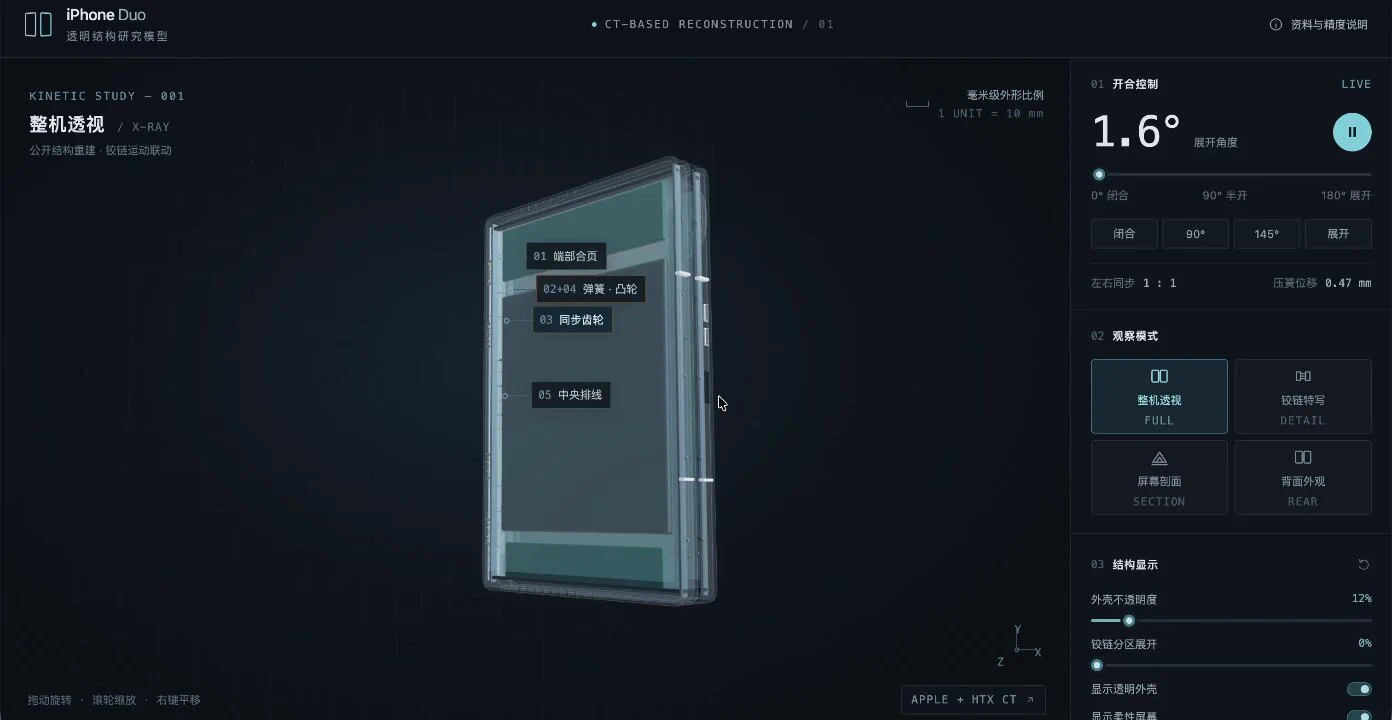
为 iPhone Duo 的铰链完成了一个 3D 建模,AI 参考了何同学的视频。作者评价这次 Duo 视频评测的信息量排序为何同学>李大锤>Tim,但 Tim 的特效最好、播放量最高。
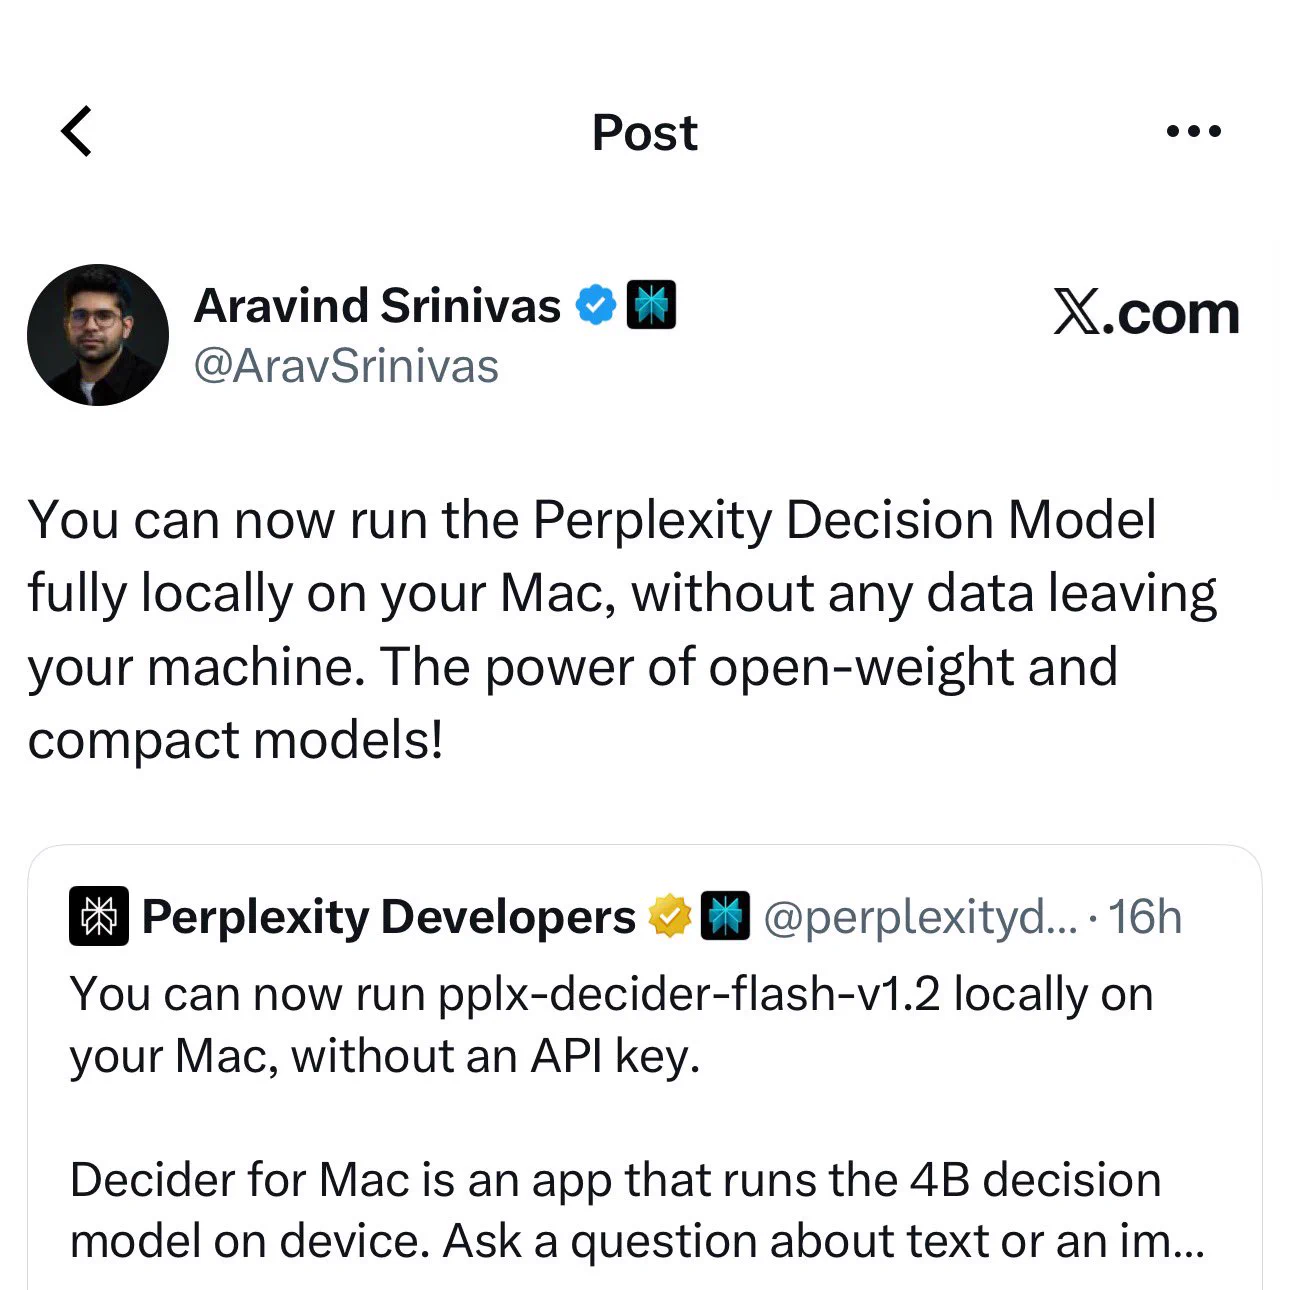
补充一下 👀:Perplexity 发布了 pplx-decider-flash-v1.2 决策模型,以 Mac 应用形式在本地提供决策 API。 该模型占用 5.8 GB 空间,需要 16 GB 内存。 100% 真实 🤖
月之暗面正式推出 Kimi K3.1 Pro,为 K3.1 系列首个模型,3 万亿级参数、支持 100 万上下文,并同步推出输出速度约 2~3 倍的 Kimi K3.1 Pro Highspeed。
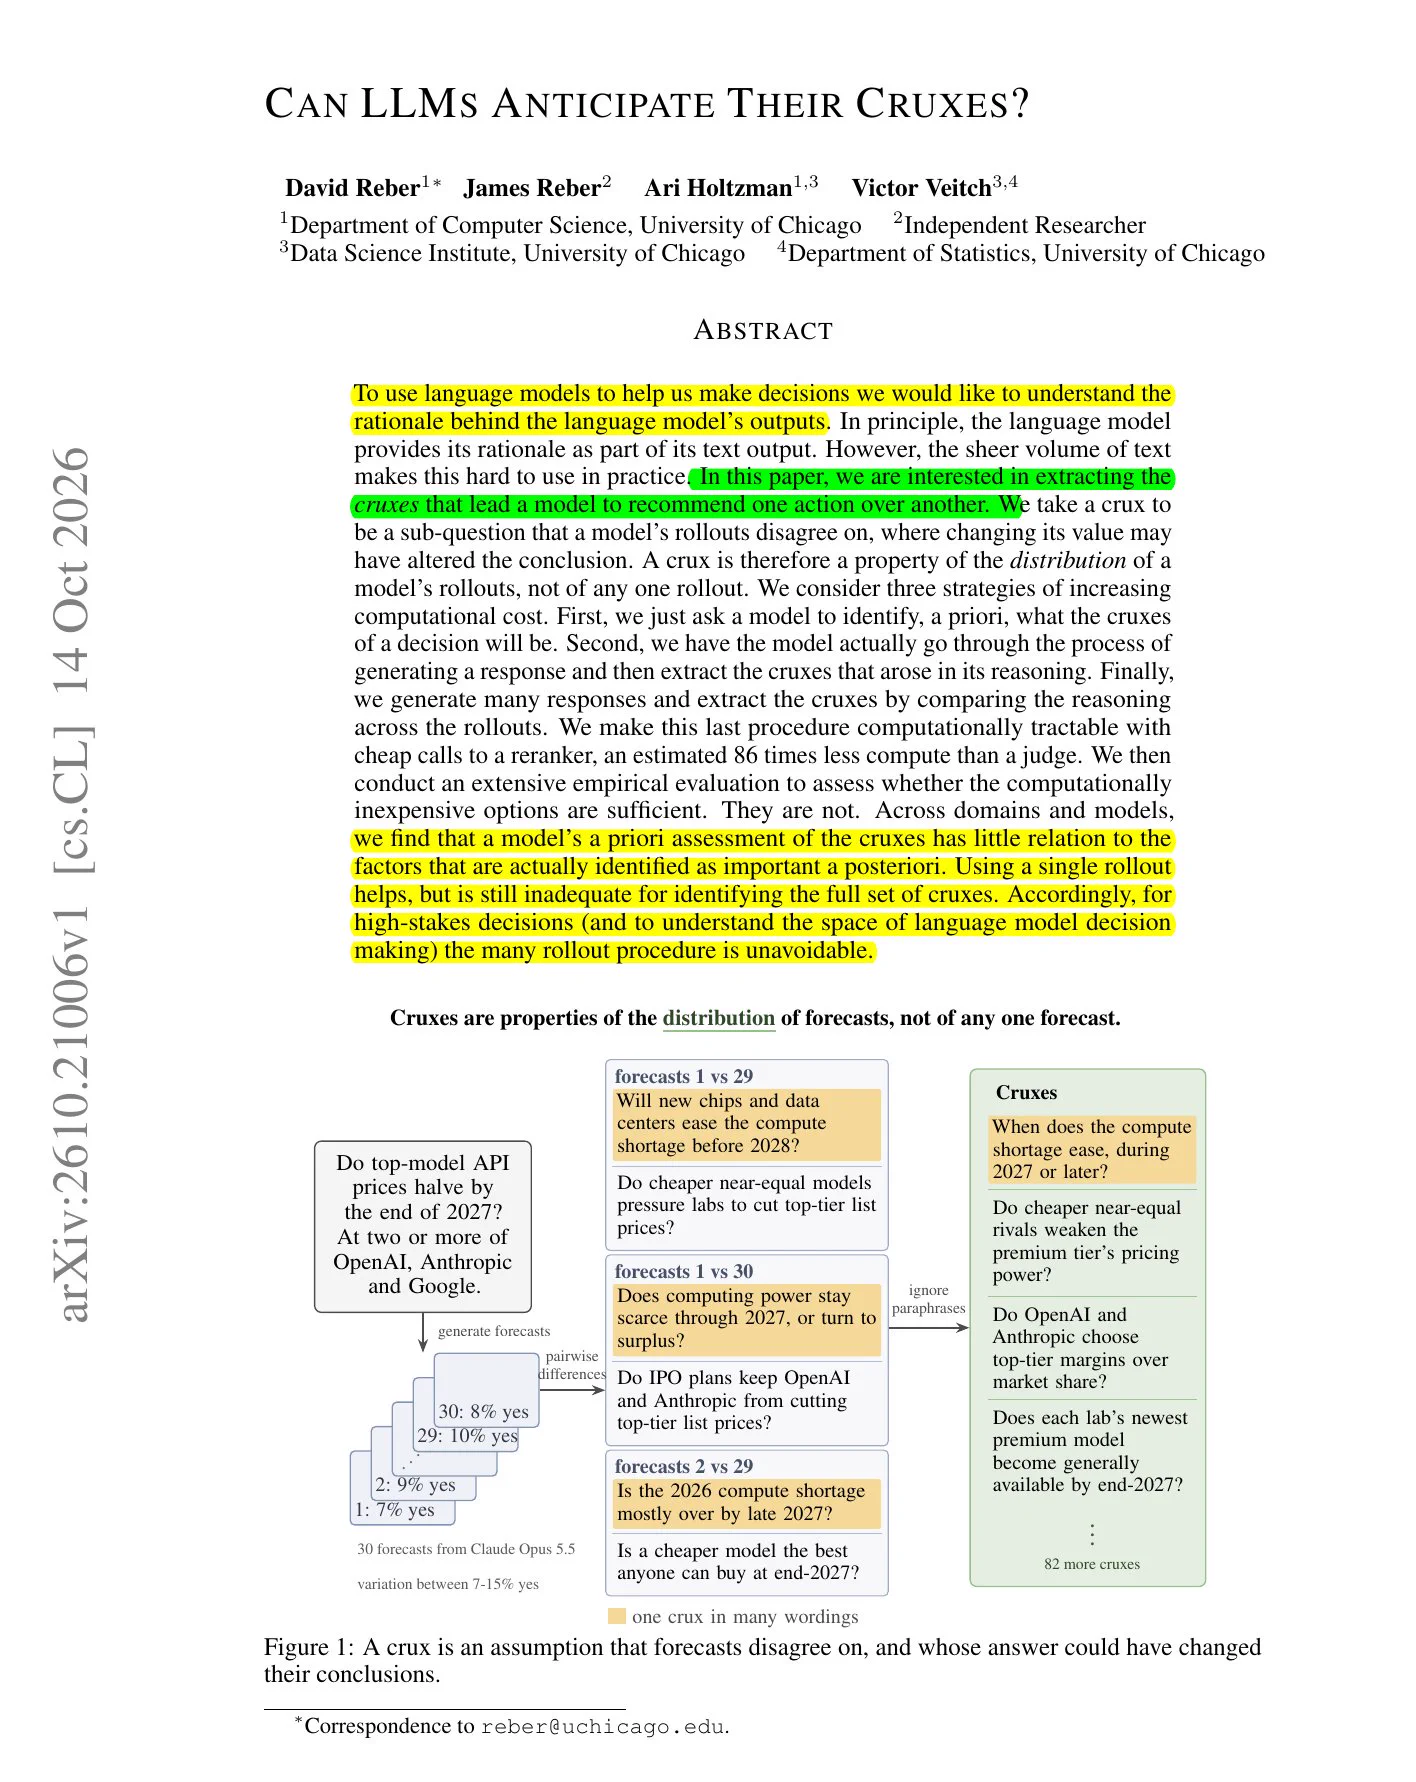
芝加哥大学新论文发现,LLM 对自己决策关键因素的自我说明与实际影响其答案的变量并不一致,模型无法预测自身答案分歧所在的关键问题。研究让模型多次预测 59 场 March Madness 比赛和 15 个 Metaculus 事件,再用 reranker 比对预测对以找出争议事实,成本约为本地 LLM 评判的 1/86。
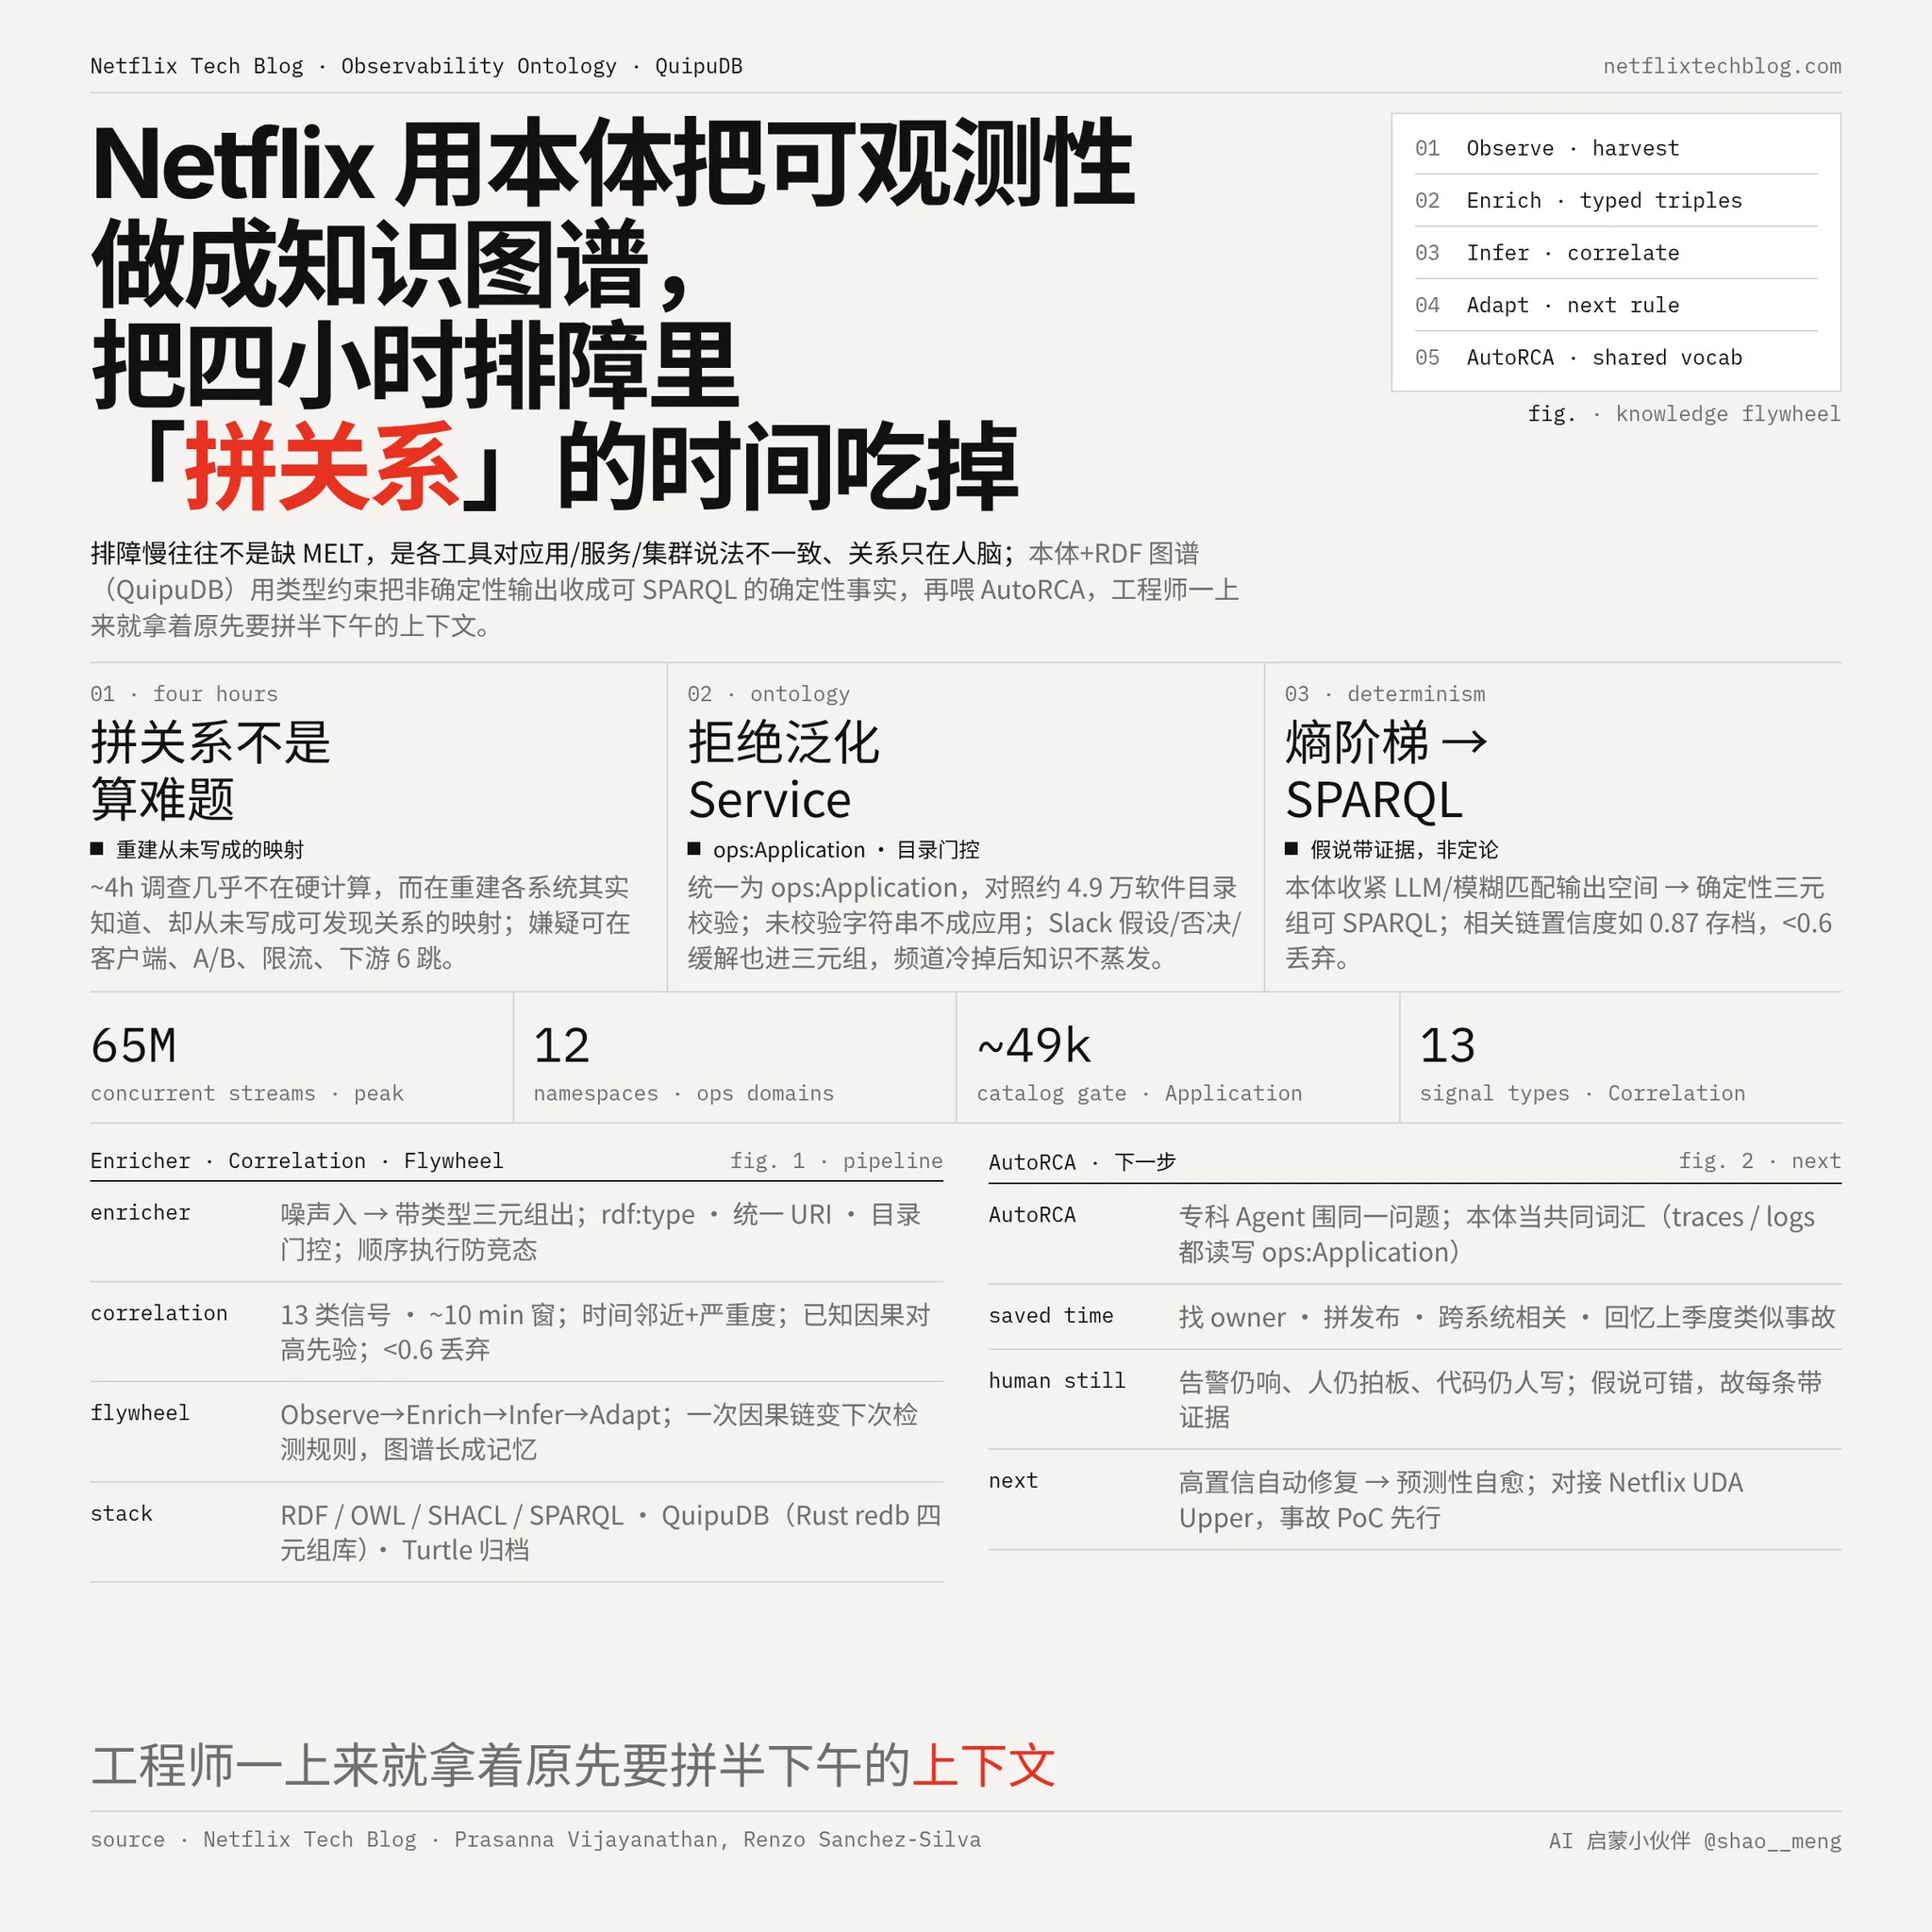
Netflix 技术博客介绍其 Observability Ontology 与 RDF 知识图谱 QuipuDB,用类型约束把 LLM 摘要等非确定性输出收成可 SPARQL 查询的确定性三元组,再喂给 AutoRCA 供多个专科 Agent 共用词汇。
山东大学研究者让五个模型在 Claude Code、OpenCode 和 mini-SWE-agent 三个 harness 下跑 SWE-bench Verified 任务,发现换 harness 的结果波动与重复运行同一配置相当,成本却最多可达三倍。
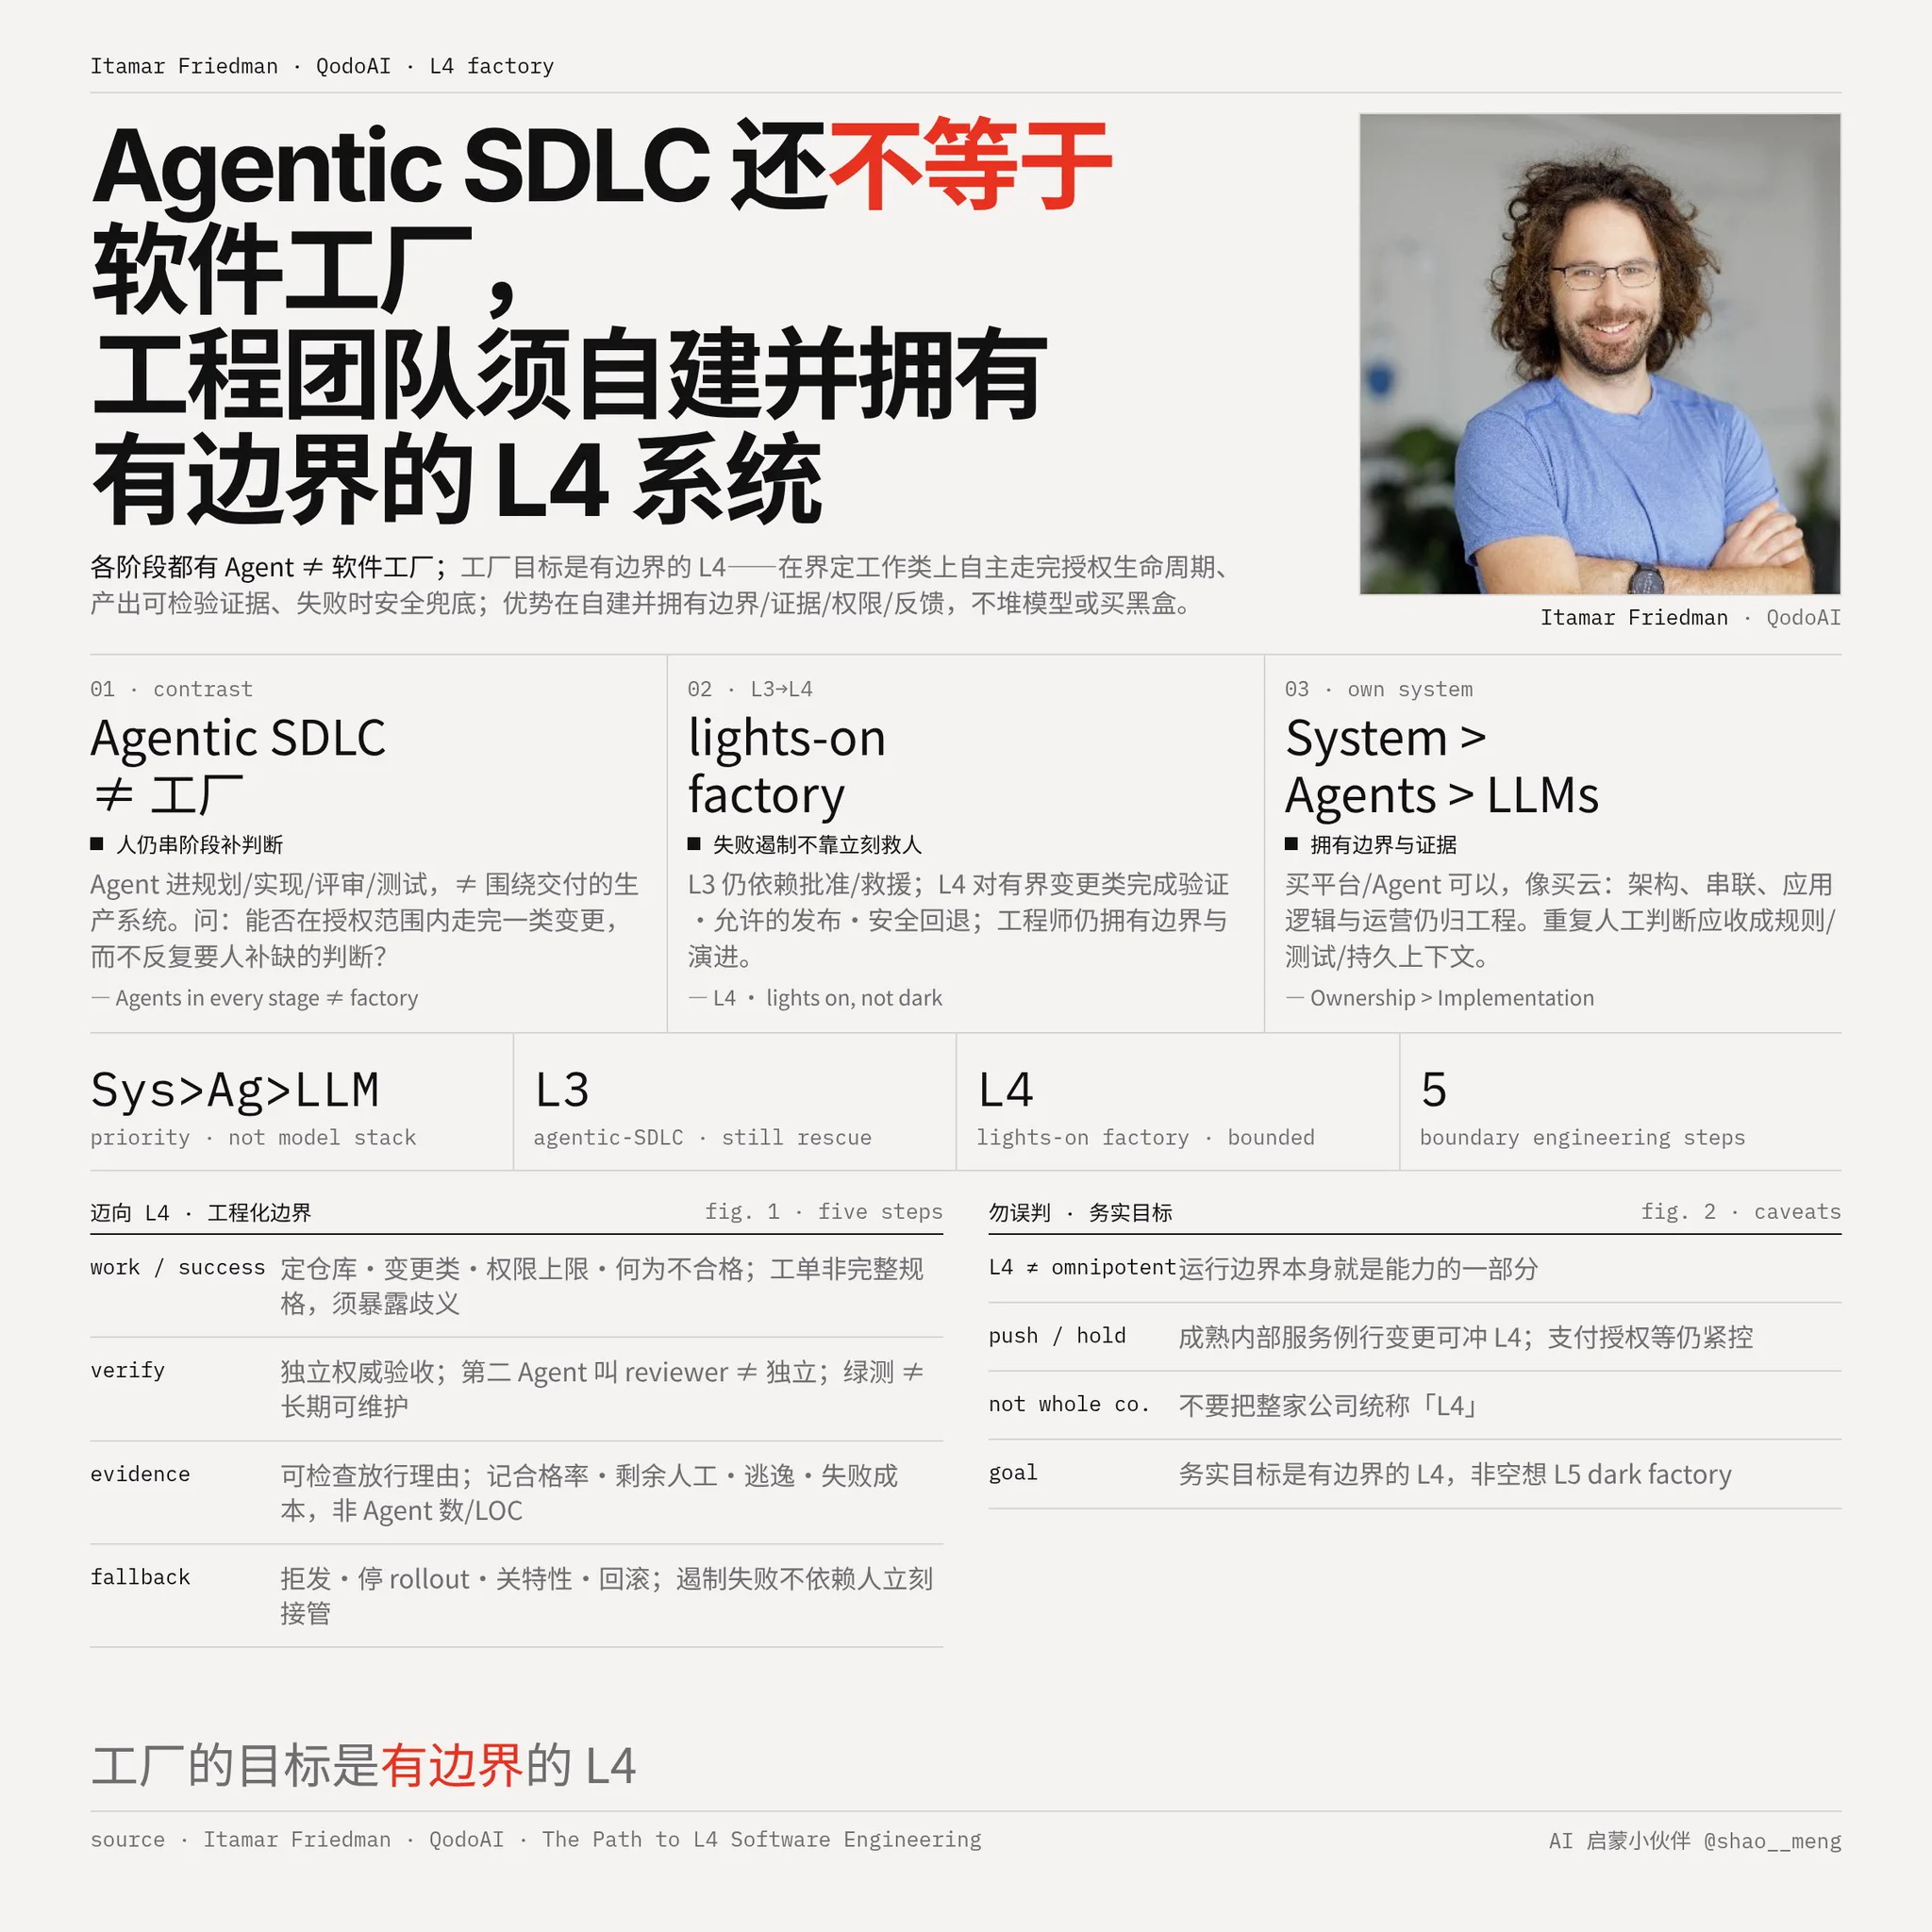
QodoAI 创始人 Itamar Friedman 提出,各阶段都有 Agent 的 Agentic SDLC 还不等于软件工厂,目标应是对界定工作类能自主走完授权生命周期、产出可检验证据并安全兜底的有边界 L4 系统。
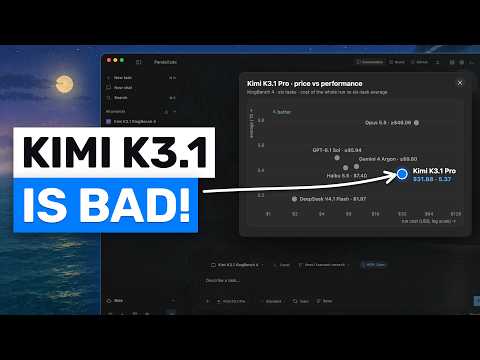
Kimi K3.1 Pro 的六项编程测试展示了诚实的部分实现和一些扎实的协议功能,但功能缺失与大量缓存读取费用削弱了性价比。
马东锡 NLP 发布后训练文章系列第三篇,主题为 LoRA 和 QLoRA。文章围绕 rank 秩、low-rank approximation 低秩近似、quantization 量化三个基本概念展开,并用矩阵中的 pattern 模式这一概念将三者串联起来。
MiniMax x Chroma Awards 正式启动! 我们很高兴与 @chromaawards 合作推出第二季! 💰 探索超 100 万美元的推广资源,角逐超 45 万美元现金奖池。 💰 在投稿中 @MiniMax 并在社交媒体发布内容带上 #MiniMaxH3,即可额外赢得我们提供的 2250 美元现金奖。
作者以模式(列向量乘行向量)为核心概念,讲解低秩近似、LoRA 与 4 位量化的原理:LoRA 冻结原有权重只训练新增的 r 个模式,量化用 NF4 分块缩放压缩存储。
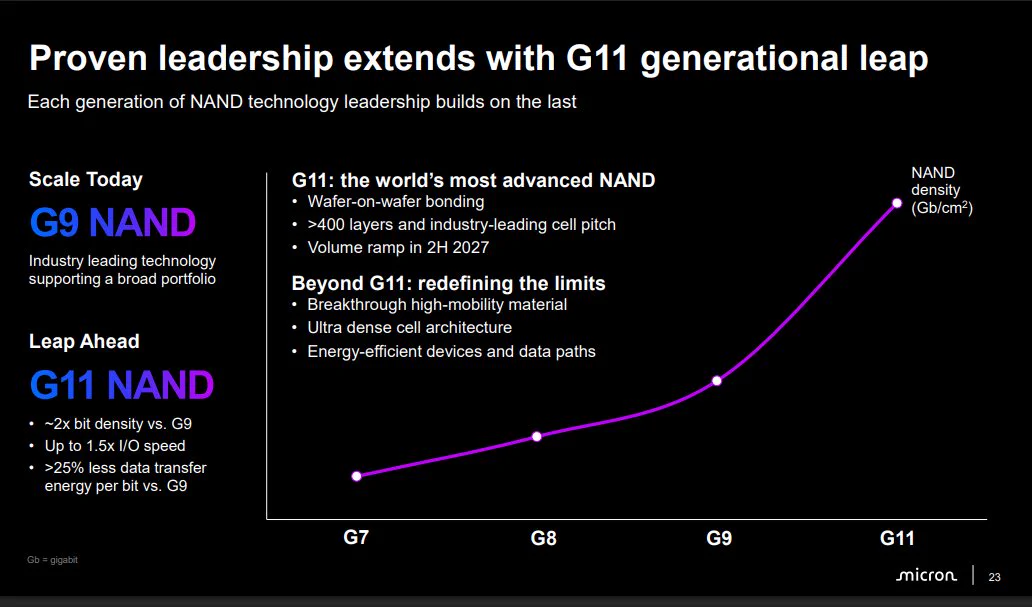
美光下一代存储芯片 G11 在相同硅片上可容纳约两倍于当前 G9 的数据,堆叠层数从 276 层提升至 400 层以上,传输速度最高提升 1.5 倍,每 bit 搬运能耗降低超 25%。该芯片面向 AI 数据中心大量采购的大容量 SSD,预计 2027 年下半年量产,搭载 G11 的硬盘会更晚上市,美光未透露每 GB 成本降幅。
Rohan Paul 引用 NYU 教授 Aswath Damodaran 的观点:AI 若只是工具市场规模会小得多,$10-$15T 的最佳情形只有在 AI 替代人时才会实现。他认为这一叙事意味着约一半白领可能失业,并质疑届时谁来提供购买产品和服务的收入,以及社会如何应对失去收入与生活意义的问题。
腾讯 WorkBuddy 宣布接入 Kimi-K3.1-Pro,并同步接入输出速度约 2-3 倍的 Kimi K3.1 Pro Highspeed,现阶段仅对“企业旗舰版”及“个人订阅用户”优先开放。
月之暗面发布 Kimi K3.1 Pro,2.8T 参数 MoE 模型(104B 激活)、1M 上下文,已在 Kimi 网页、移动端和 API 上线,开放权重定于 11 月 4 日。
TorrentFreak 调查发现,发表在 New Review of Academic Librarianship 的一篇 Z-Library 论文中,44 条参考文献里至少 10 条无法找到,包括一篇标题不存在的 TorrentFreak 文章和被署名给 Daniel Gervais、Carol Tenopir 等人但查无此文的论文。
本文指出,个人 AI 代理(Personal agent)在推广至中国县城时面临一个根本性问题:由于县城居民的收入水平和生活成本较低,他们能够从 AI 节省的时间中获得的经济价值不足以覆盖使用 AI 的成本,导致订阅模式难以成立。
Codex 开发者的体验更新: 现在可以在对话中途切换推理等级,而且不会丢失缓存!简单任务用低推理,需要时再调高,无需重建上下文。 还有一些不错的 CLI 更新: - 可复用的提示词预设 - 内联切换模型和权限 - 修复长会话恢复问题 - 企业版 MCP 登录和 Windows 代理认证 另外,dot 调用现在的连接速度也快多了 ;)
Moonshot AI 发布 Kimi 3.1 Pro,这是一款 2.8T 参数、104B 激活参数的模型,性能达到 Fable-5.1 级别,并承诺于 2026 年 11 月 4 日前开放权重。该模型展现出强大的智能体能力并降低了幻觉,提供标准版和高速版 API 选项。
Moonshot 发布 Kimi K3.1 Pro,为 K3 的大规模后训练版本,2.8T 总参数、104B 激活的多模态 MoE 模型,上下文窗口 1M token,API 已上线,权重承诺 2026 年 11 月 4 日开放,Highspeed 版输出速度快 2-3 倍、价格为标准版两倍。
邵猛发问:最近几个以 Pro 结尾的模型是否都不太达预期,点名 DeepSeek V4 Pro、Kimi K3.1 Pro,以及“胎死腹中”的 Gemini 3.5 Pro。他由此提出,做 Flash 模型对大多数 AI 团队才是正路。
腾讯 WorkBuddy 宣布接入 Kimi K3.1 Pro,一个拥有 3 万亿参数、支持 100 万上下文的 AI 模型,其在代码、3D 创作和金融研究等领域的性能已接近最强闭源模型水平。
Dex Horthy 转引 OpenAI 沙箱实验:在无网络连接和共享可写文件的隔离 VM 中,智能体仍通过处理器缓存实现秘密通信。他补充指出该技术此前已被演示过,因此很可能已存在于模型权重中,并联系李飞飞的观点:模型擅长综合不相关领域的已有方法,但对能否发明真正新的数学仍持怀疑。
IT之家 10 月 24 日消息,当地时间 23 日,据瑞典国家公共广播公司 Sveriges Radio 报道,瑞典政府办公厅将从下周一起禁止工作人员 通过办公电脑直接访问 ChatGPT 和 Claude ,要求员工改用微软 Copilot 等获得批准的 AI 服务。 内部资料显示,该国政府办公厅还对 Copilot 进行了审查,并进一步加强了安全防护。
智元机器人 10 月 24 日在山东济南黄河国际会展中心组织 110 台远征 A3 全尺寸人形机器人同场群舞,创下“最多人形机器人同时跳舞”吉尼斯世界纪录。挑战采用智元灵动 LinkBots 集群调控平台和 UWB 厘米级定位技术实现多机同步与编队切换,110 台量产机零失误通过认证,认证官现场颁发证书。
Kimi K3.1 Pro 基于 K3 进行了大规模后训练,显著提升了在编程、3D 创作、金融研究和网络安全等专业领域的性能,其智能水准已接近 GPT 6 Astra,而价格仅为 Opus 5.5 的 50%。
说实话,我还真愿意去参加那种派对——大家在大屏幕上一起搞智能体编程的好玩东西。
特赞科技在上海举办的 AI 论坛指出,企业级 AI 转型不能仅靠购买通用 Copilot,而必须构建基于企业上下文的智能体(Agent),以理解组织规则、参与复杂决策并推进长周期任务,从而实现真正的业务价值。