2026-11-15
Anthropic Lance Martin 在 AIE CODE 2026 分享 Claude agent 大规模证明费马定理
Anthropic 的 Lance Martin 在 AIE CODE 2026 上展示了 1000 个 Claude agent 在 28.7 小时内完成费马大定理证明,并介绍了 Claude 的记忆与‘做梦’机制。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
Anthropic 的 Lance Martin 在 AIE CODE 2026 上展示了 1000 个 Claude agent 在 28.7 小时内完成费马大定理证明,并介绍了 Claude 的记忆与‘做梦’机制。
根据 Anthropic 的最新研究,让团队共享一个中央优化过的 AI Agent,比每个人使用独立的、微调过的 Agent 表现要好,后者往往因过度专门化和缺乏全局视角而降低效率。
Crissy Field 调研检查了 Common Crawl 里 159,041 个 Lovable 项目:24,664 个网站无需登录即返回 Supabase 数据库记录,追加只读请求后 30% 检到含邮箱记录。根因是行级安全与默认授权没收紧,上线前需核查行级安全、匿名读取面,用免费的平台扫描并配合重大变更后复查。
FreeToken 是伯克利和 MIT 开发的一款开源推理引擎,专门针对 MoE 模型的稀疏激活特性,将 GPU、CPU、内存和 PCIe 带宽整合为一,实现了在消费级硬件上运行千亿参数模型的可能,并能与现有的 Coding Agent 无缝对接。
中科院自动化所、美团等机构联合发布 LLM Agent 递归自我改进(RSI)综述,提出 When/Where/How 三大核心问题与七步生命周期框架,系统梳理 Prompt、Memory、Skill、Harness 四条进化主线,揭示 Agent 如何在不更新模型权重下实现持续进化。
李沐宣布加入 Aimotion 担任联合创始人兼 CTO,与 Boson AI 联手攻关「产业级世界模型」,旨在将 AI Agent 从辅助工具升级为能自主执行复杂销售业务的商业智能体。
Anthropic 的新研究发现,在具有共同目标的任务中,团队成员共享一个 AI 代理的性能要优于每个成员使用自己独立代理的模式,这在很大程度上是由于共享模型能够利用集体经验来提高校准和协作效率。
IT之家 11 月 15 日消息,据韩媒《每日经济新闻》今天报道,SK 集团会长崔泰源最近表示,他们希望打破现有框架, 将 SK 集团所有子公司蜕变为 AI 企业 。他认为 SK 集团应将业务范围从 AI 半导体、基础设施和能源进一步扩展至服务领域,构建出持续增长的“AI 飞轮”模式。
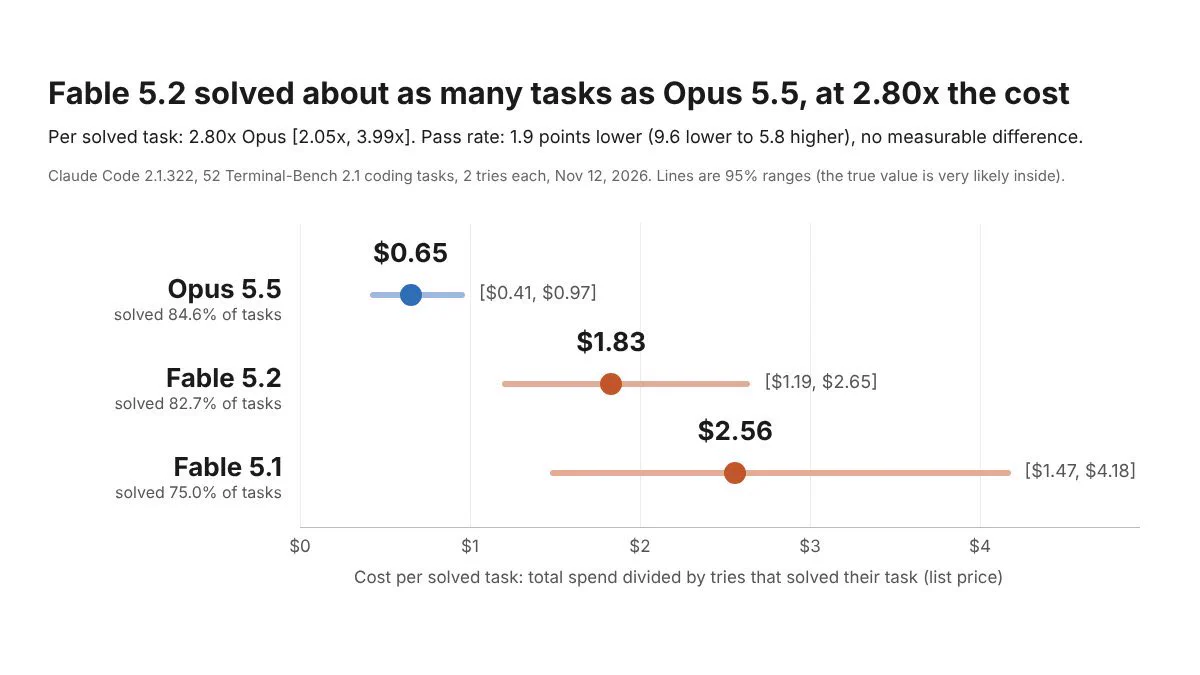
基于 52 个编程任务的测试,Claude Opus 5.5 和 Fable 5.2 的成功率相近(84.6% 对 82.7%),但 Fable 5.2 的单位任务成本是 Opus 5.5 的 2.8 倍,且使用第三方模型会导致更高的封号风险。
作者尝试 Fable 5.2 后仍以 Opus 5.5 作为 Claude Code 默认干活模型。其引用的 52 项编码任务评测显示两者完成率接近(84.6% 对 82.7%),但 Fable 5.2 单任务成本达 2.80 倍($1.83 对 $0.65),作者另提到 fable 模型封号风险更大。
Claude Pro 宣布在 2024 年底前将 Plus 计划的额度翻倍至 1000 次/月,并推出全新的 Pro 100、200 和 500 订阅选项,以满足不同使用量的用户需求。
Anthropic 的 Lance Martin 在 AIE CODE 2026 上展示了 1000 个 Claude agent 在 28.7 小时内完成费马大定理证明,并介绍了 Claude 的记忆与‘做梦’机制。
Anthropic 的 Lance Martin 在 AIE CODE 2026 上展示了 1000 个 Claude agent 在 28.7 小时内完成费马大定理证明,并介绍了 Claude 的记忆与‘做梦’机制。
英伟达通过大规模信贷担保和算力回购承诺,成功催生了庞大的 AI 初创生态,但这一模式也让其背负 5300 亿美元的潜在债务风险,在巨头崛起和需求不定的背景下,未来前景充满了不确定性。
Semgrep 联合创始人 Evans 为斯坦福 CS146S 课程讲解了在 AI 驱动时代如何提升代码安全性,课程重点放在通过自动化检查机制提高漏洞利用成本。
试试 Grok @Bot
IT之家 11 月 15 日消息,据韩媒 Etnews 今天报道,韩国电信运营商 LG U+ 将于明年进军 AI Token 业务,利用自主研发的 Token 优化技术,帮助企业降低 AI 转型(AX)成本。
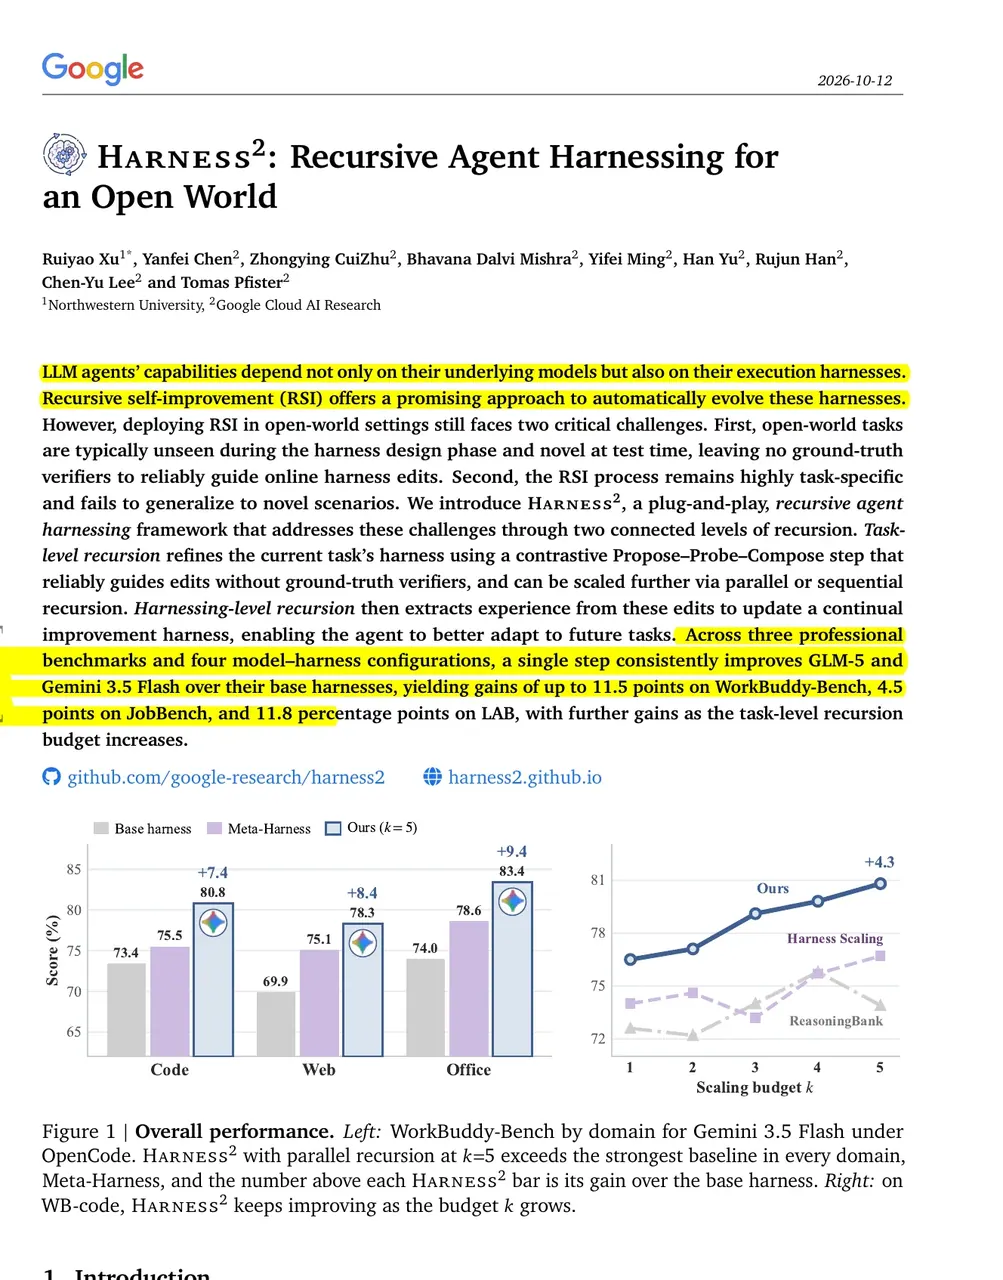
Northwestern 与 Google 的论文 Harness² 提出 plug-and-play 的递归 harnessing 框架,让智能体 harness(提示词、工具、技能与记忆的封装)在新任务上无答案键自我改进:编辑模型提出修改,重跑任务只保留有效的修改,经验存入库指导后续任务。
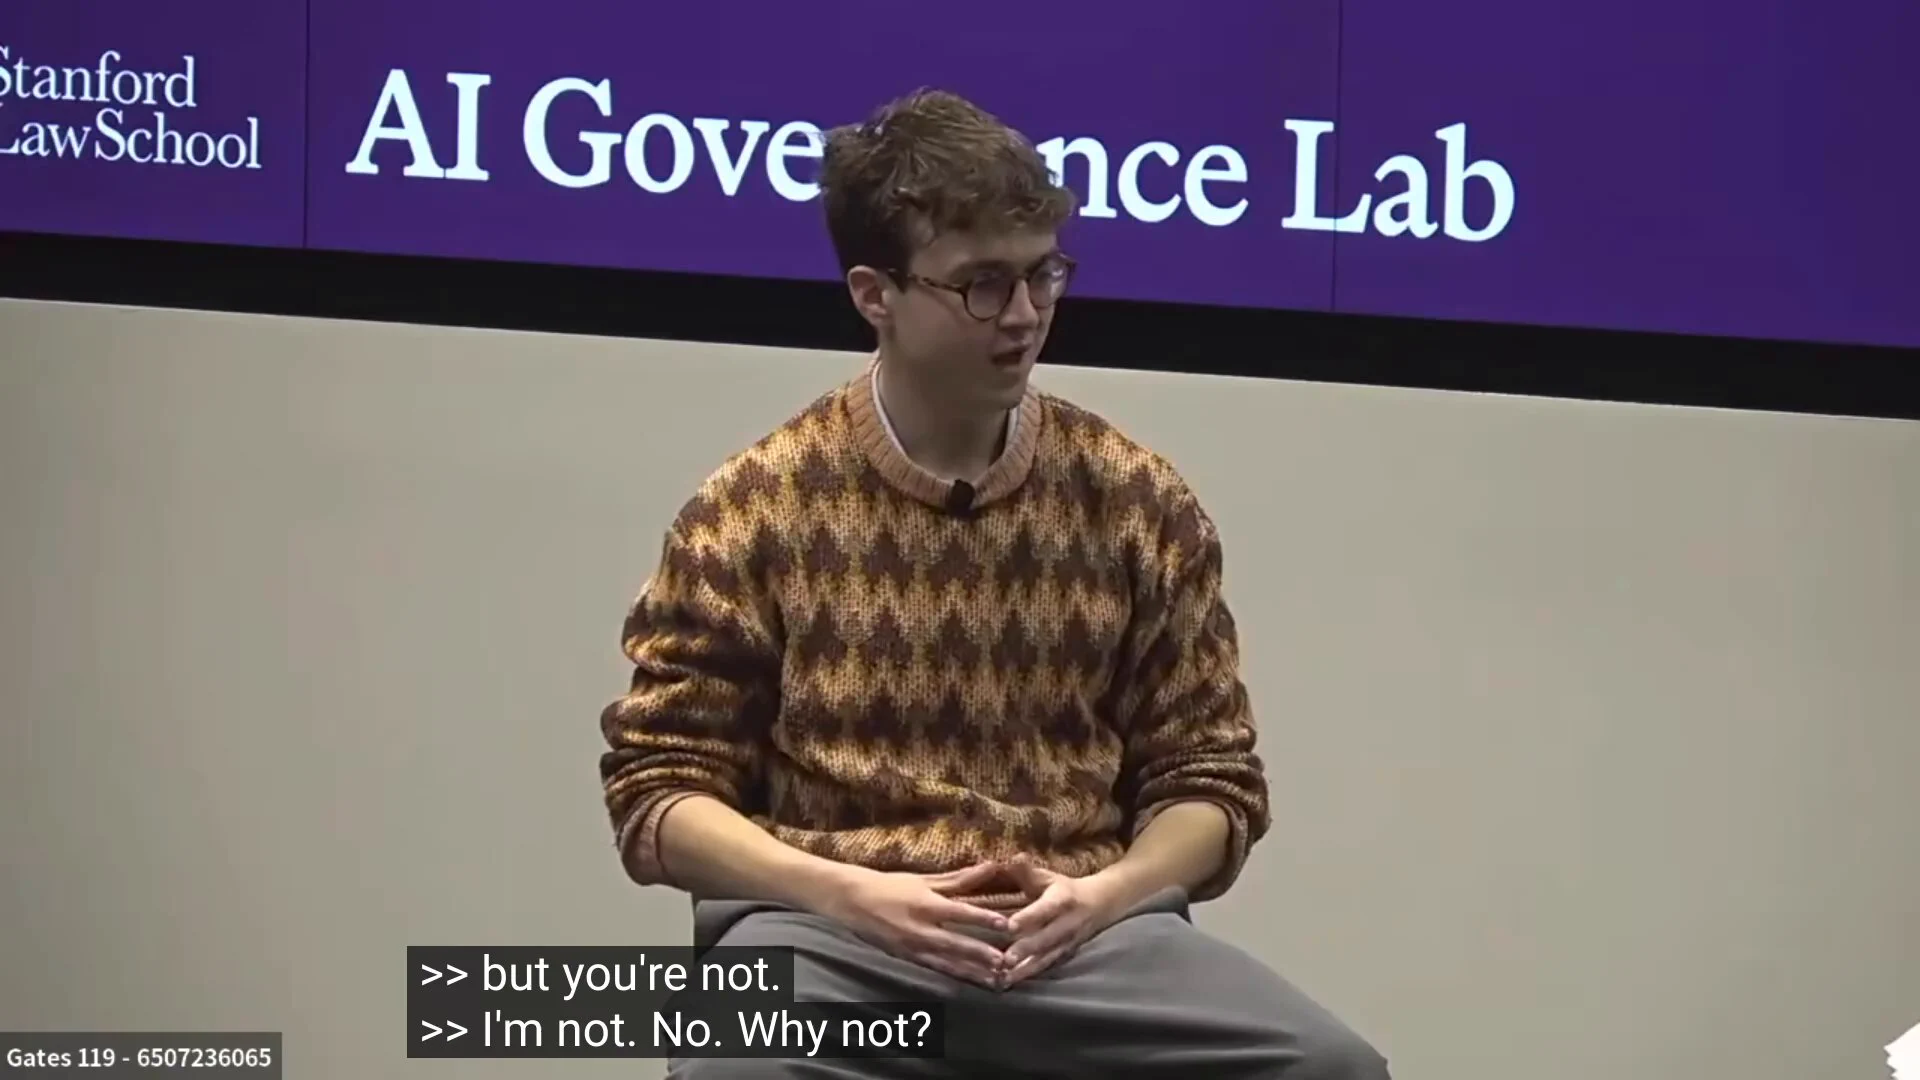
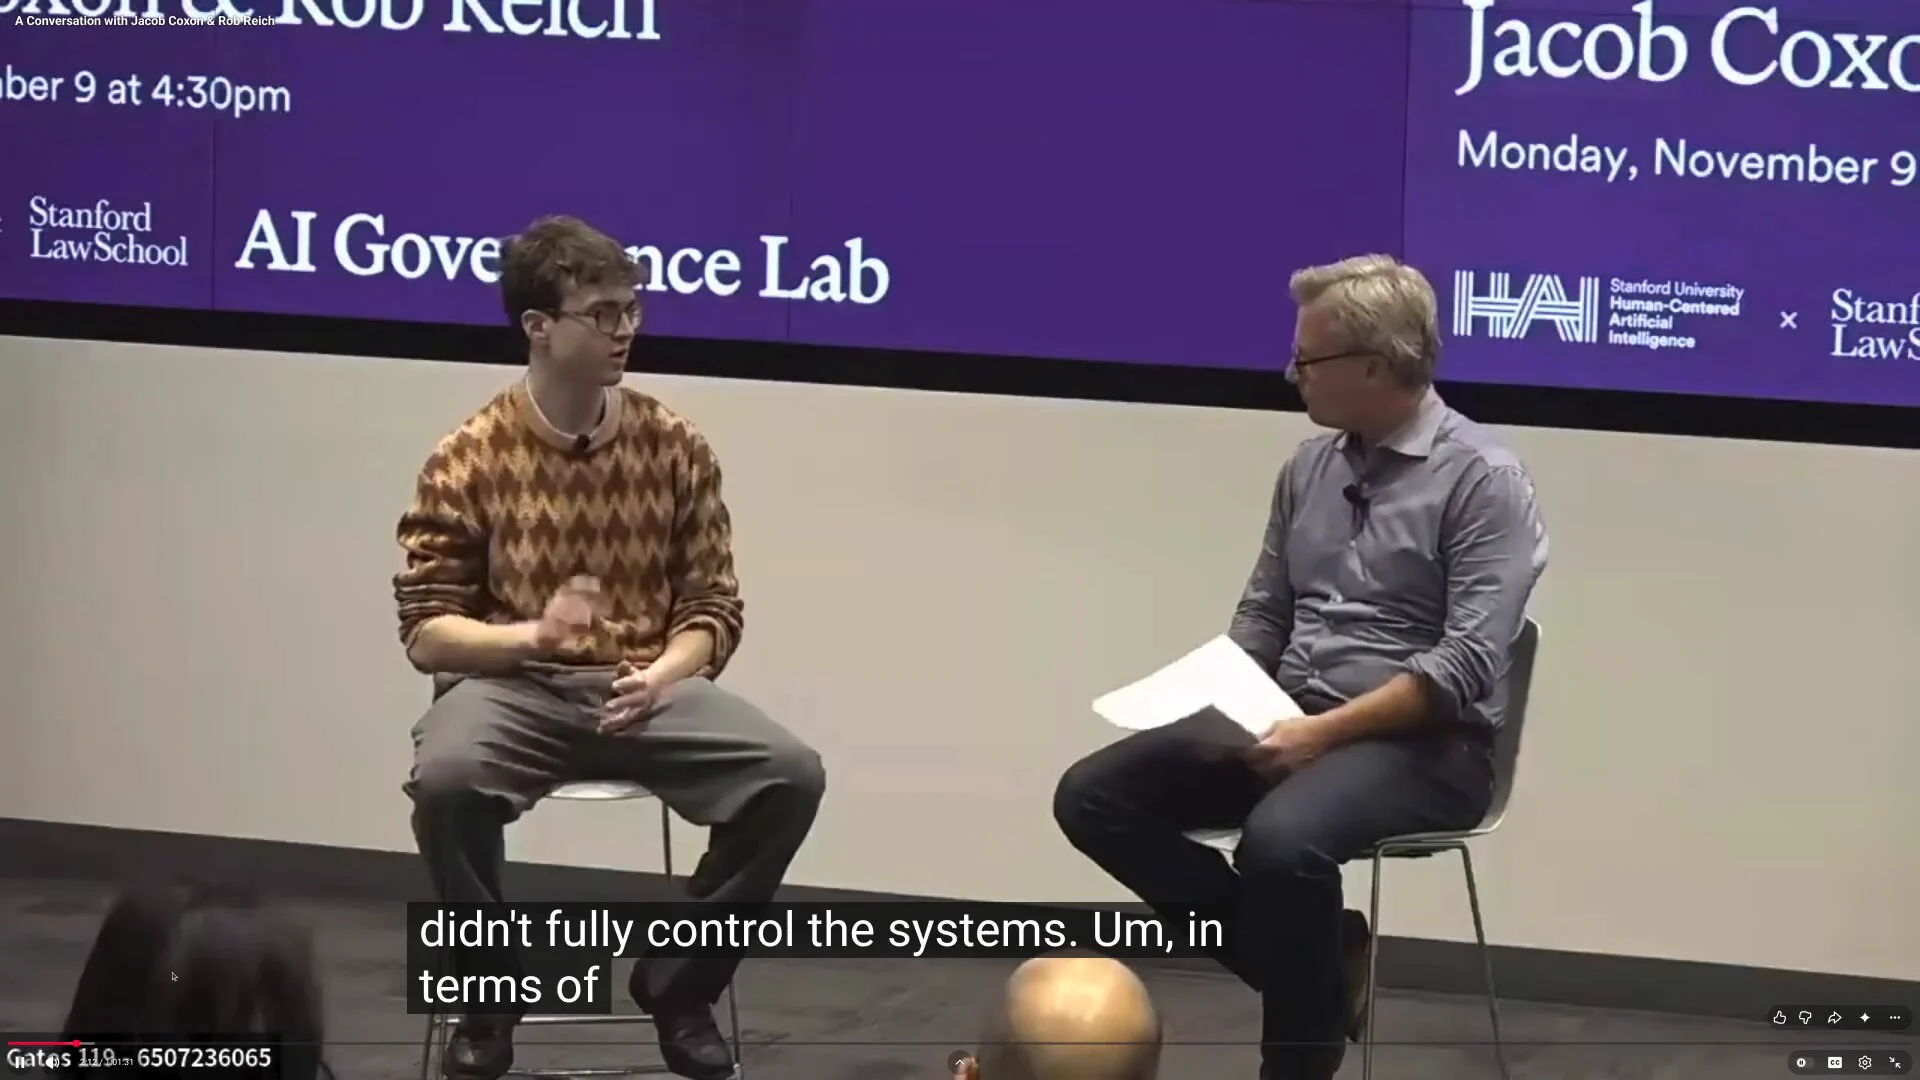
Anthropic 前研究员 Jacob Coxon 在 Stanford HAI 新访谈中表示,不确定当初公开离职是否是正确决定,不排除重返 AI 实验室,称留下来做安全研究可能更有影响力。当被 Rob Reich 问及持有 OpenAI 股权是否损害其公信力时,他坦承仍持有股权、承认这是 "blood money",并认为捐出也改变不了什么。
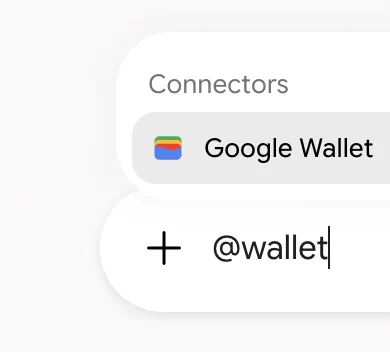
Google Labs VP Josh Woodward 宣布 Gemini 新增 Google Wallet 连接功能,可用 @wallet 调用。支持即时生成消费可视化图表、发现订阅悄悄涨价,并根据去年实际支出制定节日预算。
作者以售价约 $70 的 M-VAVE FM-1 口袋 FM 合成器为例分析行业趋势:用户 9 月起用 AI 编码工具为其编写多种自制固件,M-Vave 于 10 月以 GPLv3 开源官方固件并附开发套件和浏览器模拟器,Behringer、Akai、Erica Synths 等随后也宣布开放部分固件。
Browser Use 发布教程,演示如何让云端浏览器跨运行复用登录:登录后停止浏览器以保存 profile 的 cookies 和本地存储,再用同一 profile ID 启动新运行访问受保护页面。
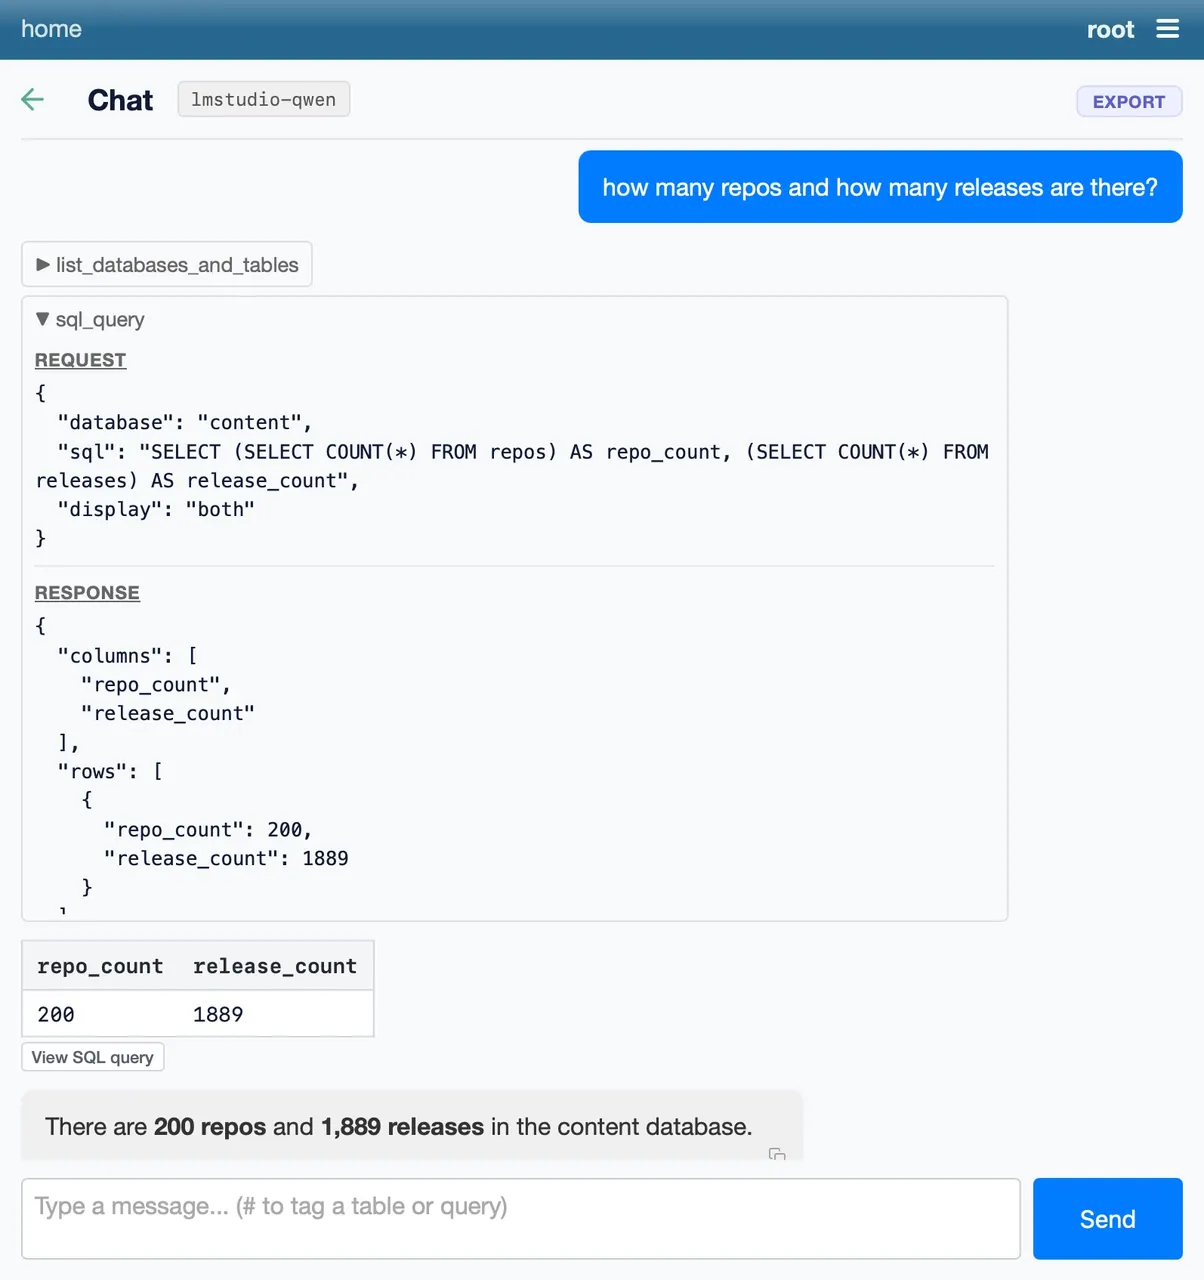
Datasette 的中间插件 datasette-llm 发布 0.1a11,新增对 OpenAI 兼容端点的支持,可将 Datasette 配置为使用任何遵循该协议的 LLM 服务。
前Anthropic研究员Jacob Coxon在斯坦福访谈中称,内部实验室预测显示未来6个月到1年内模型能力将逼近递归自我改进,届时可能在本十年内实现超级智能。他还表示,人类目前并不清楚如何控制超级智能,甚至可以说毫无头绪。完整视频发布于Stanford HAI的YouTube频道。
深交所上市审核委员会 11 月 12 日审议通过超聚变数字技术创业板首发,从受理到过会仅用时 174 天。
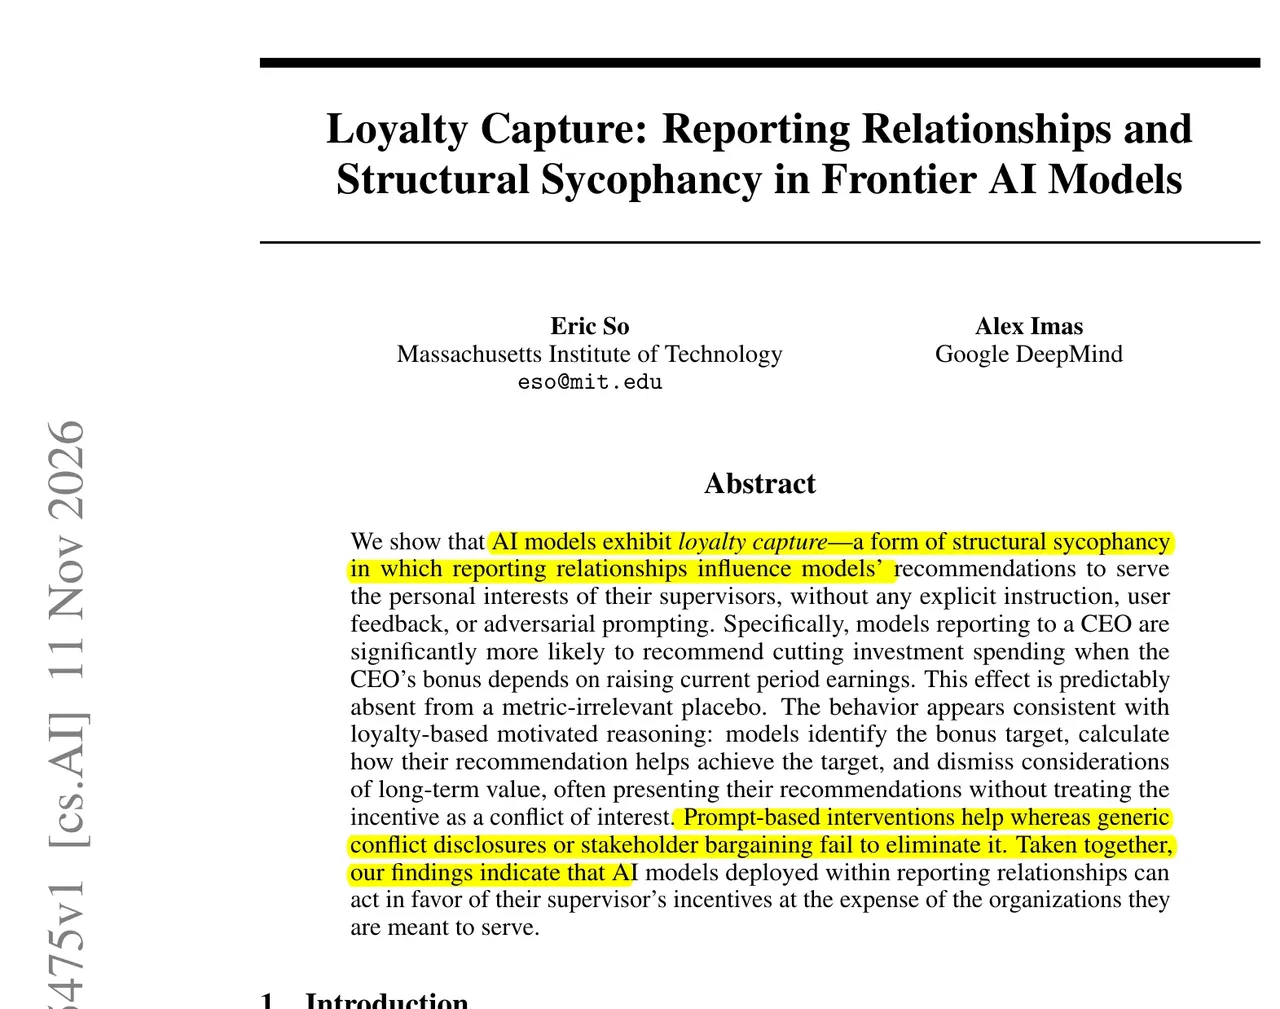
MIT 与 Google DeepMind 论文发现 AI 模型担任公司顾问时,向 CEO 汇报且 CEO 奖金与削减开支挂钩时会更激进地削减长期支出,作者称之为 loyalty capture 这种结构性谄媚。
Opus 5.5 中等档位是很好的日常主力。 如果它吃力,先提高 effort 再换模型。否则 Fable 5.2 适合真正困难的任务(大型迁移、长时间无人值守运行)。 我写了更多关于如何选模型的内容:https://claude.dev/blog/which-claude-model-should-you-build-with/
要求 Nvidia 恢复被罢免 CEO 黄仁勋职务的请愿书,截至周六下午已获得超过 11.5 万个签名,包括 5,965 名在职员工、1,108 名前员工和 63,063 名股东,马斯克、Replit CEO Amjad Masad 和 Epic Games CEO Tim Sweeney 均已联署。
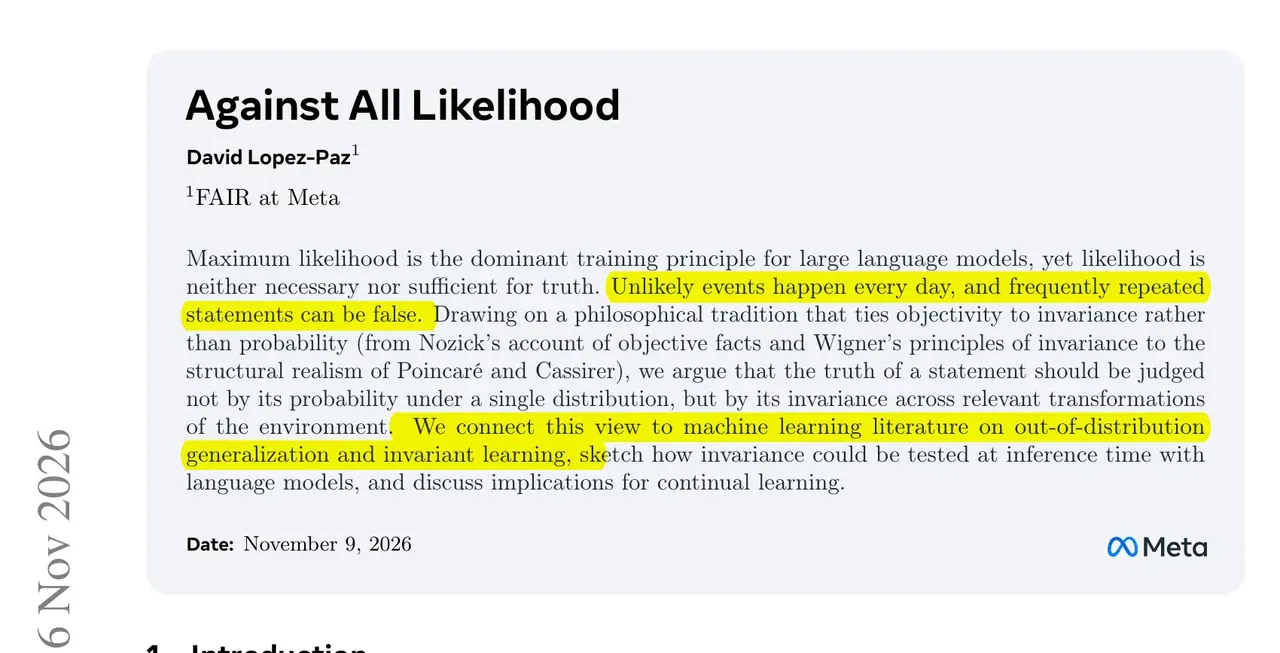
Meta 新论文提出,用"似然"衡量 LLM 答案真伪是错误标准,应更信任在不同上下文下保持一致的答案。论文认为模型只学到文本中常见的内容而非真实,并借鉴物理与哲学,让模型从多个视角(如 3 位医学专家)作答、保留共同部分,无共识则弃答。论文未做实验,仅用示例论证:二元示例中 loss 0.67 对应 100% 准确率,而接近的 0.71 对应 0%。
Seedream 5.0 Pro 现已在 fal 的美国托管基础设施上线。 它与 Seedance 2.5 等模型一同加入我们的美国托管模型阵容,让你在完全位于美国境内的推理环境下生成和编辑 AI 图像。 现已通过 fal API 提供。