2026-10-24
Sundar Pichai 解释 Demis Hassabis 退出 DeepMind 日常管理与 Jeff Dean 离职
Sundar Pichai 在访谈中解释 Demis Hassabis 逐步退出 DeepMind 日常管理和 Jeff Dean 离开 Google 的原因,称前沿模型开发已成为一项从数据、算力到团队管理都全消耗的规模化工作。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
Sundar Pichai 在访谈中解释 Demis Hassabis 逐步退出 DeepMind 日常管理和 Jeff Dean 离开 Google 的原因,称前沿模型开发已成为一项从数据、算力到团队管理都全消耗的规模化工作。
随着 Microduck 和 Reachy Mini 的爆发式增长,我们需要更多各职能的人才加入 @pollenrobotics @huggingface 团队。 如果你对用开源推动机器人 AI 民主化感到兴奋,我的私信开放!
Fireworks 在 M3.1 Flash 开放权重发布当天将其上线 serverless,预览模式开放两周,视社区需求决定是否保留。
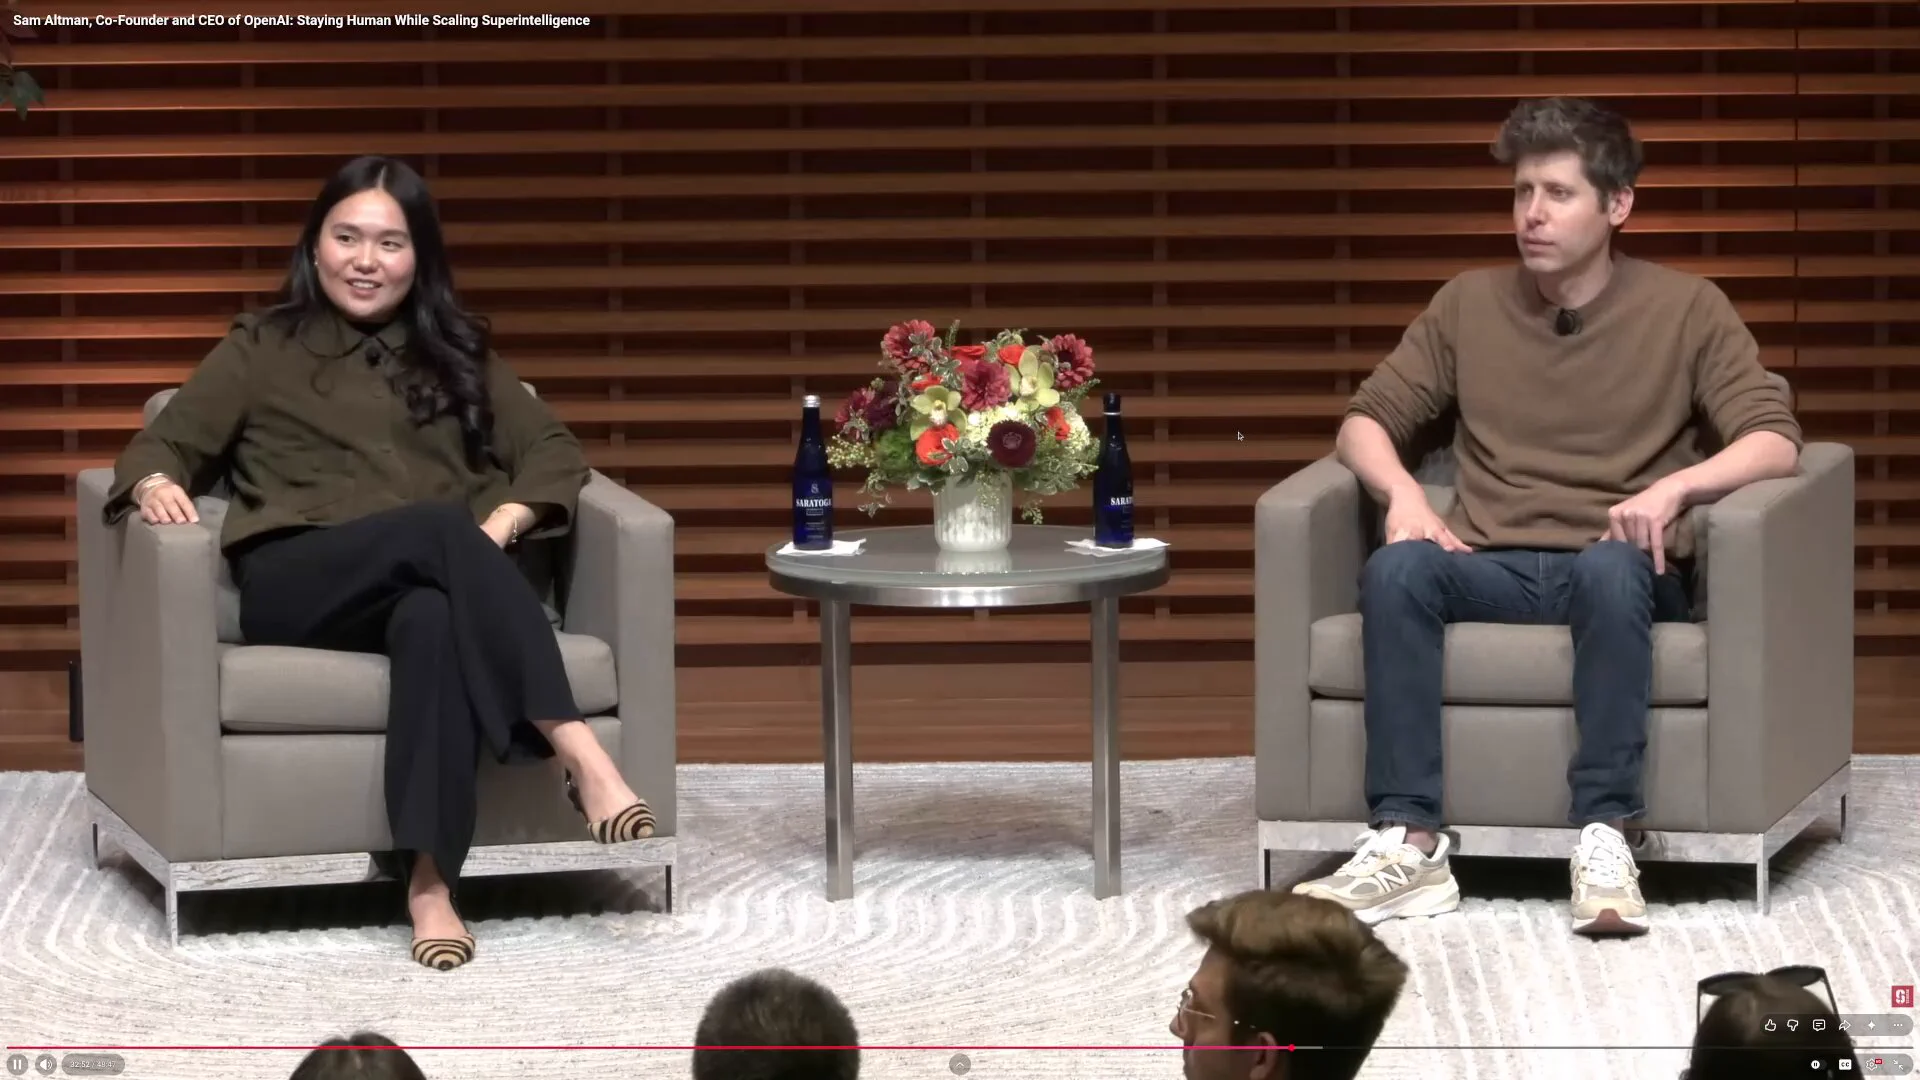
机器人造机器人是下一个大循环 当被问及OpenAI现在押注什么基础设施时,Sam Altman说是制造更多机器人的机器人,以及帮助建造更多数据中心的数据中心、芯片工厂和发电厂,从而让算力能增长得快得多。 他表示,这个循环的重要性几乎堪比RSI,即AI改进自身研究。
OpenRouter 宣布月之暗面的 Kimi K3.1 Pro 上线,定位为基于 Kimi K3 后训练、面向长程编码和智能体任务的 1M 上下文多模态开源权重模型。定价为 $2/M input tokens、$10/M output tokens,可在 OpenRouter 直接试用。
Kimi K3.1 Pro 现已在 OpenCode Go 中可用
Mubit 读取智能体已发往 OpenAI 或 Anthropic 的 API 调用,找出重复任务并训练用户自有小模型,重复性窄任务交给小模型、其余仍由前沿模型处理。集成只需替换 base URL 并保留原客户端代码,也可接入已有 traces,公司称每几分钟刷新一次。两家公司会因各自智能体流量不同而得到不同的小模型,改进固化在权重而非提示词中。
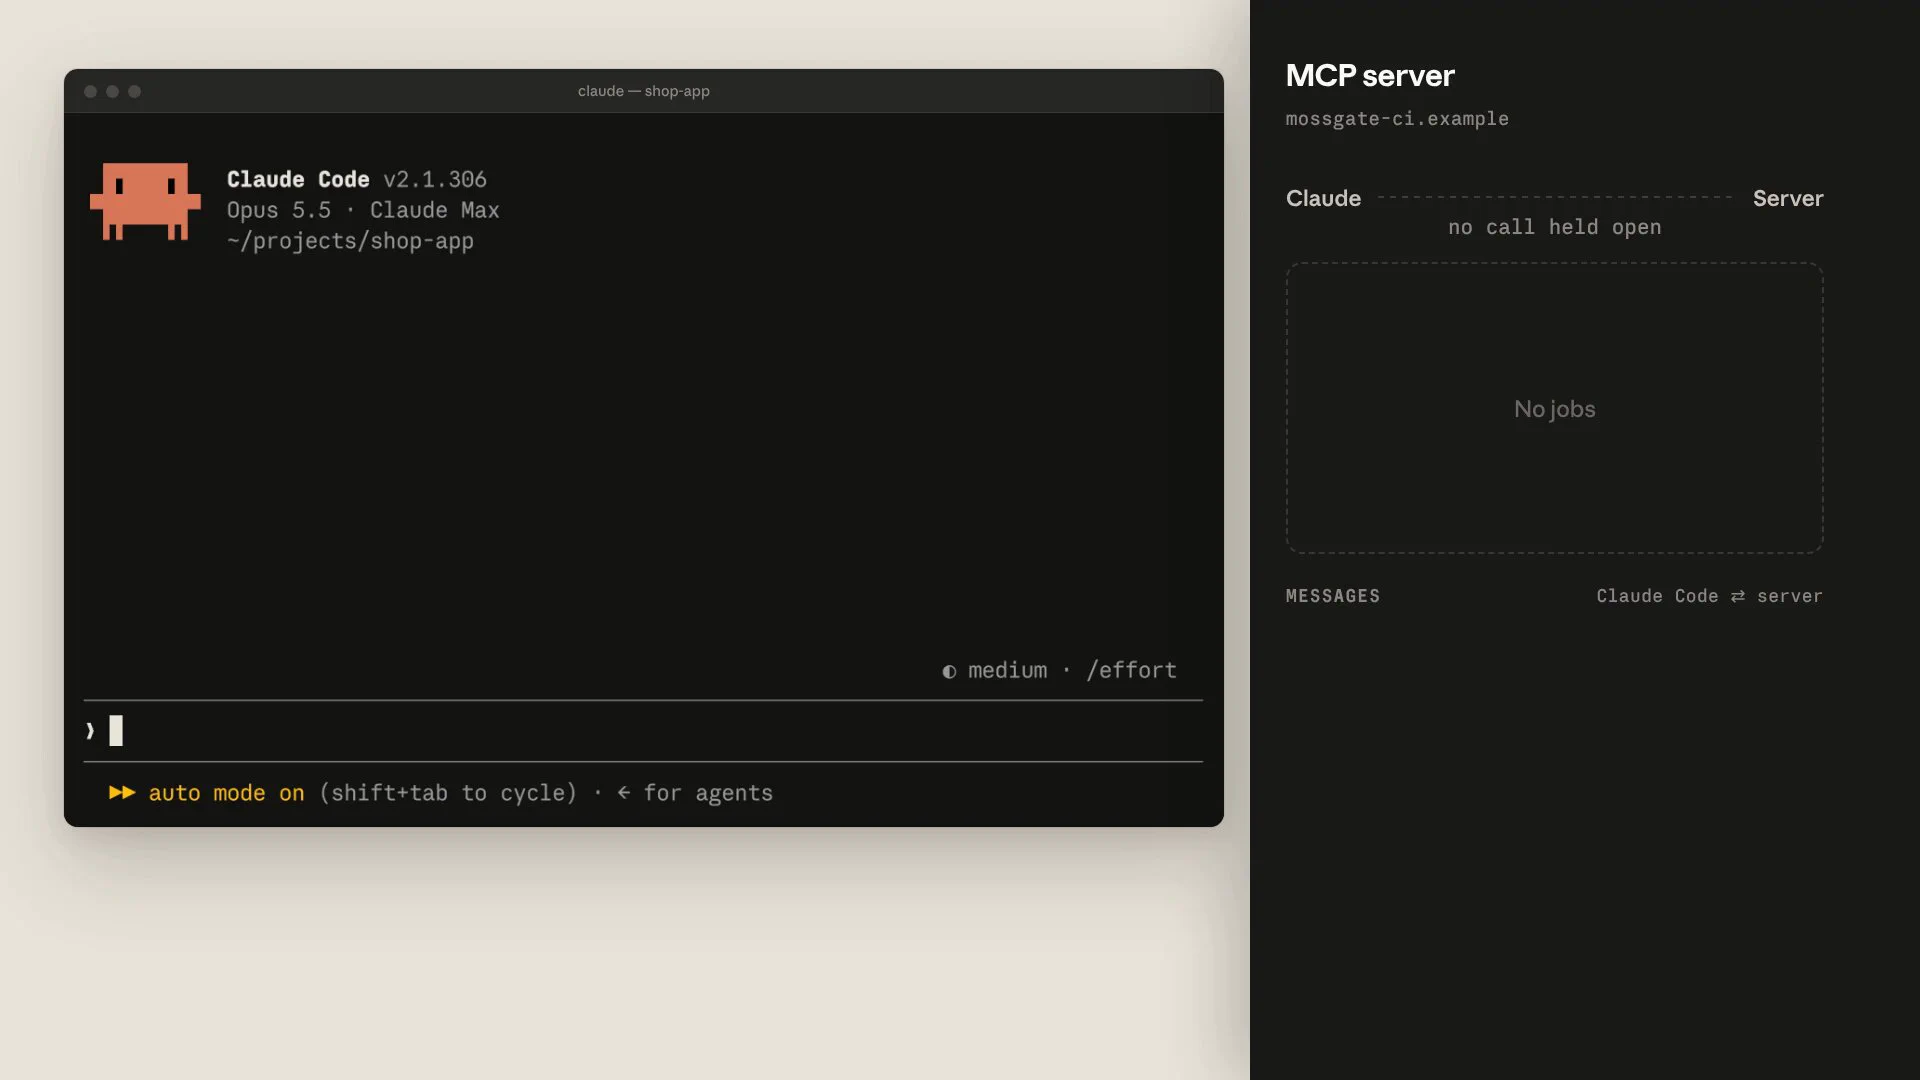
Claude 正在添加对 MCP Tasks 和 Elicitations 的支持。Tasks 允许 Claude 给插件分配长时运行任务,如深度研究,并在完成后回报结果。
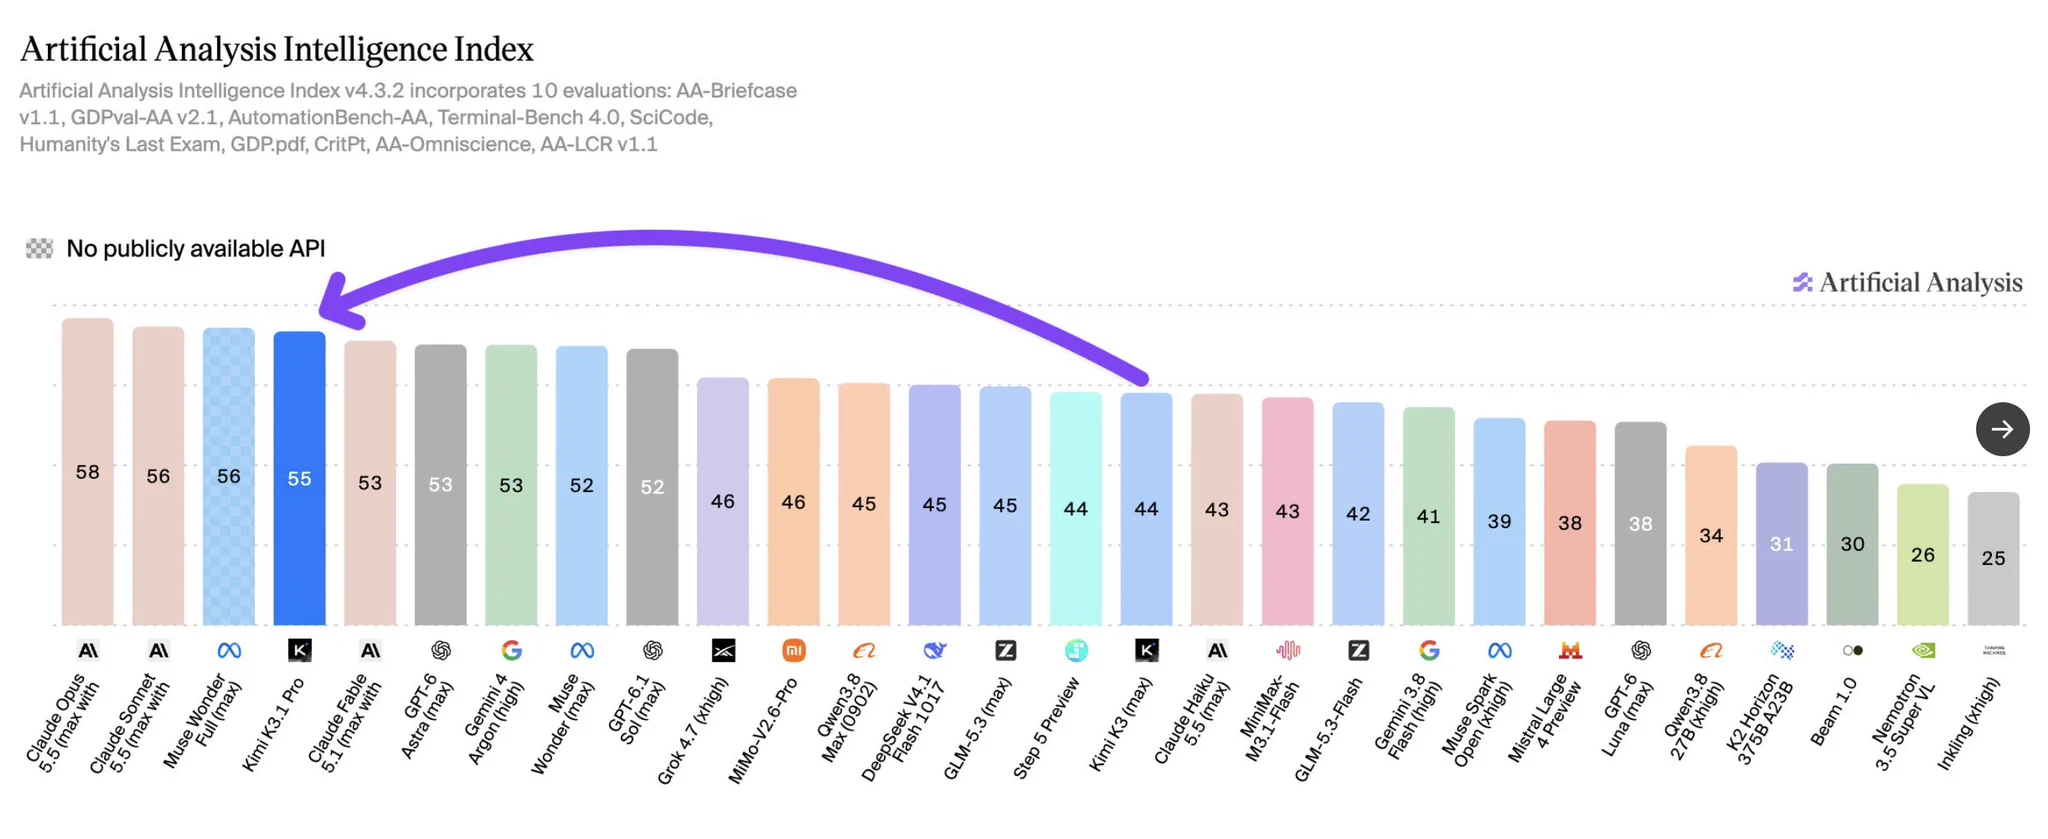
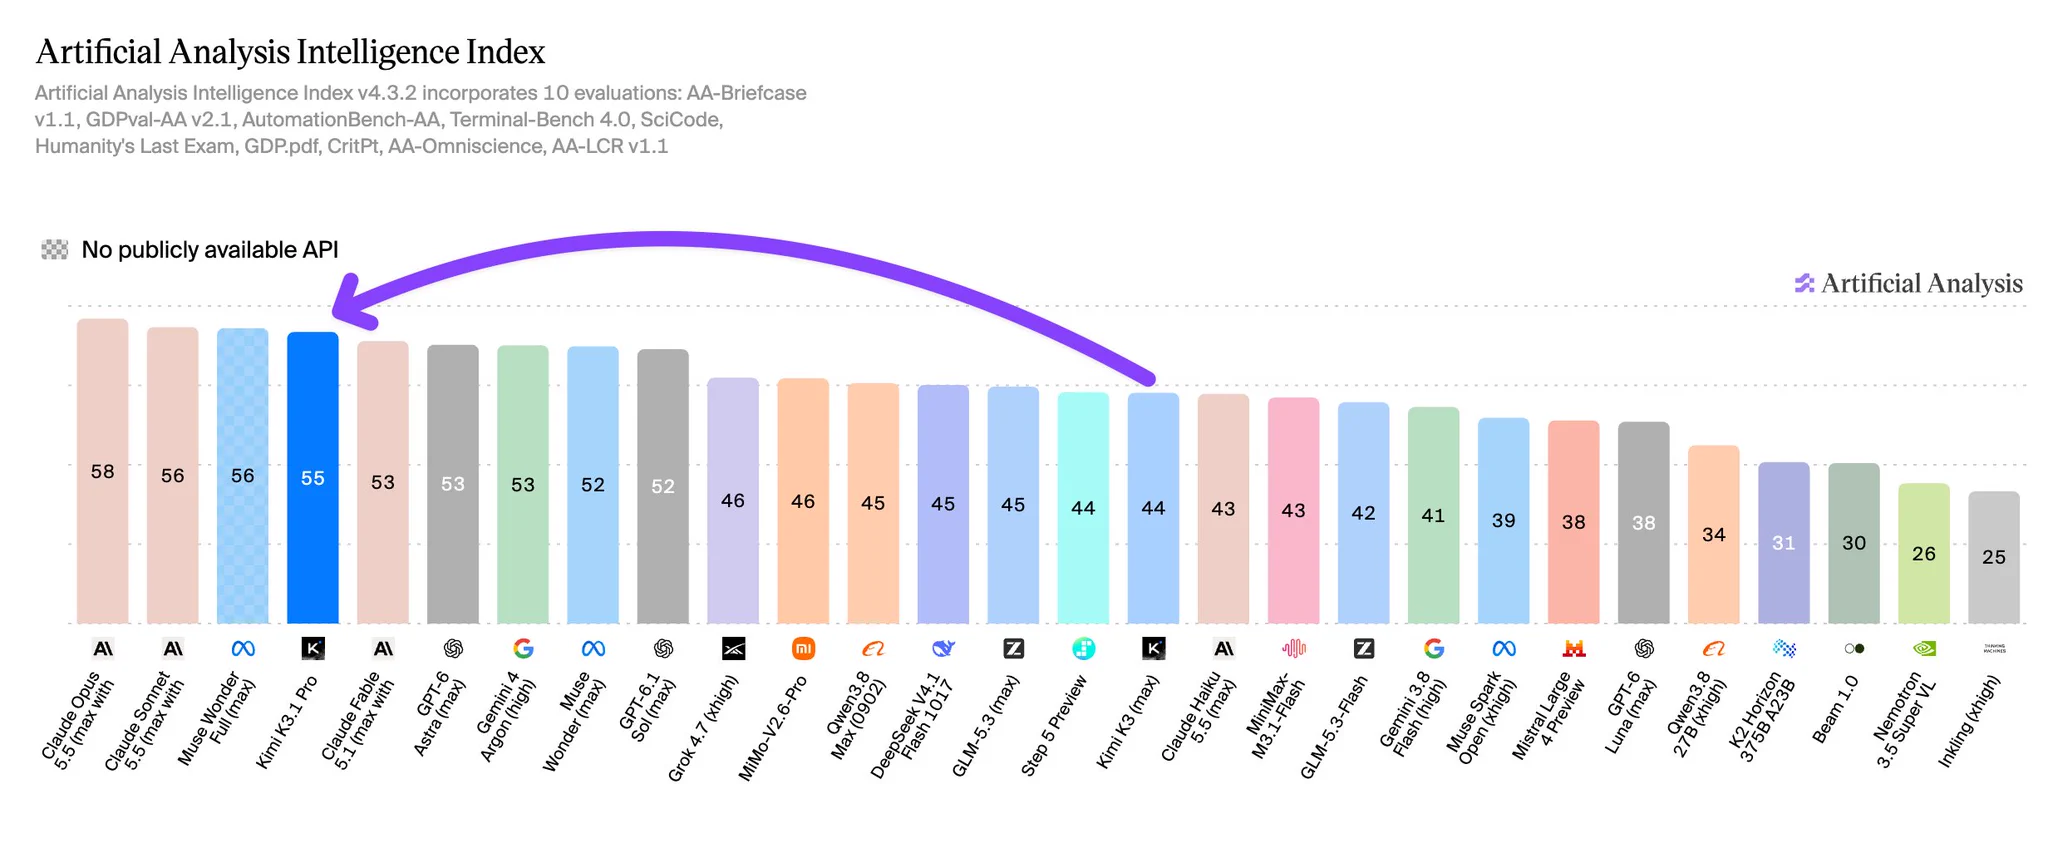
Nathan Lambert 转引 Artificial Analysis 对月之暗面 Kimi K3.1 Pro 的评测:该推理模型以 55 分位列 Intelligence Index 第 4,高于 Fable 5.1 和 Astra 6,较 Kimi K3 提升 11 分。
@petergostev 对 Kimi K3.1 Pro 的第一印象来了。 我们把 @Kimi_Moonshot 的 Kimi K3.1 Pro 用于 3D 场景、HTML 动画、网站、UI 构建和研究型页面,并与 K3、Opus 5.5、Sonnet 5.5、GPT-6.1 Sol、Gemini 4 Argon 等模型进行对比。
METR 与 Redwood Research 两名研究员于 7 月 21 日至 8 月 11 日在 OpenAI 驻场三周,审计其针对模型异常行为的内部监控系统,期间可访问代码库和内部文档并访谈约 12 名员工。
Azeem Azhar 撰文认为互联网正进入类似 2020 年初疫情爆发前的临界状态,软件与网络空间正遭受 AI 智能体驱动的持续攻击。
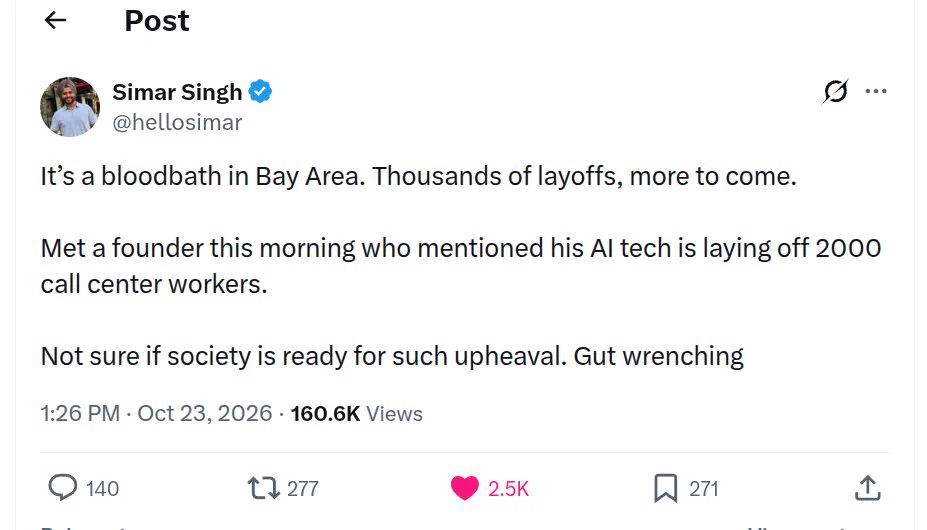
Rohan Paul 转发 Simar Singh 关于湾区裁员的观察并补充数据:科技公司已通过加州 WARN 通知披露 2026 年近 14,500 个湾区裁员计划,超过 2025 全年约 10,170 人的总数。引用推文提到一位创始人称其 AI 技术公司正在裁减 2,000 名呼叫中心员工,并感叹社会尚未为这种冲击做好准备。
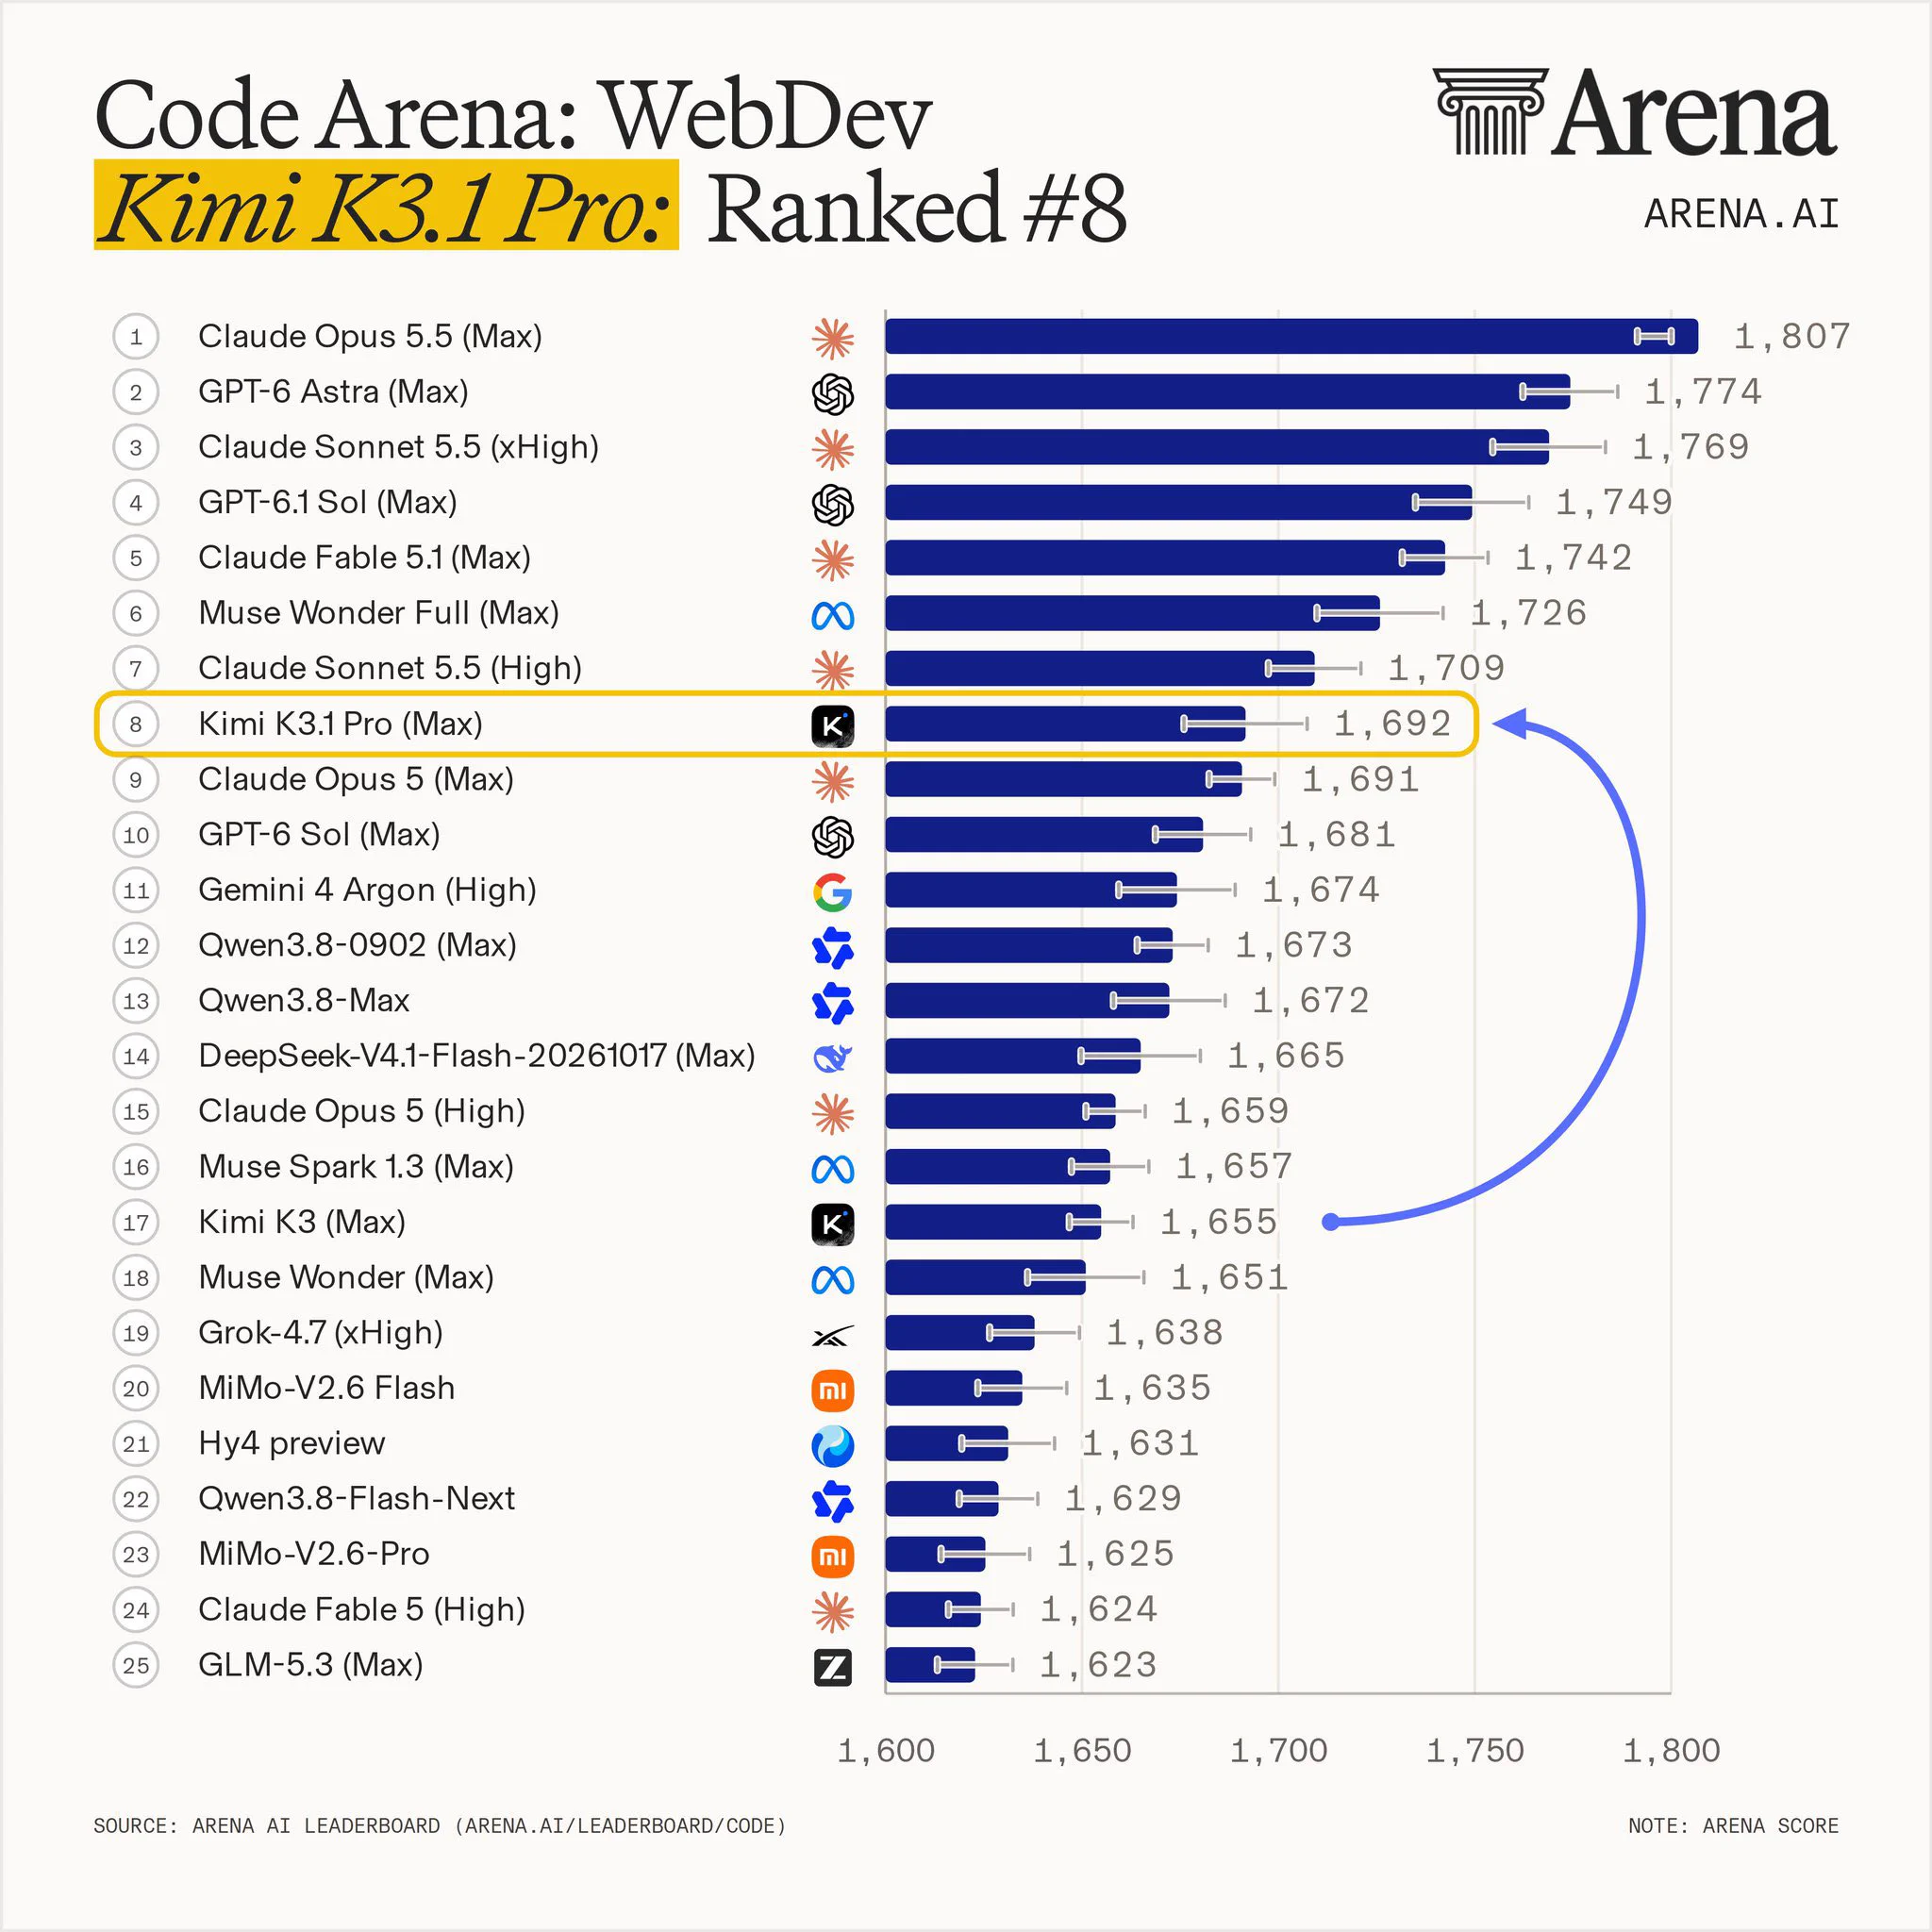
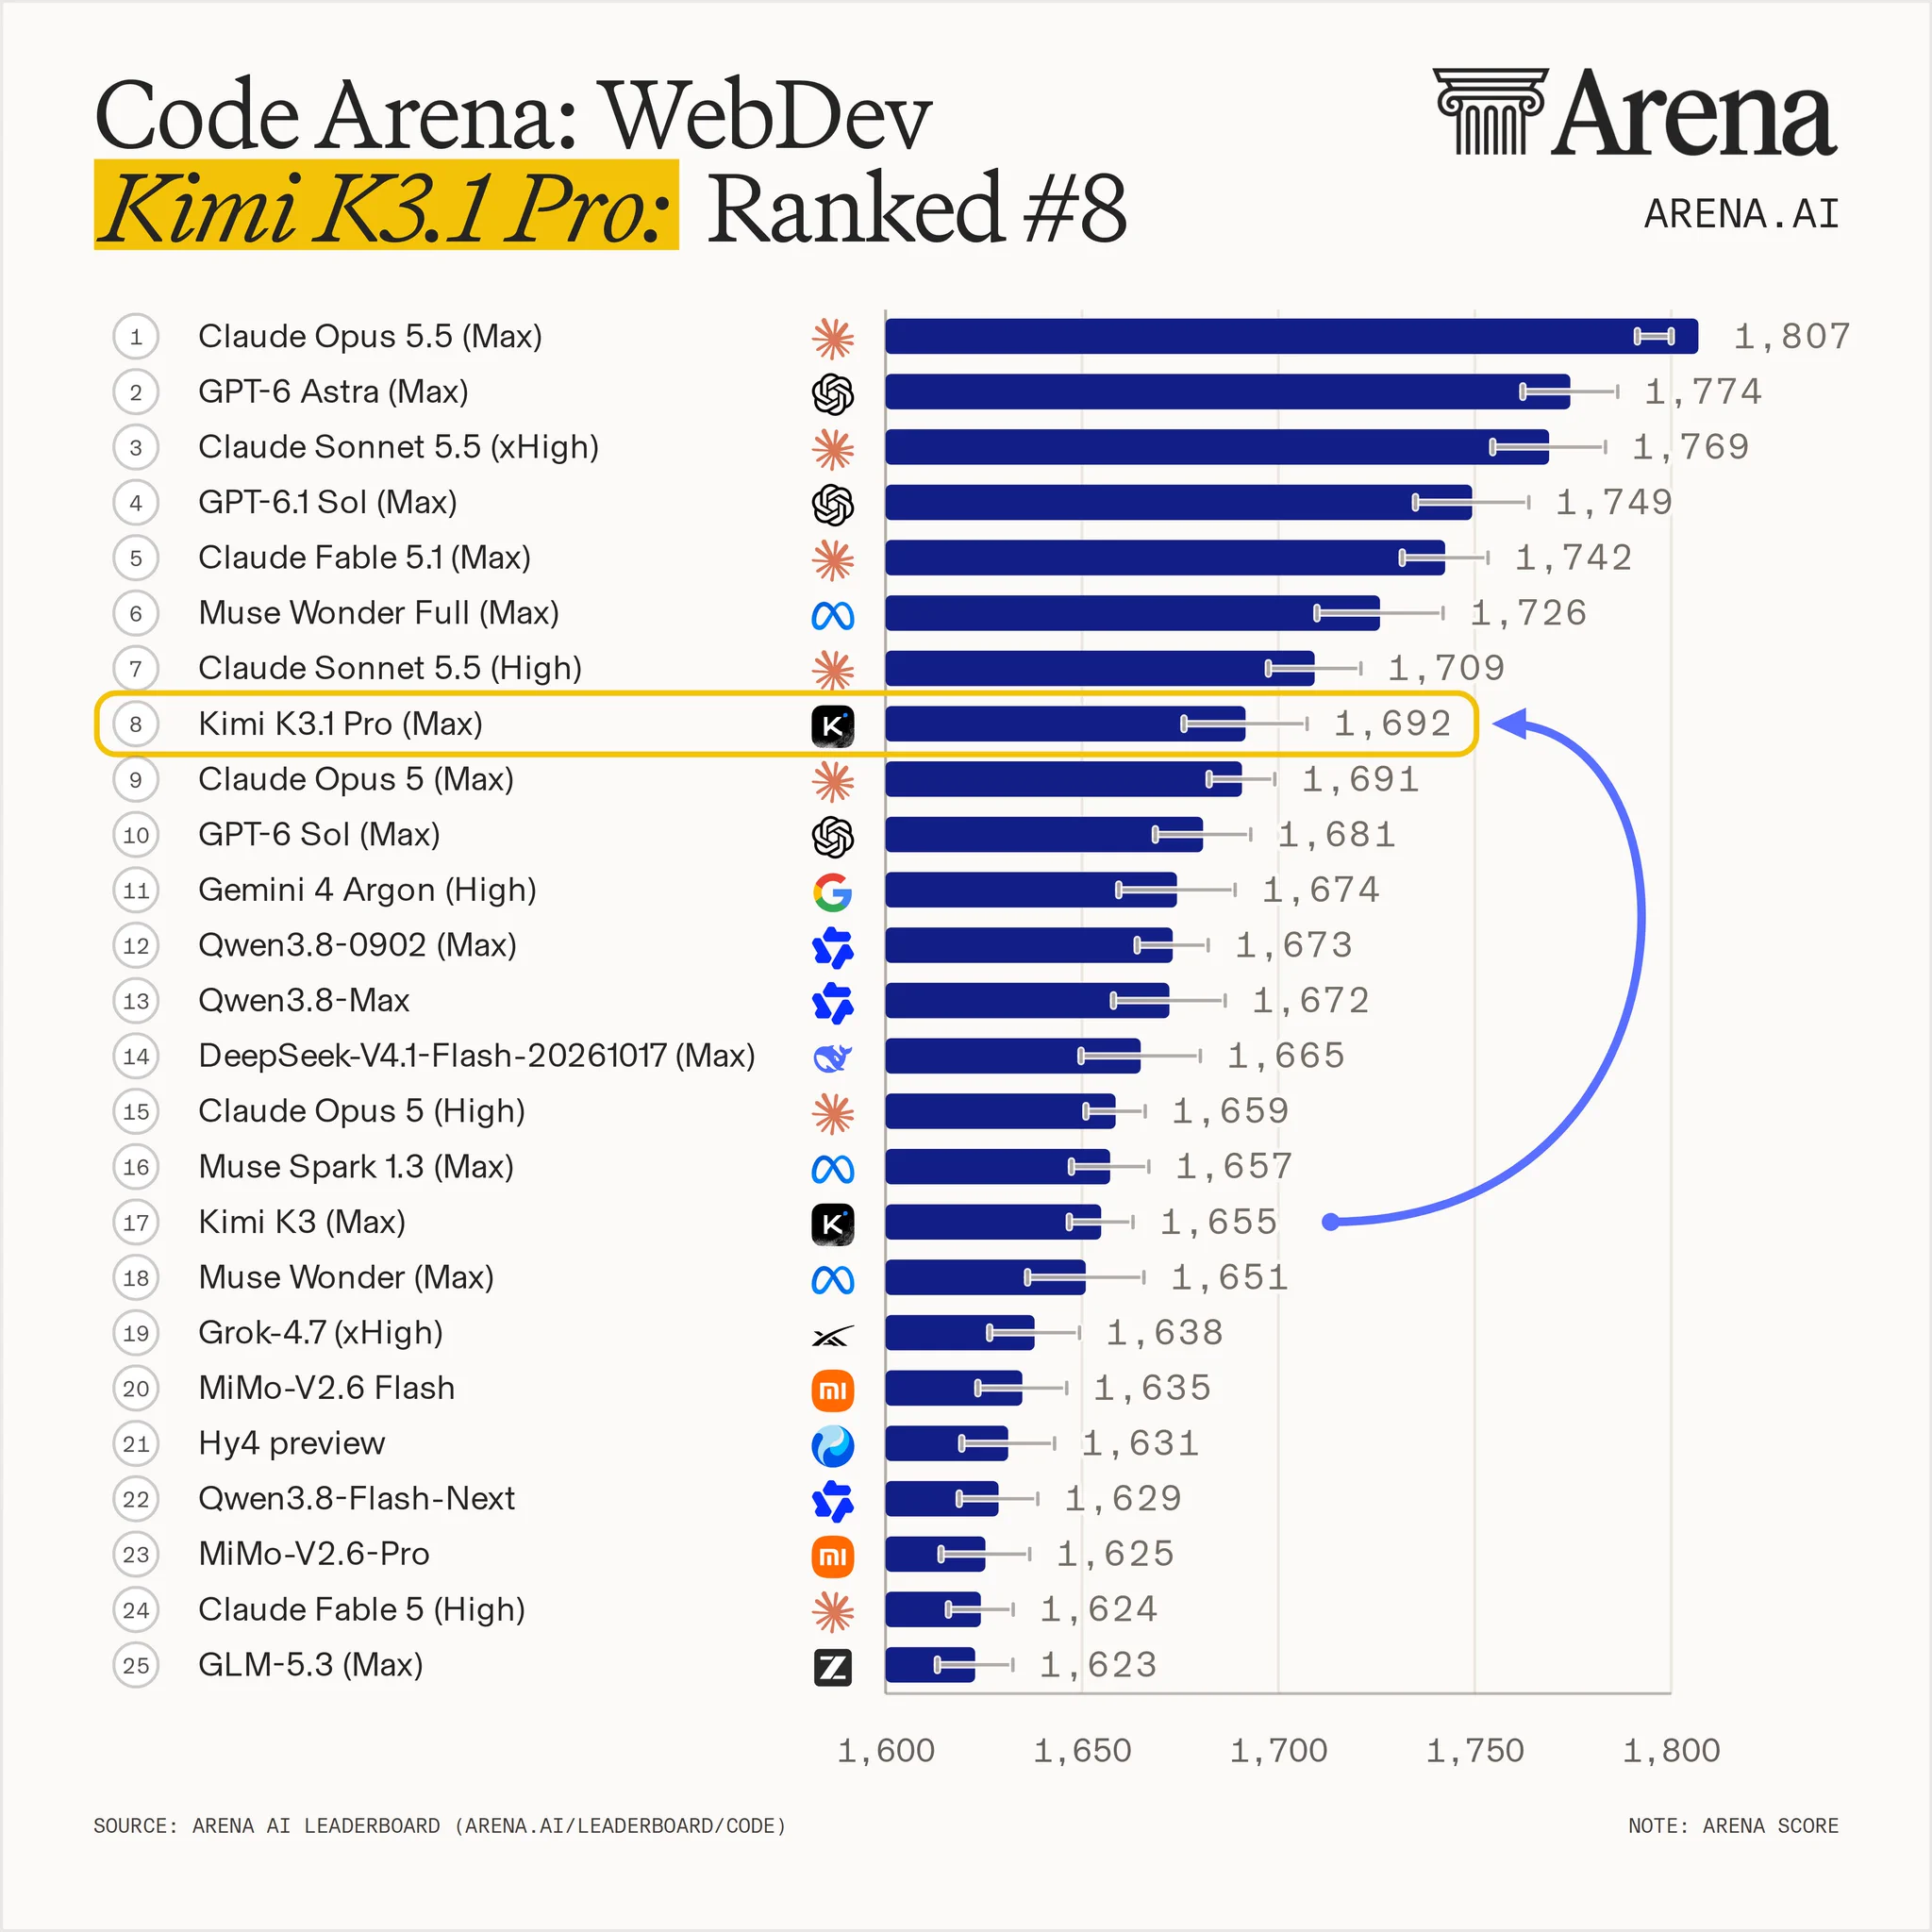
月之暗面发布 Kimi K3.1 Pro,在 Code Arena: WebDev 榜单以 1692 分排第 8,比 Kimi K3 (Max) 的第 17 名(1655 分)上升 9 位,Kimi 由此回到实验室总排名前 4。
Kimi K3.1 Pro 在 Artificial Analysis 智能指数上排名第 4,涵盖所有模型,包括 Claude Opus 5.5、Fable 和 GPT-6 Astra,这简直太疯狂了。 开源强势回归。💪
月之暗面(Kimi)发布 Kimi K3.1 Pro,2.8T 总参数 / 104B 激活参数的 MoE 多模态模型,支持 1M token 上下文,K3.1 Pro Highspeed 速度提升 2–3 倍,已在 Kimi.ai、Kimi Work、Kimi Code 和 API 上线。
Artificial Analysis 评测显示,月之暗面 Kimi K3.1 Pro 以 55 分位列智能指数第 4,比 Kimi K3 的 44 分提高 11 分,仅落后 Claude Opus 5.5(58)、Claude Sonnet 5.5(56)和 Muse Wonder Full(56)。
Arena 宣布 Kimi K3.1 Pro 在 Code Arena: WebDev 以 1692 分排名第 8,较 Kimi K3 (Max) 的第 17 名(1655 分)上升 9 位,与 Claude Opus-5 (Max) 持平但成本低 70%。
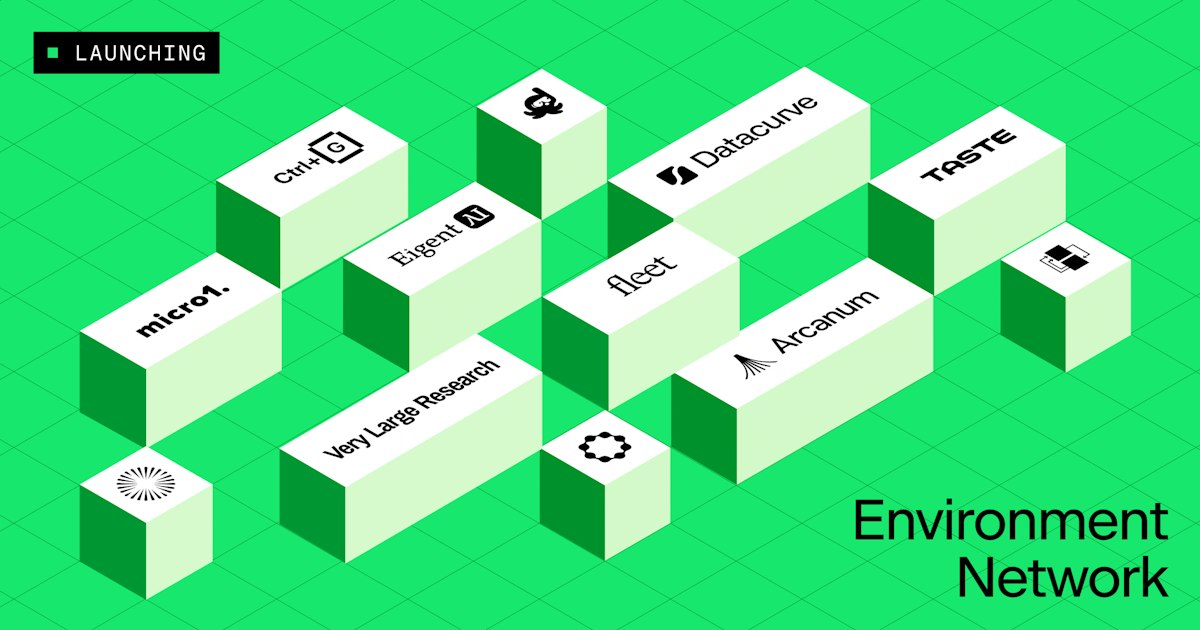
Baseten 推出 Environment Network,联合一批经严格审核的 RL 环境公司,为客户基于自有数据和领域定制 RL 环境。合作方直接对接客户构建环境,Baseten 仍负责训练与推理。Baseten 还计划开源一批前沿质量环境及审计、训练方法。
我们找到了那些溜走的 1 美元
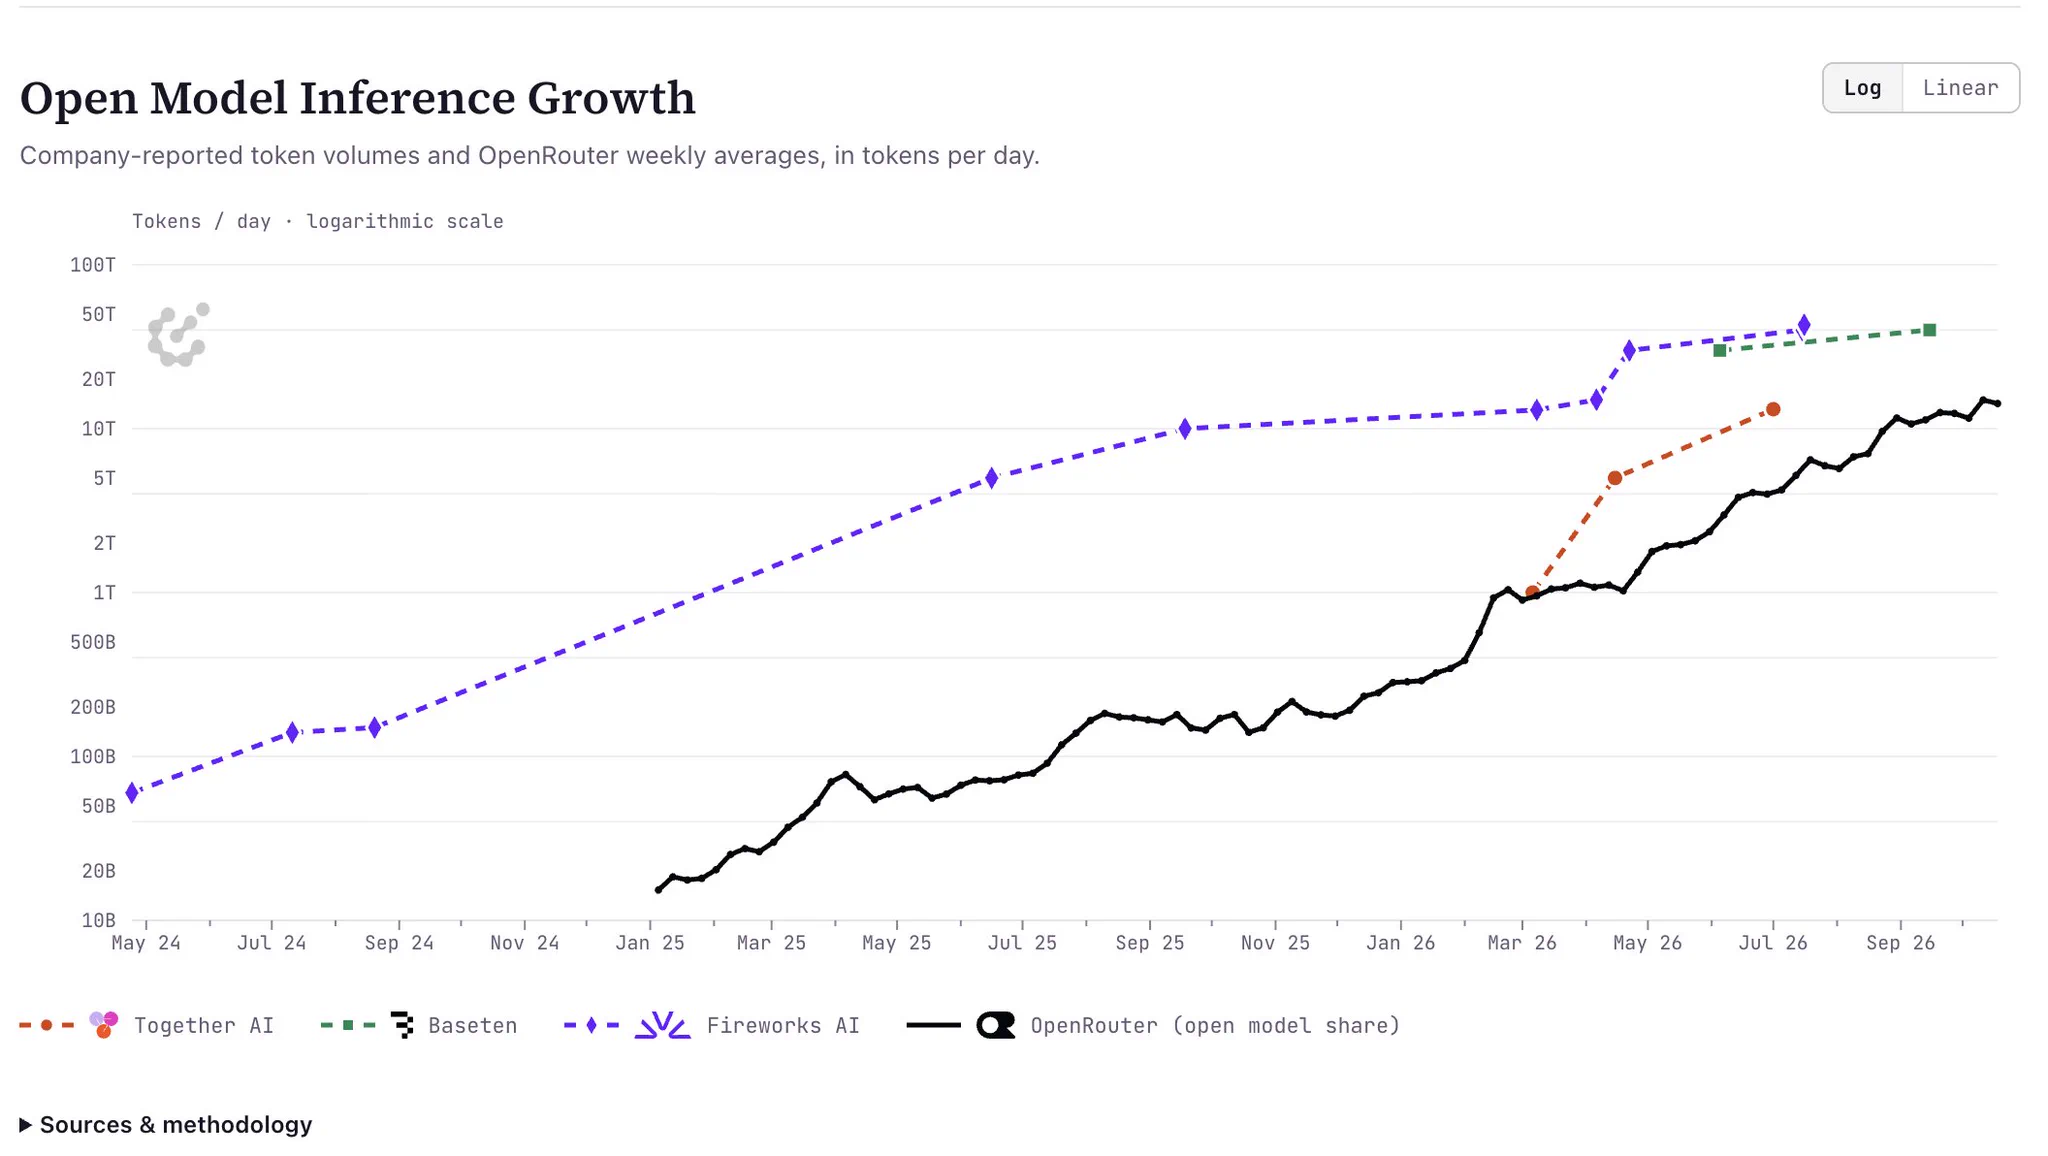
Nathan Lambert 表示 DeepSeek 在单个集群上每日服务 150T token,超过 OpenRouter、Fireworks、Together 和 BaseTen 上开源模型推理量的总和,并引用了 DeepSeek 的 DeepInfer 部署问答文档。他还根据上述公司公布的推理量报告自行重建了一张开源模型推理增长对比图。
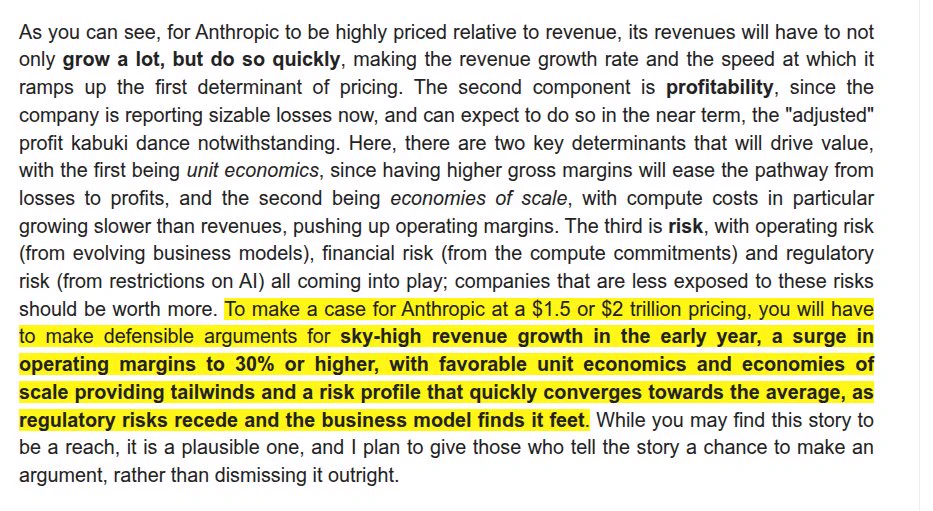
NYU 教授 Aswath Damodaran 发长文分析,Anthropic IPO 将按 run-rate 收入定价,而非基于现金流估值;H1 2026 Anthropic 亏损 $8.7B、OpenAI 亏损 $21.6B(不含非现金费用),使收益倍数法失效,ARR 成为 AI 版的互联网眼球数。
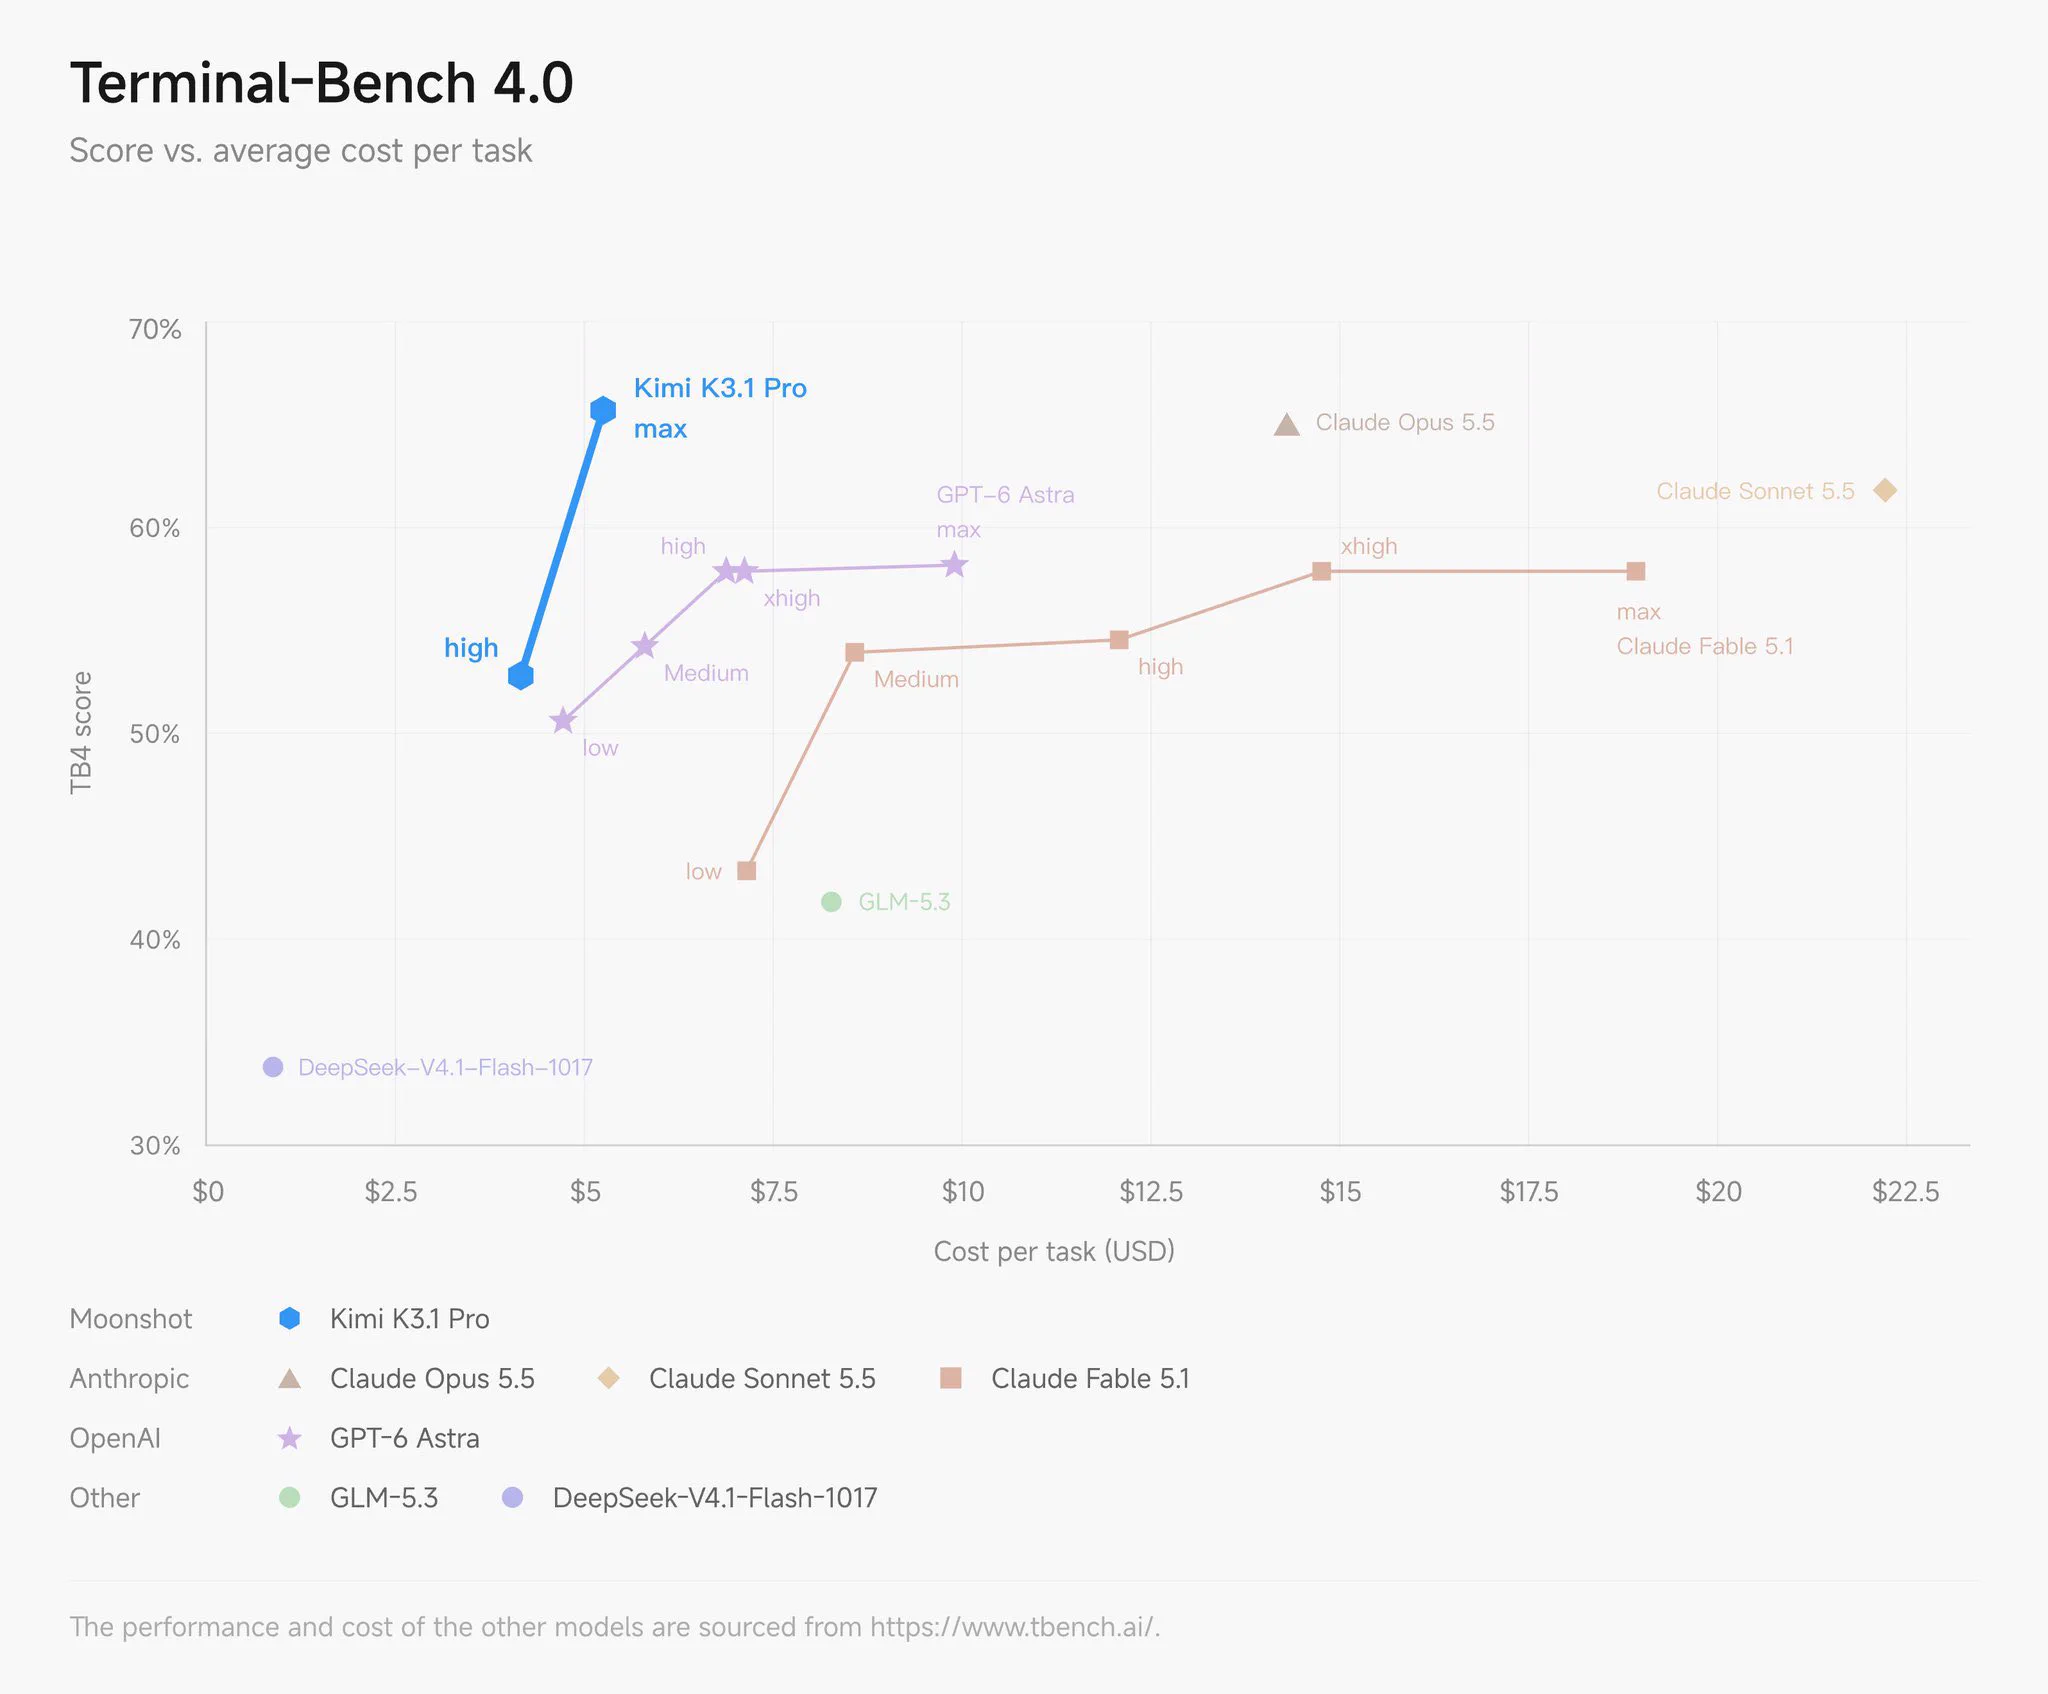
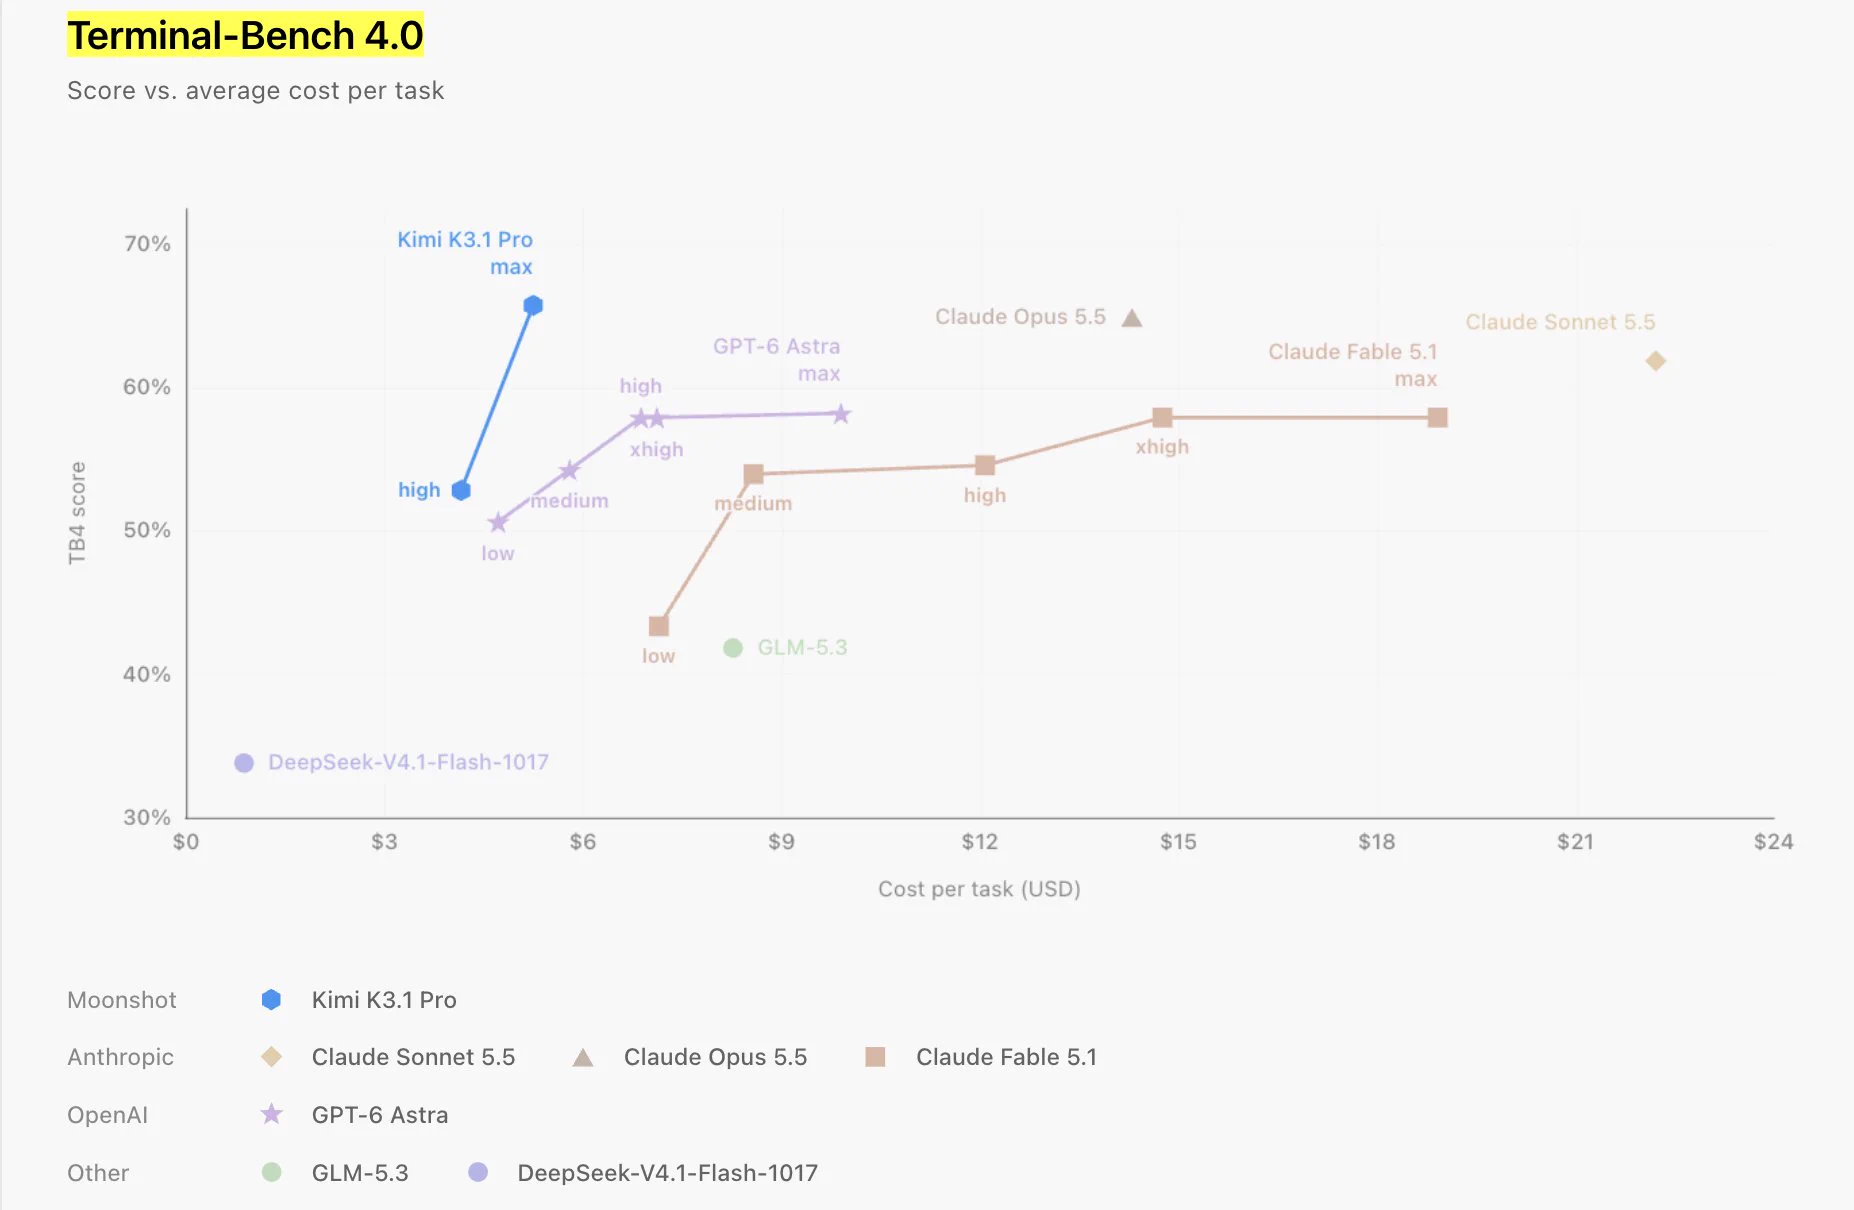
Yuchen Jin 发帖称 Kimi K3.1 Pro 已发布,应是当前最强开源模型。据其附图,在 Terminal-Bench 4.0 上 Kimi K3.1 Pro 的 TBR 得分超过 Claude Opus 5.5,且每个任务的平均成本约为其 1/3。
本文介绍了一个基于开源 OpenMinis 的手机 AI 代理项目,该代理通过获取手机权限,能够执行清理大文件、订购高铁票、设置取件闹钟等实用操作,展示了 AI 在手机自动化方面的潜力。
我们让管理员能更好地控制内部人员如何使用 tokenmax,可以为 Effort 等级(与能力和成本相关)设置下限和上限。
关于 kimi k3.1 pro 基准测试的 TLDR 是,看起来他们搞定了自己的 RL,最初发布的版本是一个非常令人印象深刻的基座模型,后训练较轻。中国在能力提升方面确实跟得很紧。
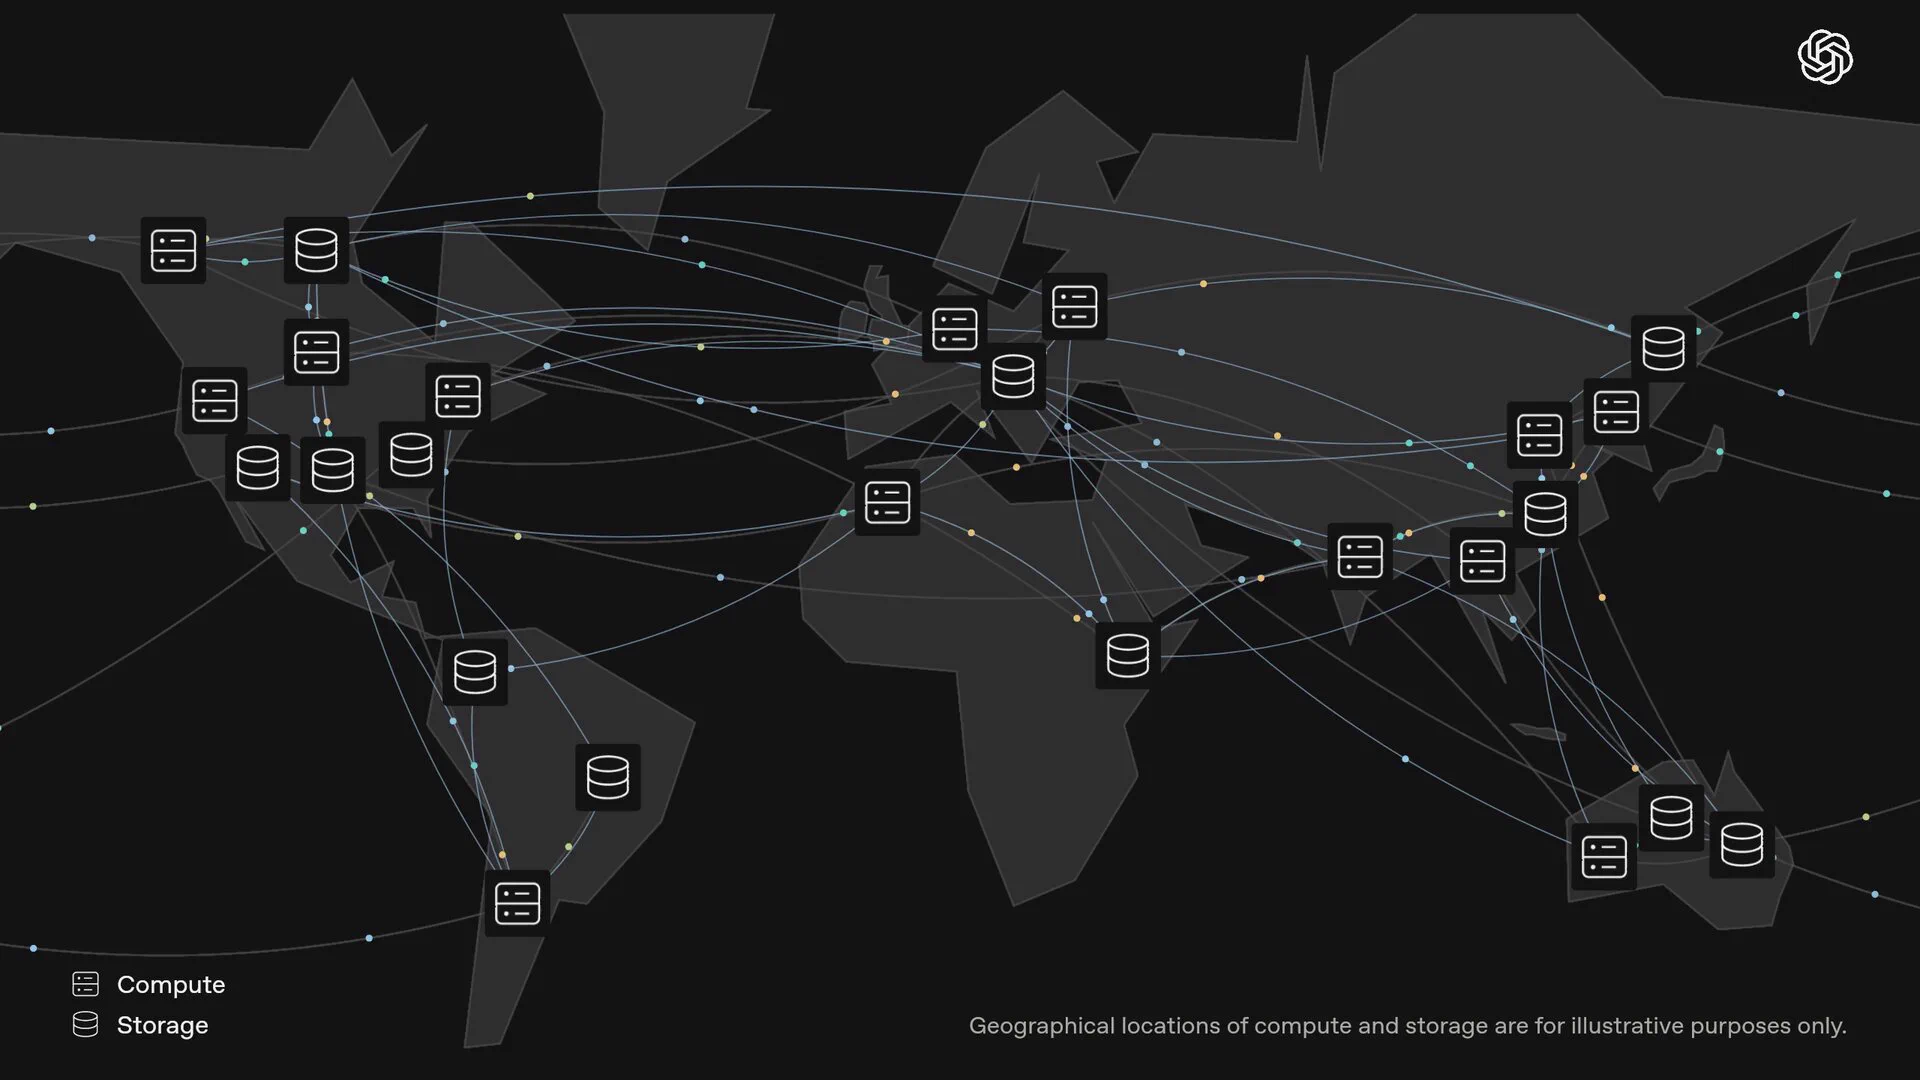
我们为 40 个地理区域的超过 12 亿用户提供毫秒级的数据服务。 为达到这一规模,我们与 @AzureCosmosDB 密切合作优化存储架构,全球中位读取延迟改善了 12 倍。
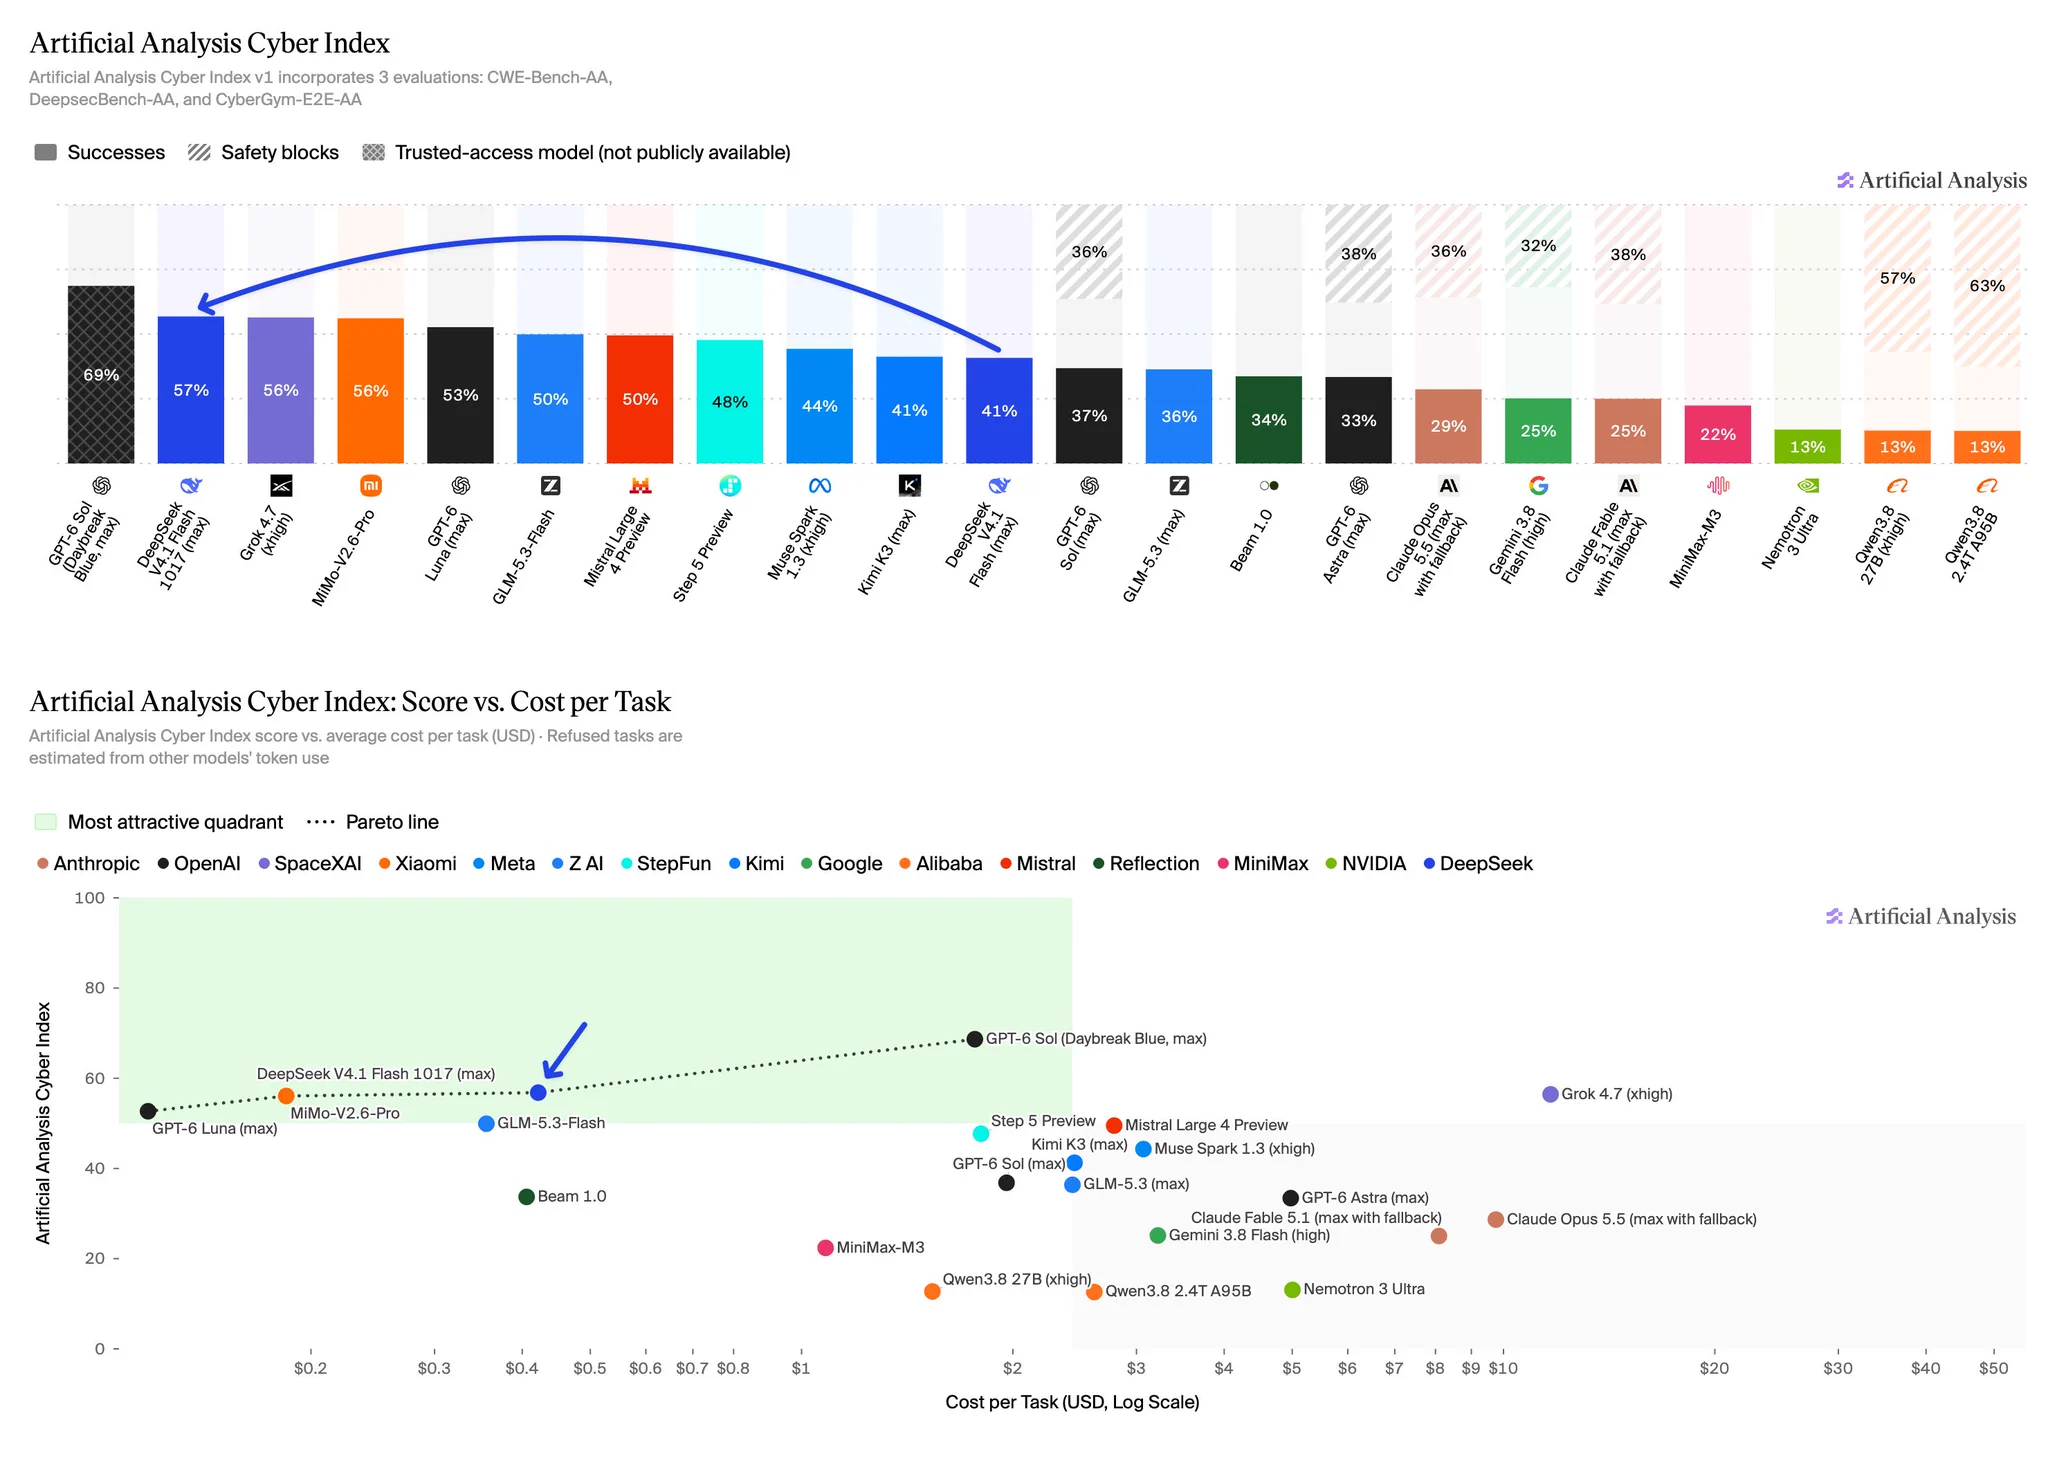
DeepSeek V4.1 Flash 1017 在 Artificial Analysis Cyber Index 得分 57%,成为排名第一的开放可用模型,总分位列第二,比前代提升 16 点,其中 CyberGym-E2E-AA 从 23% 升至 76%。
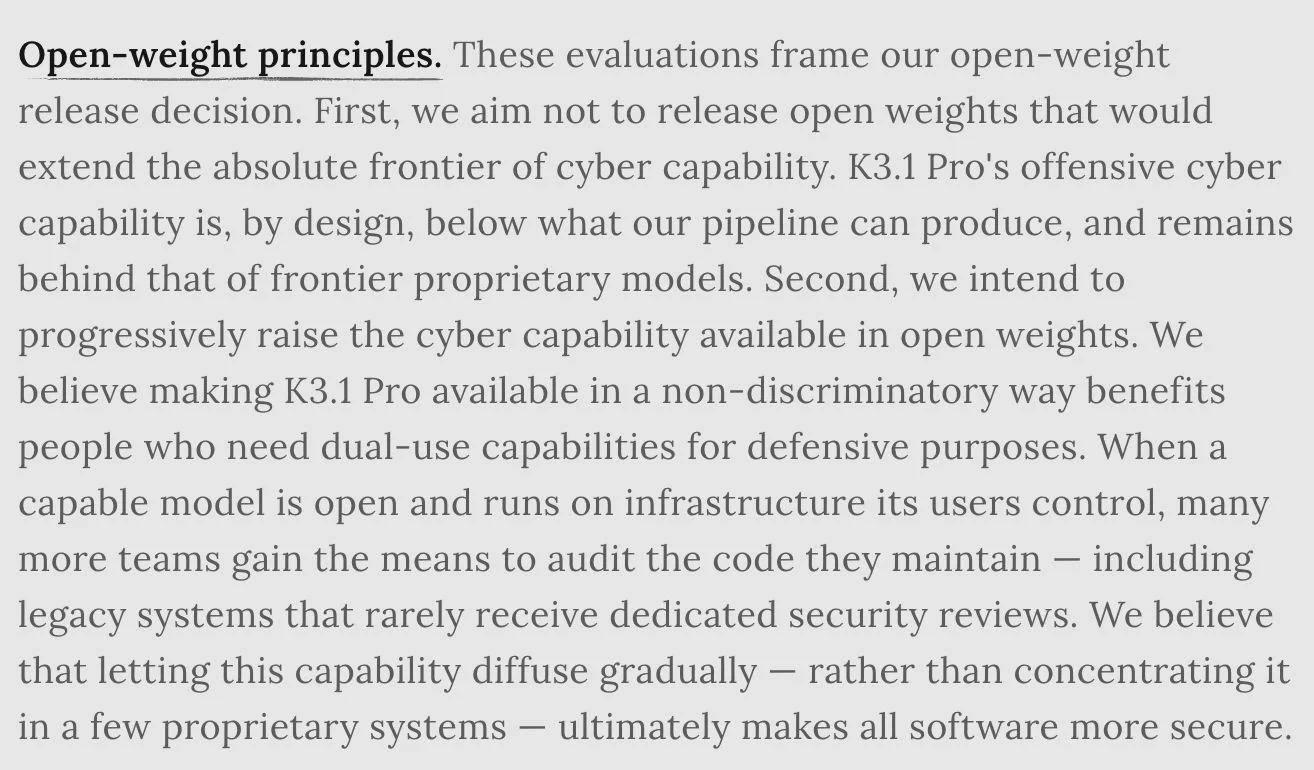
月之暗面发布 Kimi K3.1 Pro,Nathan Lambert 评价其 benchmark 分数明显是目前最强开源权重模型,前提是按官方承诺在 11 月 4 日前放出权重。
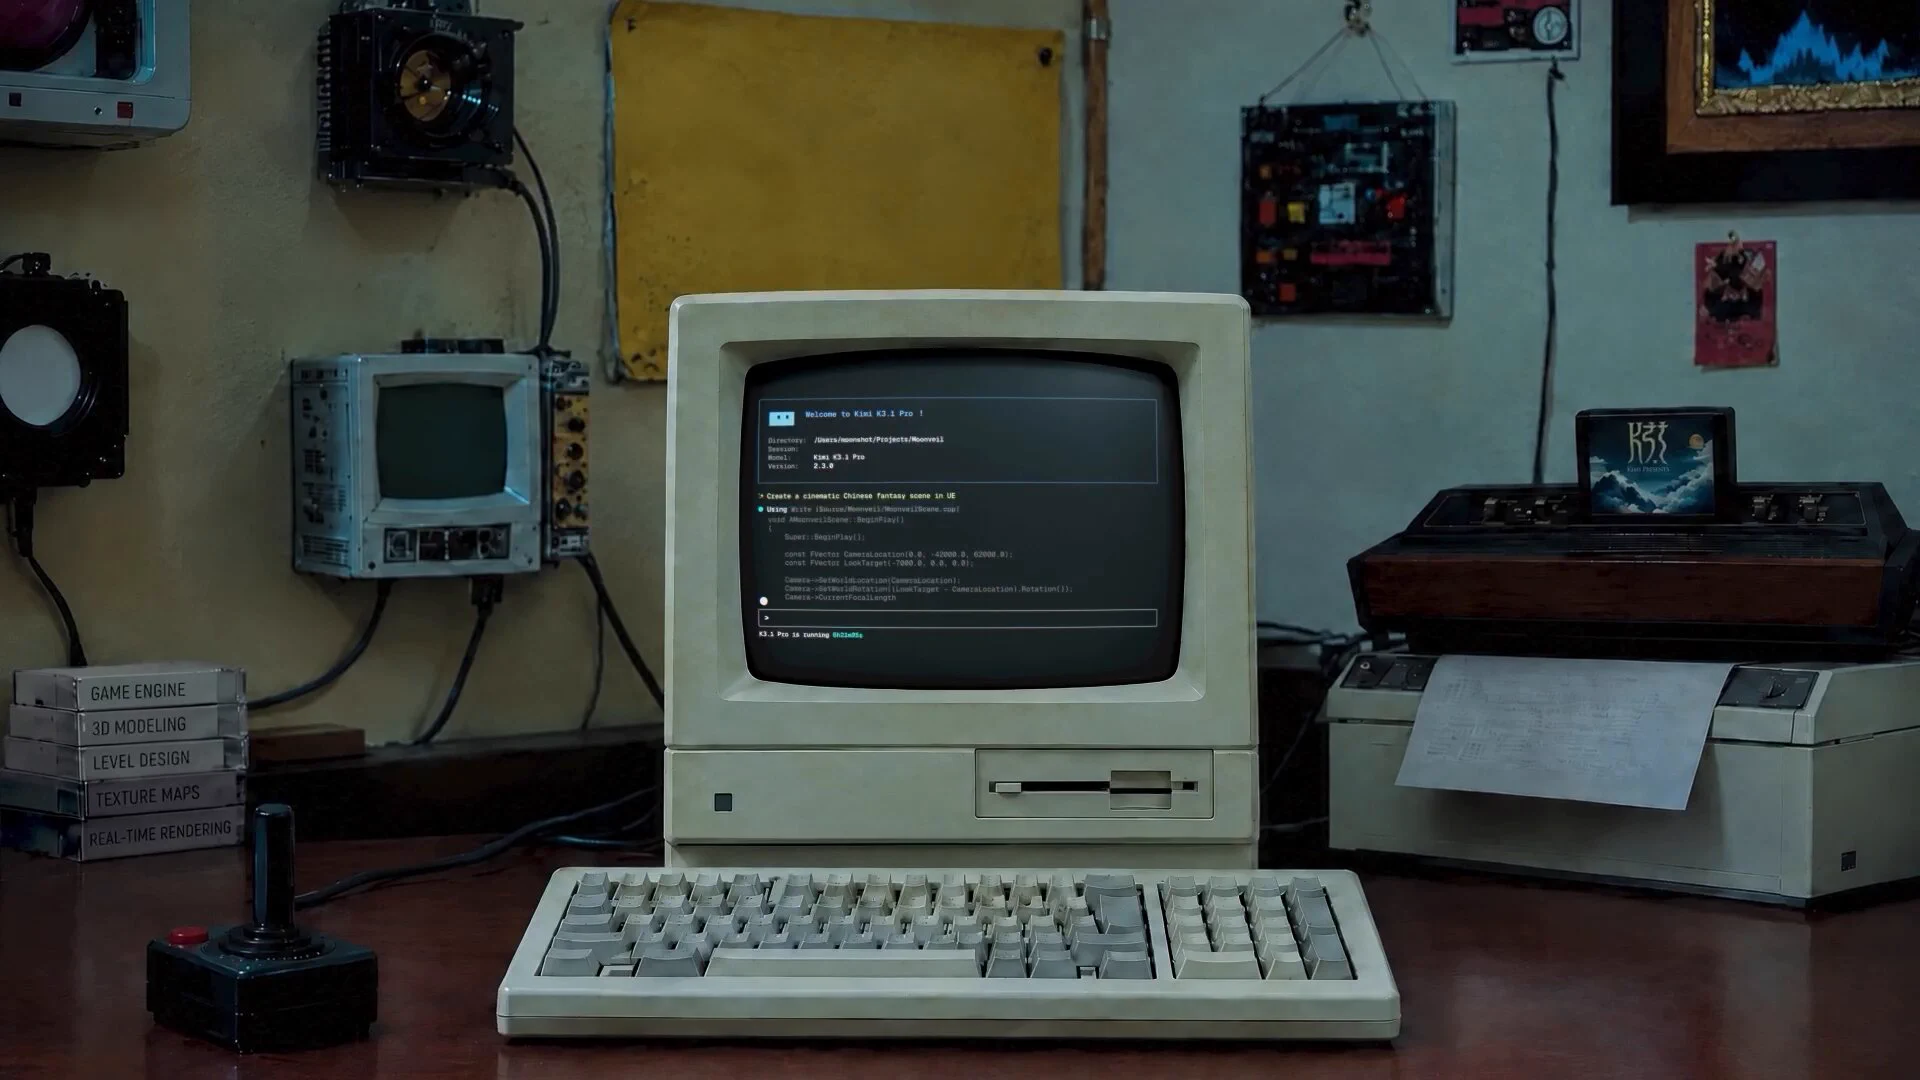
认识 Kimi K3.1 Pro,我们迄今最强的 3T 级模型。