2026-10-22
“说我们放弃前沿错得离谱!”皮查伊全力开火:宁可少赚云业务几十亿,也要把算力抢回 DeepMind;反问奥特曼:ChatGPT 难道不是缝合怪?
在《Big Technology Podcast》中,皮查伊强硬反驳了 Google 退出 AI 前沿竞争的传言,强调公司正在主动牺牲云业务利润,将算力优先分配给 DeepMind 进行前沿研发,并批评了将第三方智能体硬塞入 ChatGPT 的做法。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
在《Big Technology Podcast》中,皮查伊强硬反驳了 Google 退出 AI 前沿竞争的传言,强调公司正在主动牺牲云业务利润,将算力优先分配给 DeepMind 进行前沿研发,并批评了将第三方智能体硬塞入 ChatGPT 的做法。
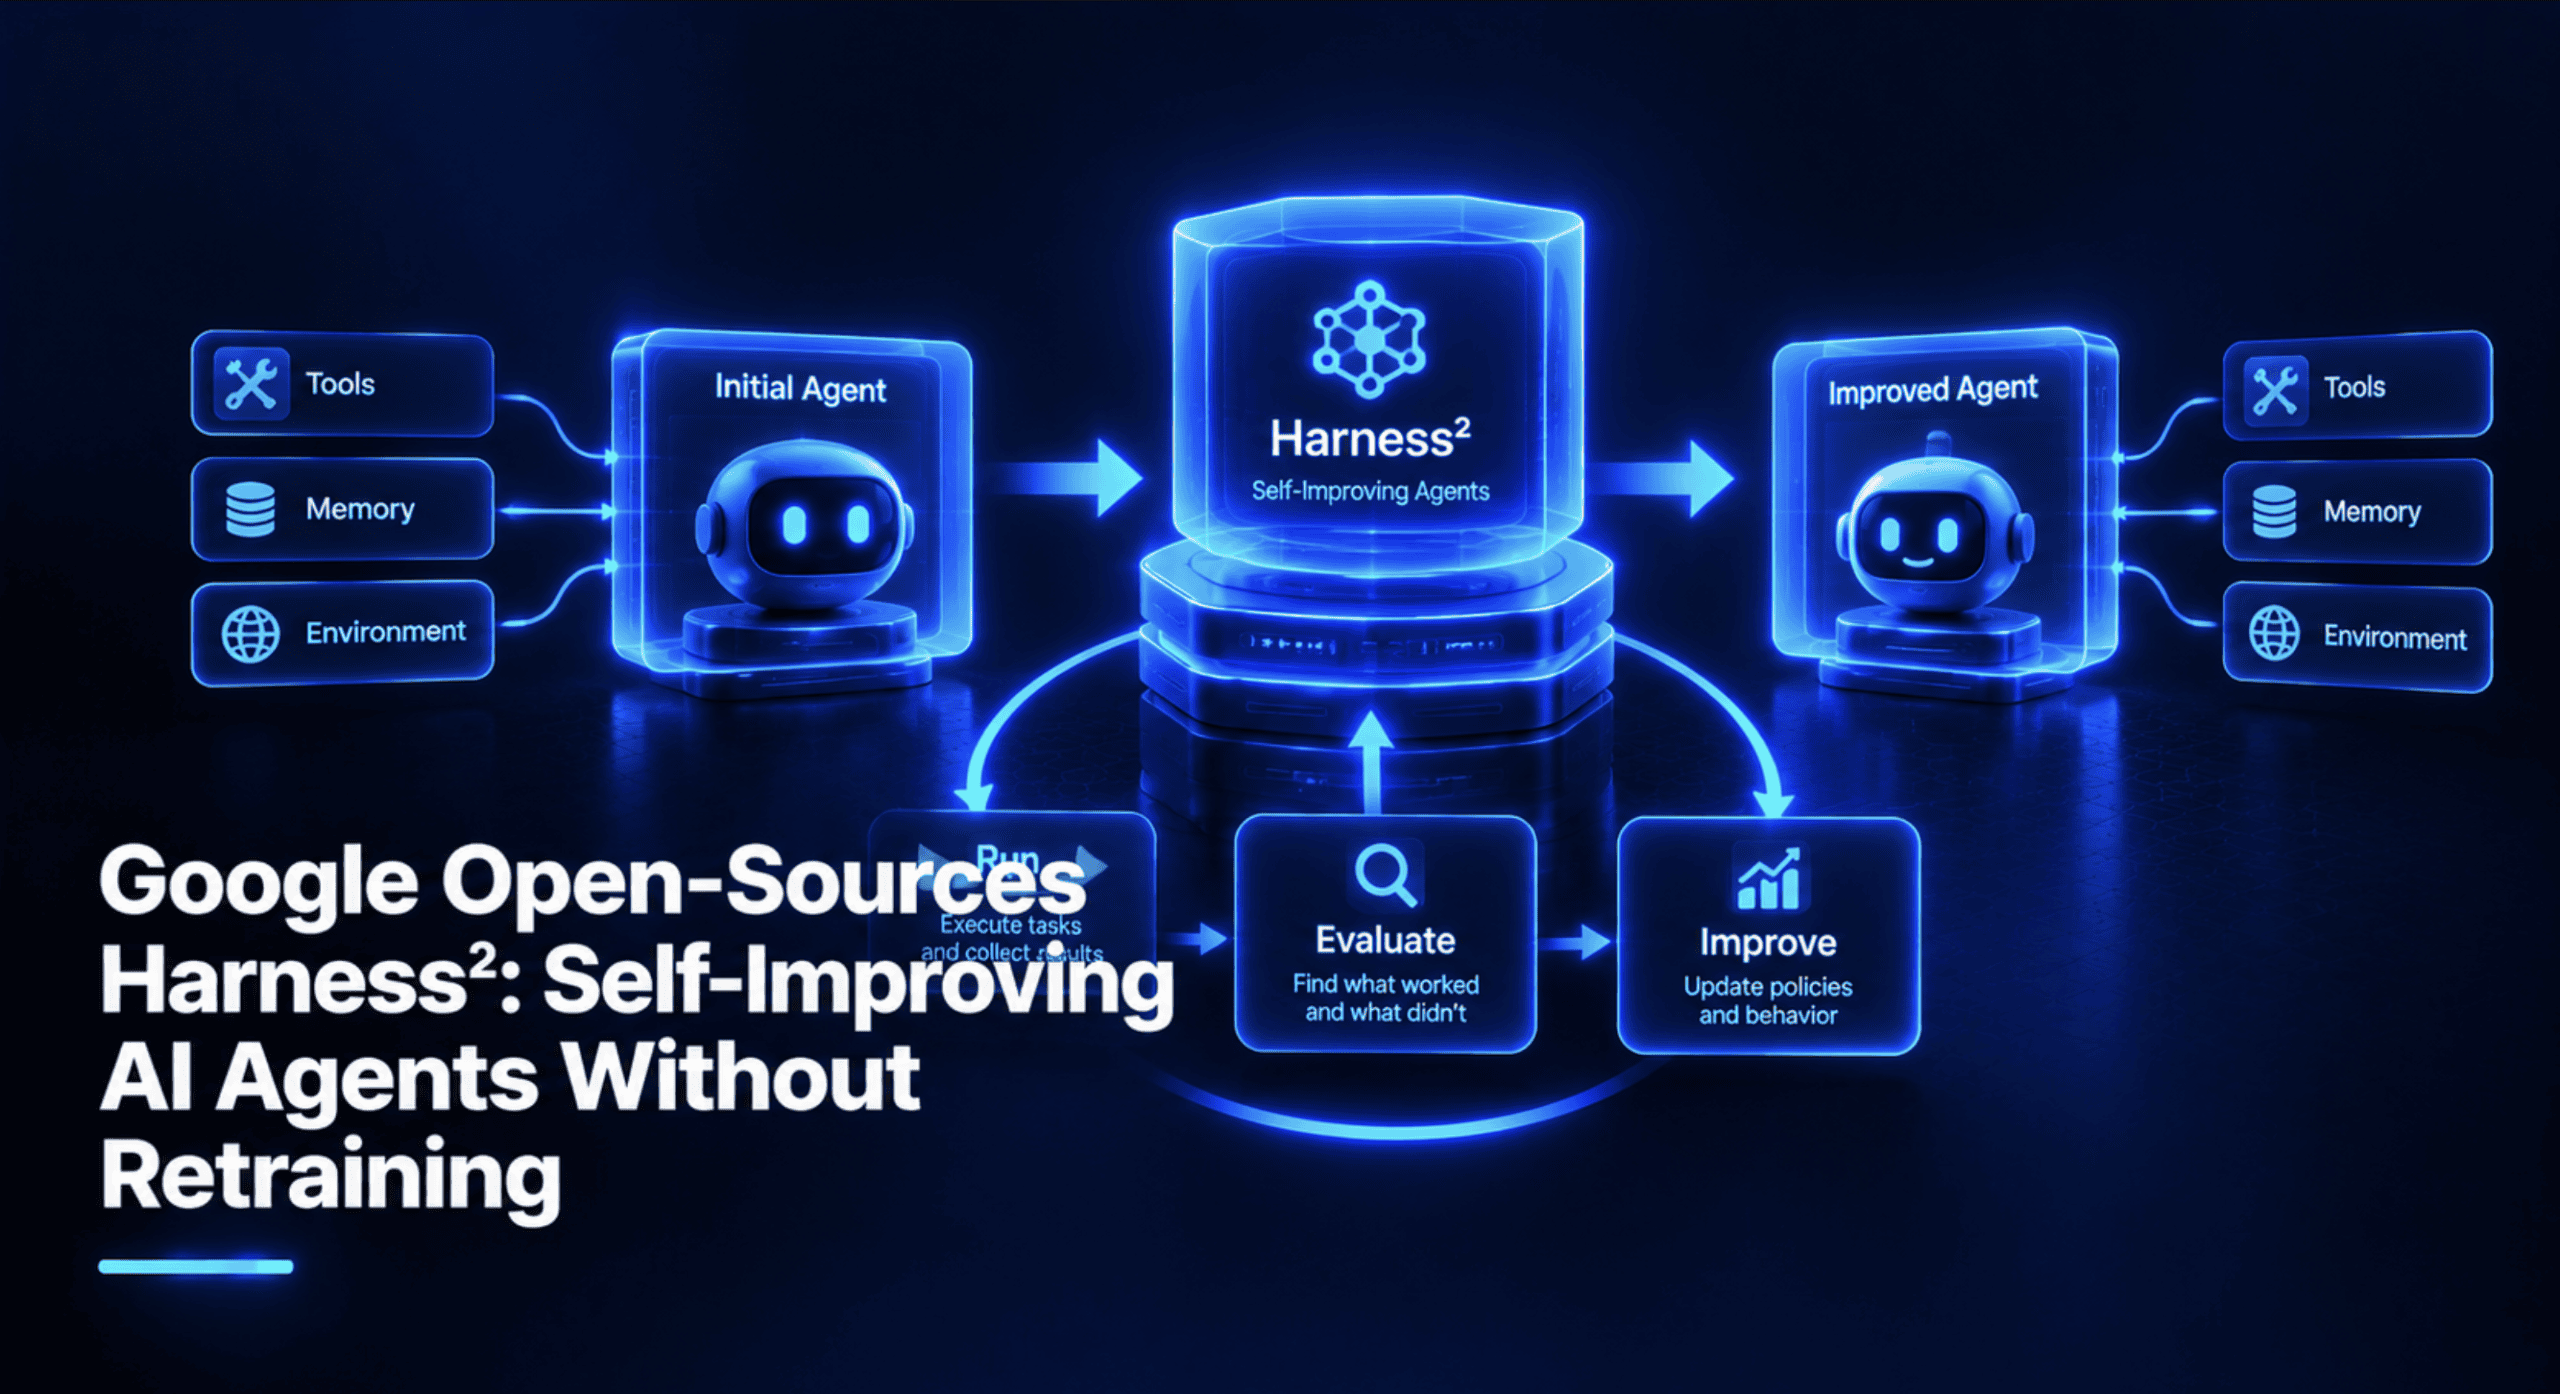
Harness² 是 Google Research 推出的框架,可让 AI 智能体通过反复优化运行环境(harness),而非重新训练底层模型,来提升表现;它采用递归方法优化提示词、工具和记忆。
上海 AI Lab 的 RSI-Router 框架通过自进化路由和技能积累,让小模型参与复杂任务,实现性能超越纯大模型的同时,将推理成本降低 51.7%。
百度智能云一见视觉智能体接入远元集团门店巡检,应用覆盖80多个场景,巡查覆盖率提升约30倍,SOP合规水平提升30个百分点以上。一见6.0支持业务人员用自然语言描述服务步骤生成视觉AI技能,双方还计划在200家门店试点百度具身智能相机。
百度世界2026公布10+场分论坛,聚焦AI驱动组织跃迁、AI办公与知识工作、技术·行业·生态三个方向,大会将于11月12日在北京举行。
IT之家 10 月 22 日消息,当地时间周二,Anthropic 平台工程团队负责人 Katelyn Lesse 在 Grafana Labs 举办的 ObservabilityCON 活动上透露,“就我们团队及我们的系统开发和维护工作而言,我们所有代码都是 Claude 写的,真的是全部。
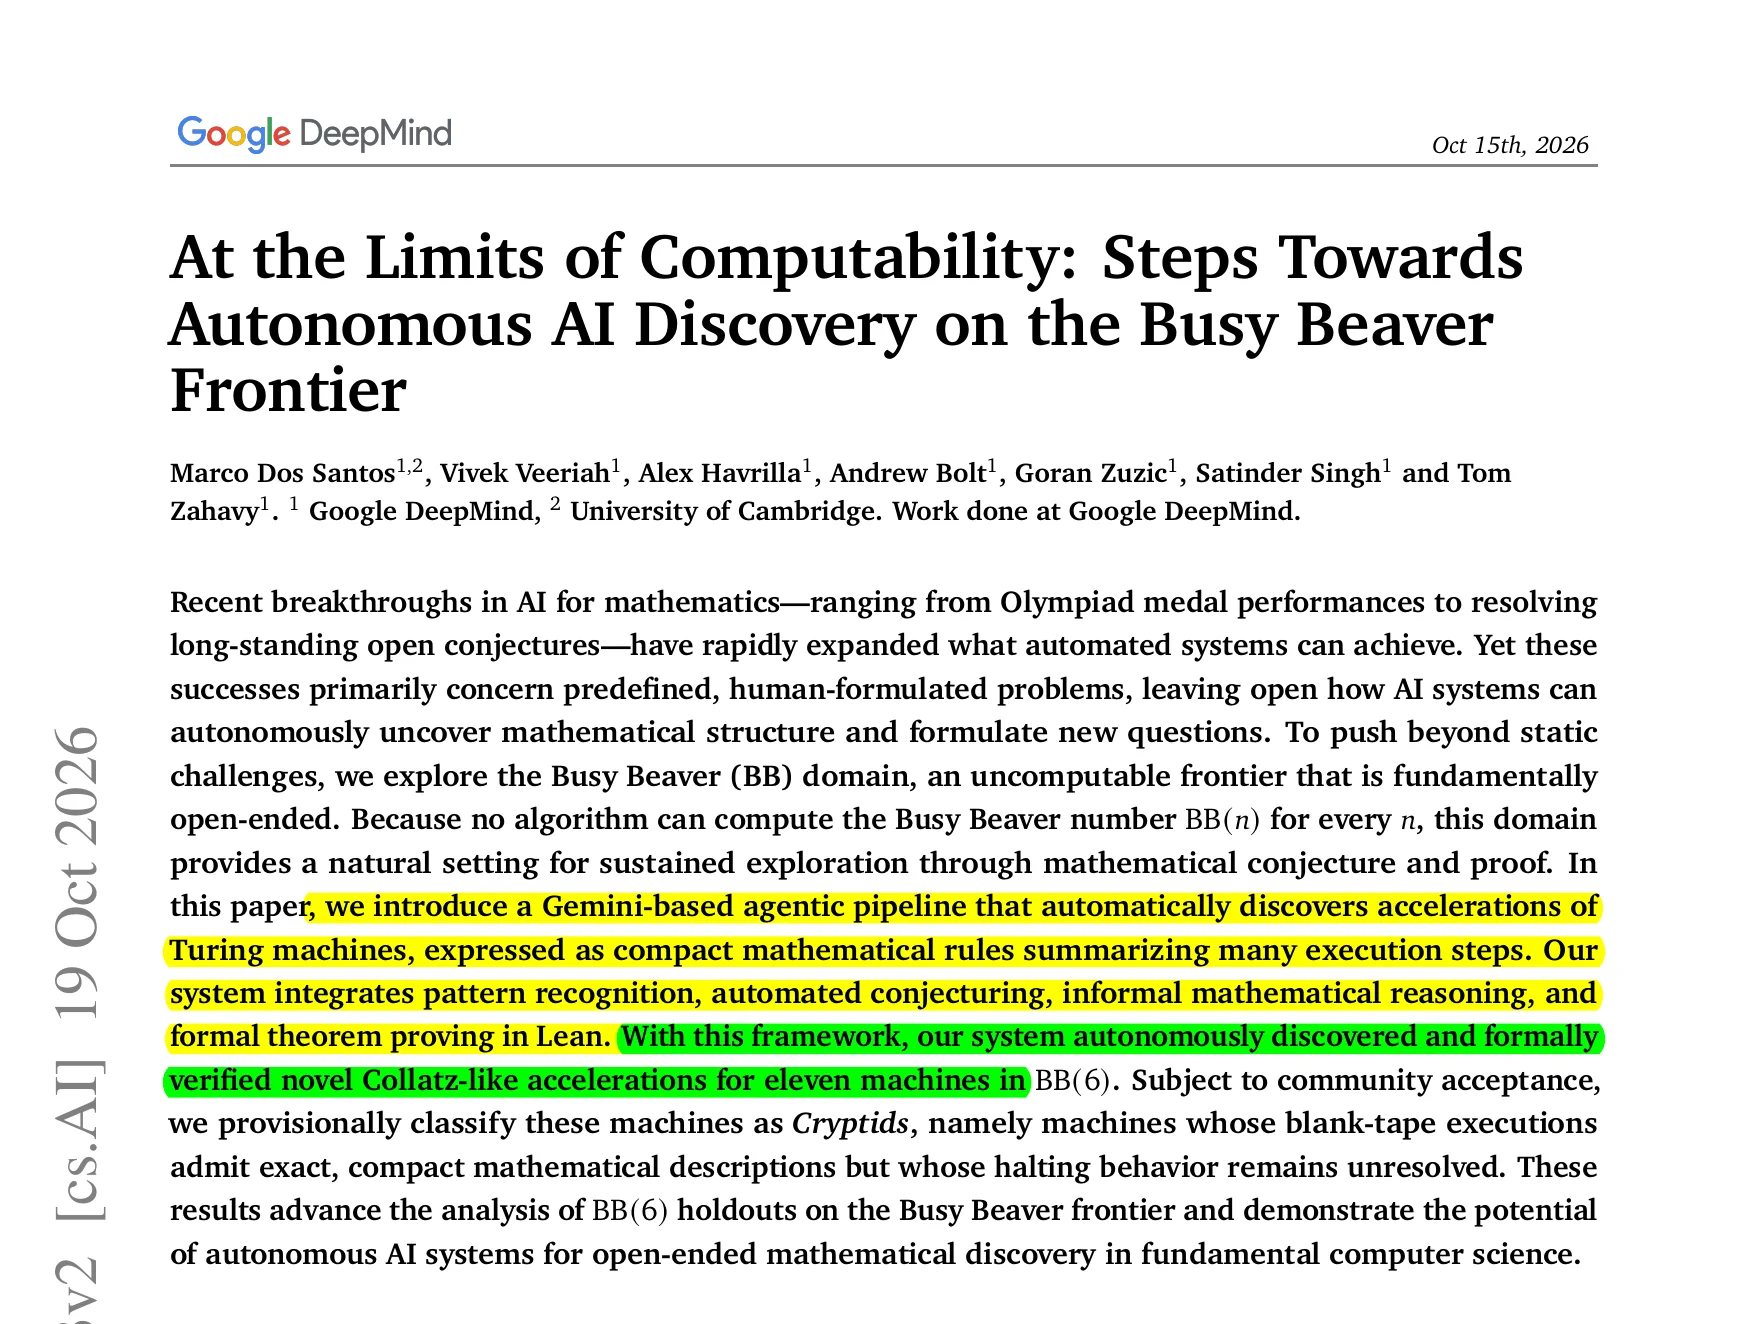
Google DeepMind 与 Cambridge 的论文展示了一个基于 Gemini 的智能体能够自主发现新数学,为 11 台此前无任何公开分析的 Busy Beaver 图灵机找到并用 Lean 验证了精确规则。该智能体先在模拟器中测试边界情况,起草非形式化证明,再用 Lean 证明检查器完成形式化证明。
Nathan Lambert 认为开源模型在网络防御中能起到平衡作用,当前发展轨迹比人们想象的要好得多。他指出开源权重并非不会被用于网络攻击,所有可能的 AI 发展轨迹在他看来都会伴随大量网络安全事件。他试图挑战围绕网络与开源模型的宿命论式 AI 末日论调,因为网络社区中有可信声音认为开源模型是未来 12 个月维持局面的重要力量。
Symantec 研究人员通过蜜罐截获一个把大语言模型嵌入核心的攻击智能体,它会劫持互联网上无防护的模型端点,自主扫描目标、利用服务器漏洞、窃取数据库凭据并安装挖矿程序,最多连续执行 100,000 步,算力费用由被劫持模型的主人承担。
Google 与 Voltus 宣布在 PJM 电网争取 1 GW 虚拟电厂容量,是 6 月公布的 100 MW 目标的十倍。虚拟电厂通过软件调控家庭和企业用电为数据中心腾出电力空间;Voltus 要求客户承诺通过 2040 年持续提供减负或电池供电,且 Google 承诺 100% 无碳容量。
AI Master 演示 Claude Cowork 在文件、计划、研究和连接应用中的工作流,提供了实用的复核节点,但功能主张未经独立核实,且较多推广打断了教程。
Claude Duet 是 Anthropic 推出的一款强大常驻个人智能体,擅长整理知识工作和自动化任务,但目前尚未全面集成自定义连接器,也不具备语音功能。
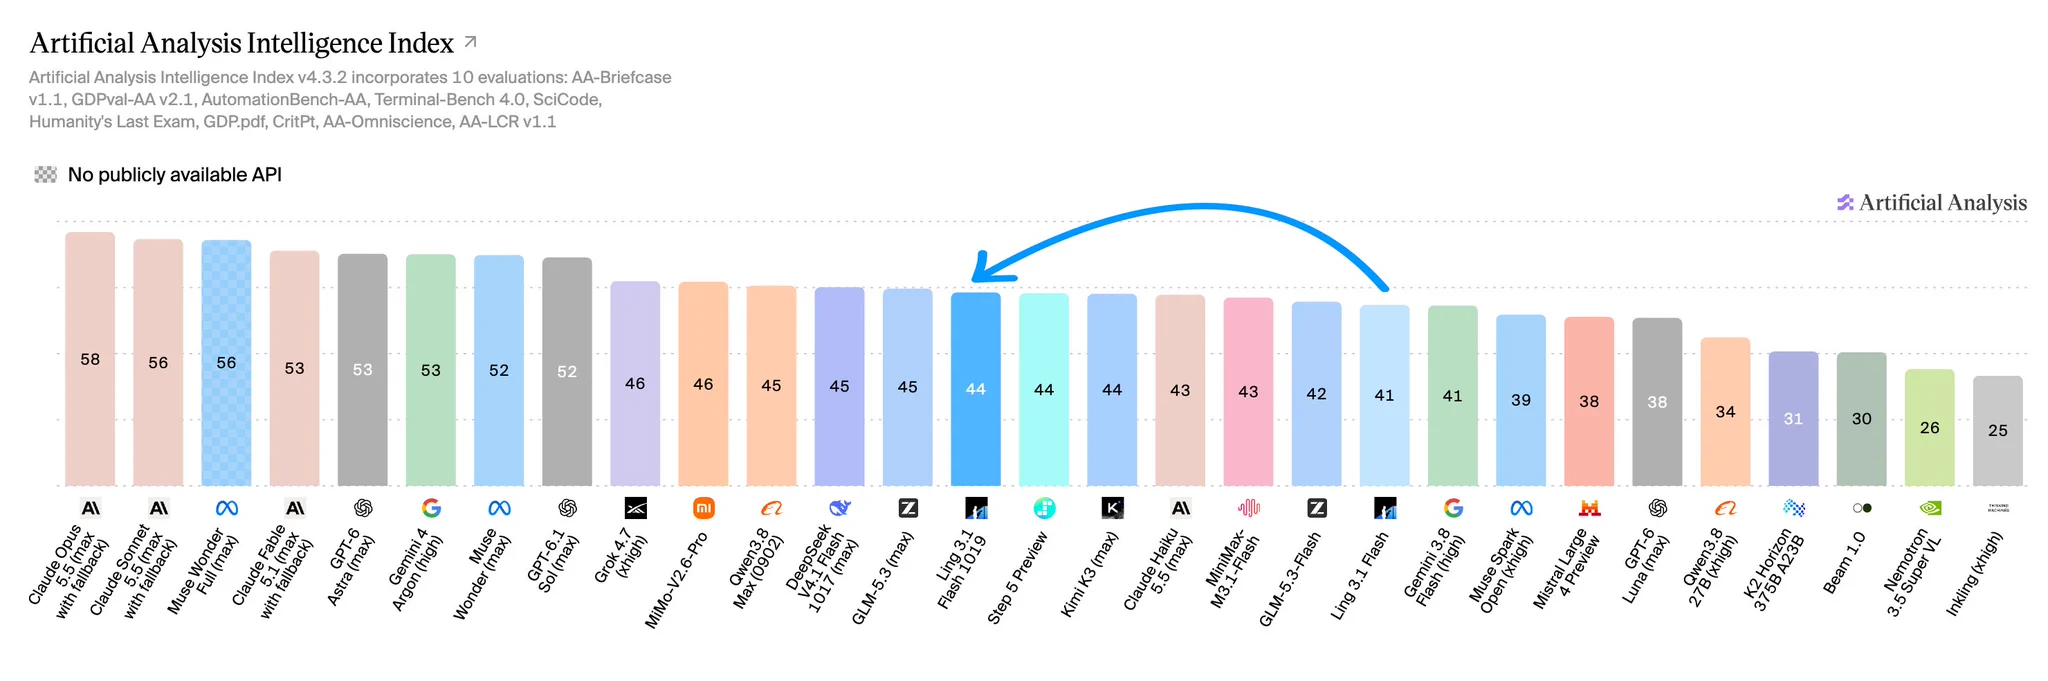
推出 Ling-3.1-flash-1019 🚀 它在 Artificial Analysis Intelligence Index 上得分 44,高于 Ling-3.1-flash 的 41。智能体工作方面有所提升:AA-Briefcase 约 1400→1524 Elo,AutomationBench-AA 62%→68%。
判断 Personal Agent 好不好用,不在于用的哪个模型,而在于你拥有的账号与它能提供的服务重叠有多高。我通过测试 12 个 Agent,发现五个关键维度——记忆、信息获取、Computer Use、主动性和多端联动——决定了其上限,并分享了实际案例和工作流优化。
作者实测12个Personal Agent后提出五维评测框架,认为判断好坏的关键不在模型,而是账号与应用能否通过skill、MCP、CLI等方式接入。
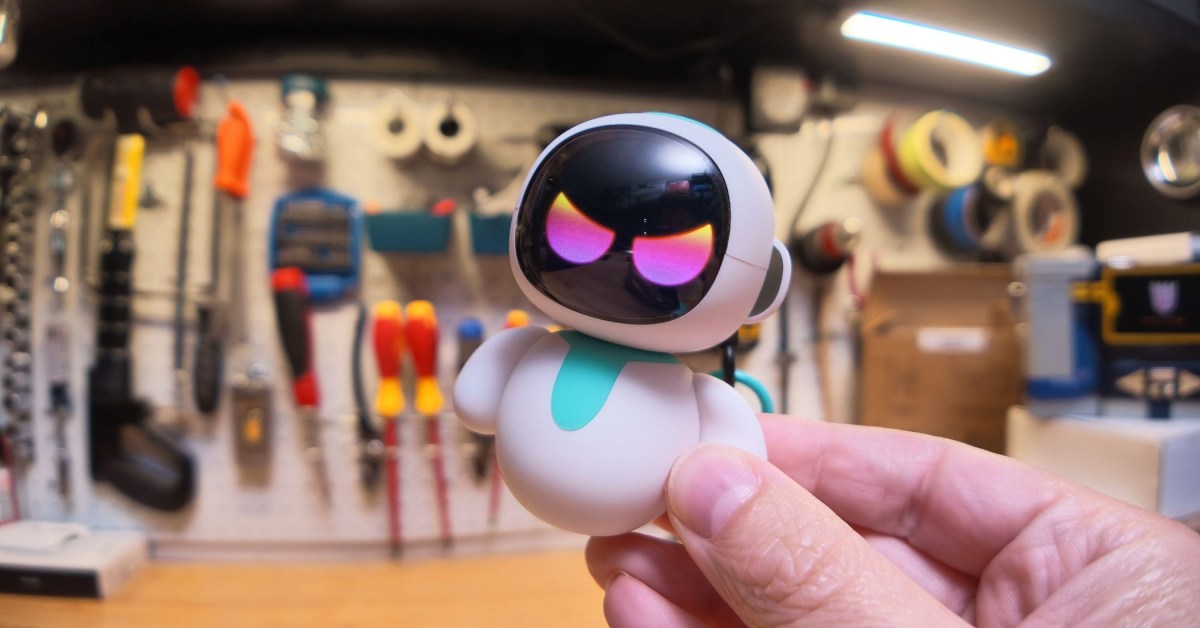
Energize Lab 就 The Verge 报道的 Eiliko 挂件机器人安全漏洞发布声明,确认核心问题属实,称已关闭后端外部访问、禁用远程修改机器人回应的接口、下线长期记忆和自定义头像功能,并承诺删除已存储的对话记录、用户画像和头像图片,还将聘请独立安全公司全面审查。
明略科技通过 Octo 平台将 AI 深度融入组织,实现 1:4 的人机比例,并用 Agent 网络重塑企业协作流程,显著提升效率。
上海交大 00 后硕博团队创立“芯生代”,提出基于 Agent 与价值驱动记忆的自进化推理引擎,旨在解决国产芯片上算子生成与推理管线优化的痛点。
Amazon 研究者提出 Span-Level Uncertainty Estimation (SLUE) 新任务及 SpanUQ 方法,利用冻结 LLM 隐藏状态配合轻量级 Probe,在单次前向传播中同时完成语义片段检测与不确定性估计,较采样法快 10-20 倍,并发布 SpanUQ-Bench 基准。
Recursive_SI 发布 Flint-40B-A2B,一款由 AI 驱动的自动化研究系统 Eureka Machine 打造的本地智能体编程模型,在 SWE-Bench Pro v2 等基准测试中表现优异,推理速度高达每秒 125+ Token,并兼容多种本地硬件平台。
Anthropic 最新模型(含 Claude Mythos 5.1、Claude Opus 5.5、Claude Sonnet 5.5 等)的所有文本输出都内置 AI 水印,覆盖 Claude Desktop、Claude Code 和 API,目的是遵守欧盟 AI 法案。
LLM API 的实际成本取决于缓存率、输出比例和定价门槛,而不只是醒目的每 token 价格;本文比较了 GPT-5.6 Sol、GPT-6.1 Sol、Claude Opus 5.5 等模型经核实的价格,找出适合不同工作负载的高性价比选择。
研究员借助 GPT-5.6 Sol 成功挖掘出 PHP 中的重大安全漏洞,证明黑客可以利用内存管理错误远程执行代码,导致全球大量网站紧急停服打补丁。
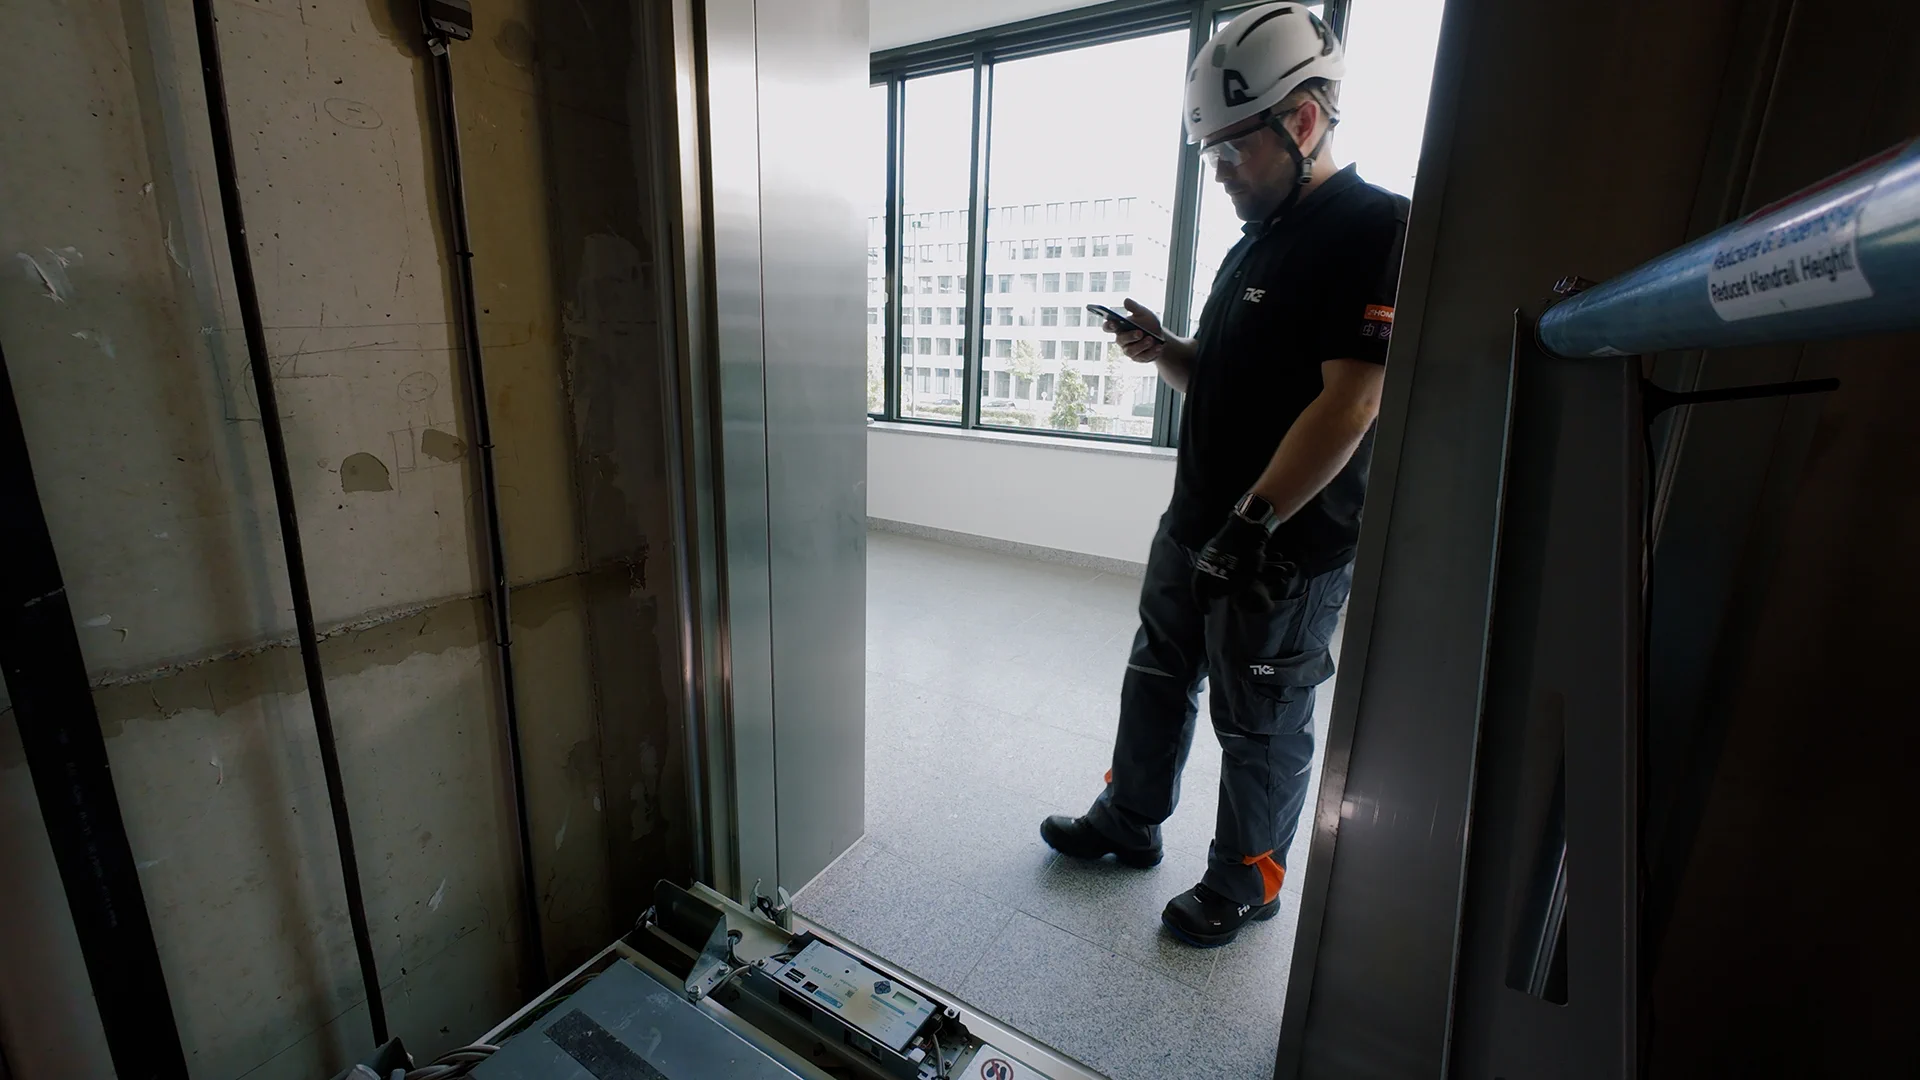
让超过一百万部电梯和自动扶梯平稳运行绝非易事。 今天在科隆,我了解到 TK Elevator 如何利用我们的技术,帮助其服务技师获取数十年积累的共享知识,简化流程,让他们能少花时间查找答案,多花时间保障人们顺畅出行。
在混合模型中,大批量处理时的投机解码会变得低效,因为 Mamba 层必须为每个草稿 token 完整复制状态,造成过多内存流量,抵消了更快解码带来的收益。
智谱的 ZCode 推出 Work 模式,将 AI 编程能力扩展到办公领域,支持文档分析、表格处理和 PPT 生成,并提供多 Agent 工作流功能,成为新一代办公工具的有力竞争者。
蚂蚁数科发布决策模型 LingDT-Decision-1.0,提供 4B 和 27B 两个版本,已在 DTMaaS 平台上线并限时免费体验。该模型首创原生多选与按序决策(DAG)能力,在 23 项开源评测基准中超过 Microsoft-Decision-1、Jev 1.13 等决策模型,27B 版本在同参数模型中准确率最高。
作者 A. Chen 在 ChinaTalk 征文中获奖的这篇报道,实地走访北京五道口的研究者与创业者,梳理机器人数据收集的三代技术:2017 年起的遥操作、2024 年 Stanford UMI 提出的同构外骨骼。
OpenAI 与 PerturbAI、Scripps Research 合作,用数千个基于 GPT-Rosalind 的智能体在 32 分钟内完成对数百万小鼠细胞的全脑 CRISPR 图谱分析,人工估计需数月至一年。
CrowdStrike CEO George Kurtz 解释了 AI 智能体如何加速攻击、防守方为何需要同等能力的模型,以及专有遥测数据、数字孪生和身份管控如何增强企业安全。