2026-10-22
Claude Cowork 2.0 使用入门:2026 工作流自动化完整指南
AI Master 演示 Claude Cowork 在文件、计划、研究和连接应用中的工作流,提供了实用的复核节点,但功能主张未经独立核实,且较多推广打断了教程。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
AI Master 演示 Claude Cowork 在文件、计划、研究和连接应用中的工作流,提供了实用的复核节点,但功能主张未经独立核实,且较多推广打断了教程。
Claude Duet 是 Anthropic 推出的一款强大常驻个人智能体,擅长整理知识工作和自动化任务,但目前尚未全面集成自定义连接器,也不具备语音功能。
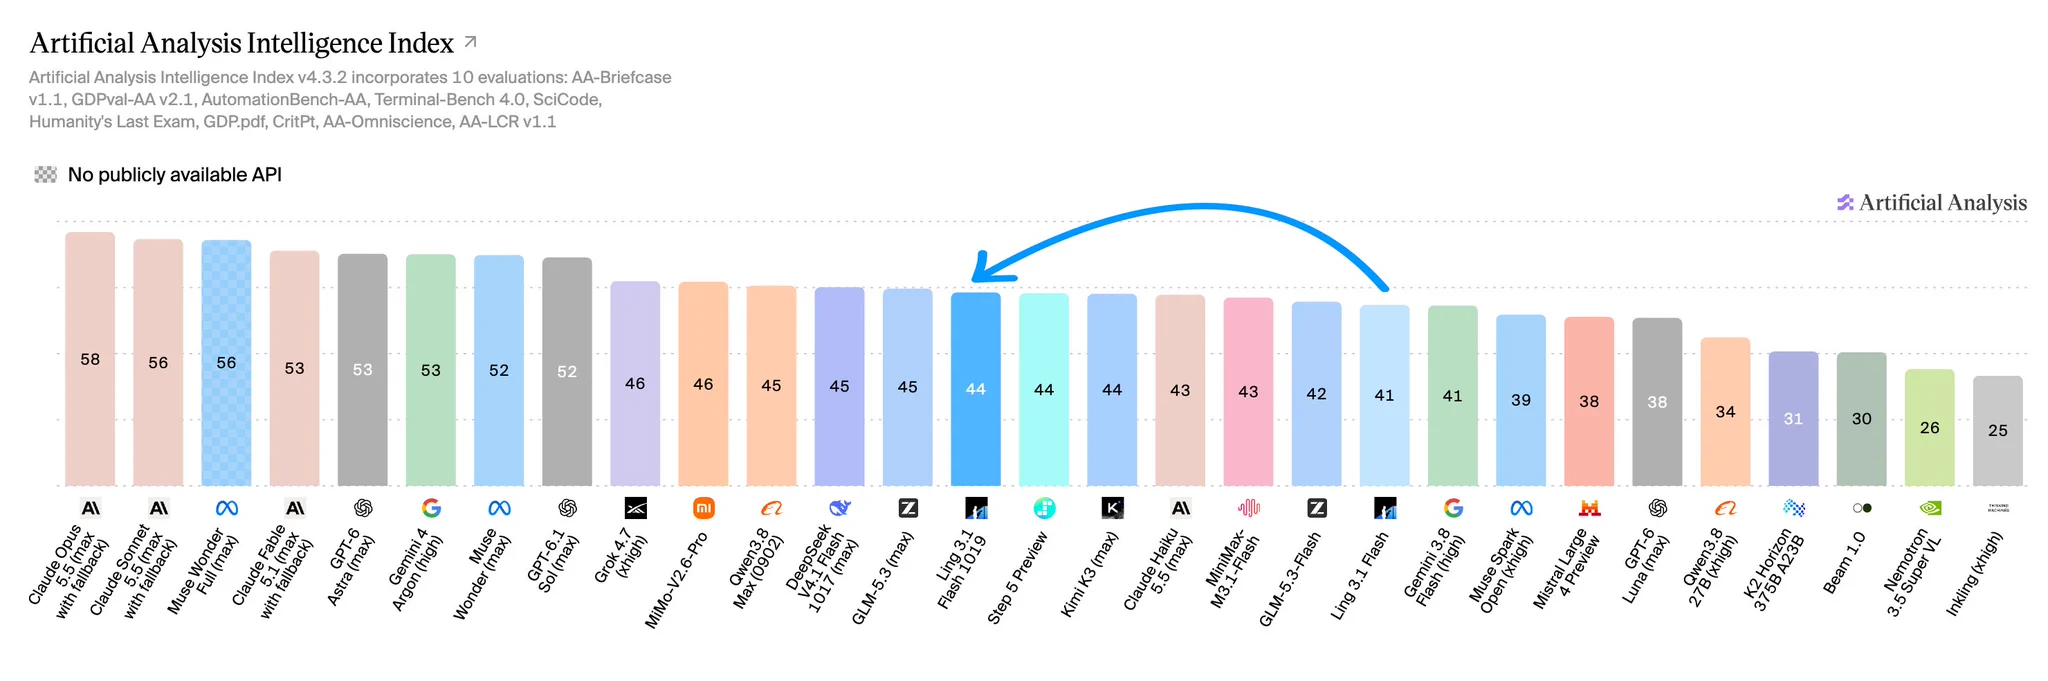
推出 Ling-3.1-flash-1019 🚀 它在 Artificial Analysis Intelligence Index 上得分 44,高于 Ling-3.1-flash 的 41。智能体工作方面有所提升:AA-Briefcase 约 1400→1524 Elo,AutomationBench-AA 62%→68%。
判断 Personal Agent 好不好用,不在于用的哪个模型,而在于你拥有的账号与它能提供的服务重叠有多高。我通过测试 12 个 Agent,发现五个关键维度——记忆、信息获取、Computer Use、主动性和多端联动——决定了其上限,并分享了实际案例和工作流优化。
作者实测12个Personal Agent后提出五维评测框架,认为判断好坏的关键不在模型,而是账号与应用能否通过skill、MCP、CLI等方式接入。
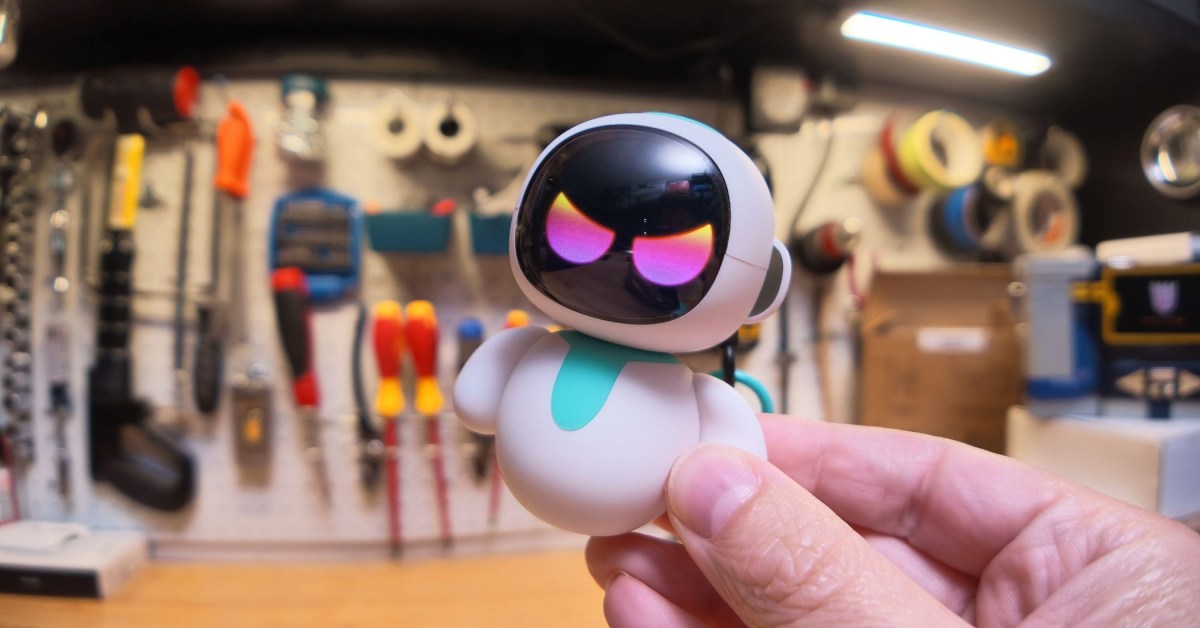
Energize Lab 就 The Verge 报道的 Eiliko 挂件机器人安全漏洞发布声明,确认核心问题属实,称已关闭后端外部访问、禁用远程修改机器人回应的接口、下线长期记忆和自定义头像功能,并承诺删除已存储的对话记录、用户画像和头像图片,还将聘请独立安全公司全面审查。
明略科技通过 Octo 平台将 AI 深度融入组织,实现 1:4 的人机比例,并用 Agent 网络重塑企业协作流程,显著提升效率。
上海交大 00 后硕博团队创立“芯生代”,提出基于 Agent 与价值驱动记忆的自进化推理引擎,旨在解决国产芯片上算子生成与推理管线优化的痛点。
Amazon 研究者提出 Span-Level Uncertainty Estimation (SLUE) 新任务及 SpanUQ 方法,利用冻结 LLM 隐藏状态配合轻量级 Probe,在单次前向传播中同时完成语义片段检测与不确定性估计,较采样法快 10-20 倍,并发布 SpanUQ-Bench 基准。
Recursive_SI 发布 Flint-40B-A2B,一款由 AI 驱动的自动化研究系统 Eureka Machine 打造的本地智能体编程模型,在 SWE-Bench Pro v2 等基准测试中表现优异,推理速度高达每秒 125+ Token,并兼容多种本地硬件平台。
Anthropic 最新模型(含 Claude Mythos 5.1、Claude Opus 5.5、Claude Sonnet 5.5 等)的所有文本输出都内置 AI 水印,覆盖 Claude Desktop、Claude Code 和 API,目的是遵守欧盟 AI 法案。
LLM API 的实际成本取决于缓存率、输出比例和定价门槛,而不只是醒目的每 token 价格;本文比较了 GPT-5.6 Sol、GPT-6.1 Sol、Claude Opus 5.5 等模型经核实的价格,找出适合不同工作负载的高性价比选择。
研究员借助 GPT-5.6 Sol 成功挖掘出 PHP 中的重大安全漏洞,证明黑客可以利用内存管理错误远程执行代码,导致全球大量网站紧急停服打补丁。
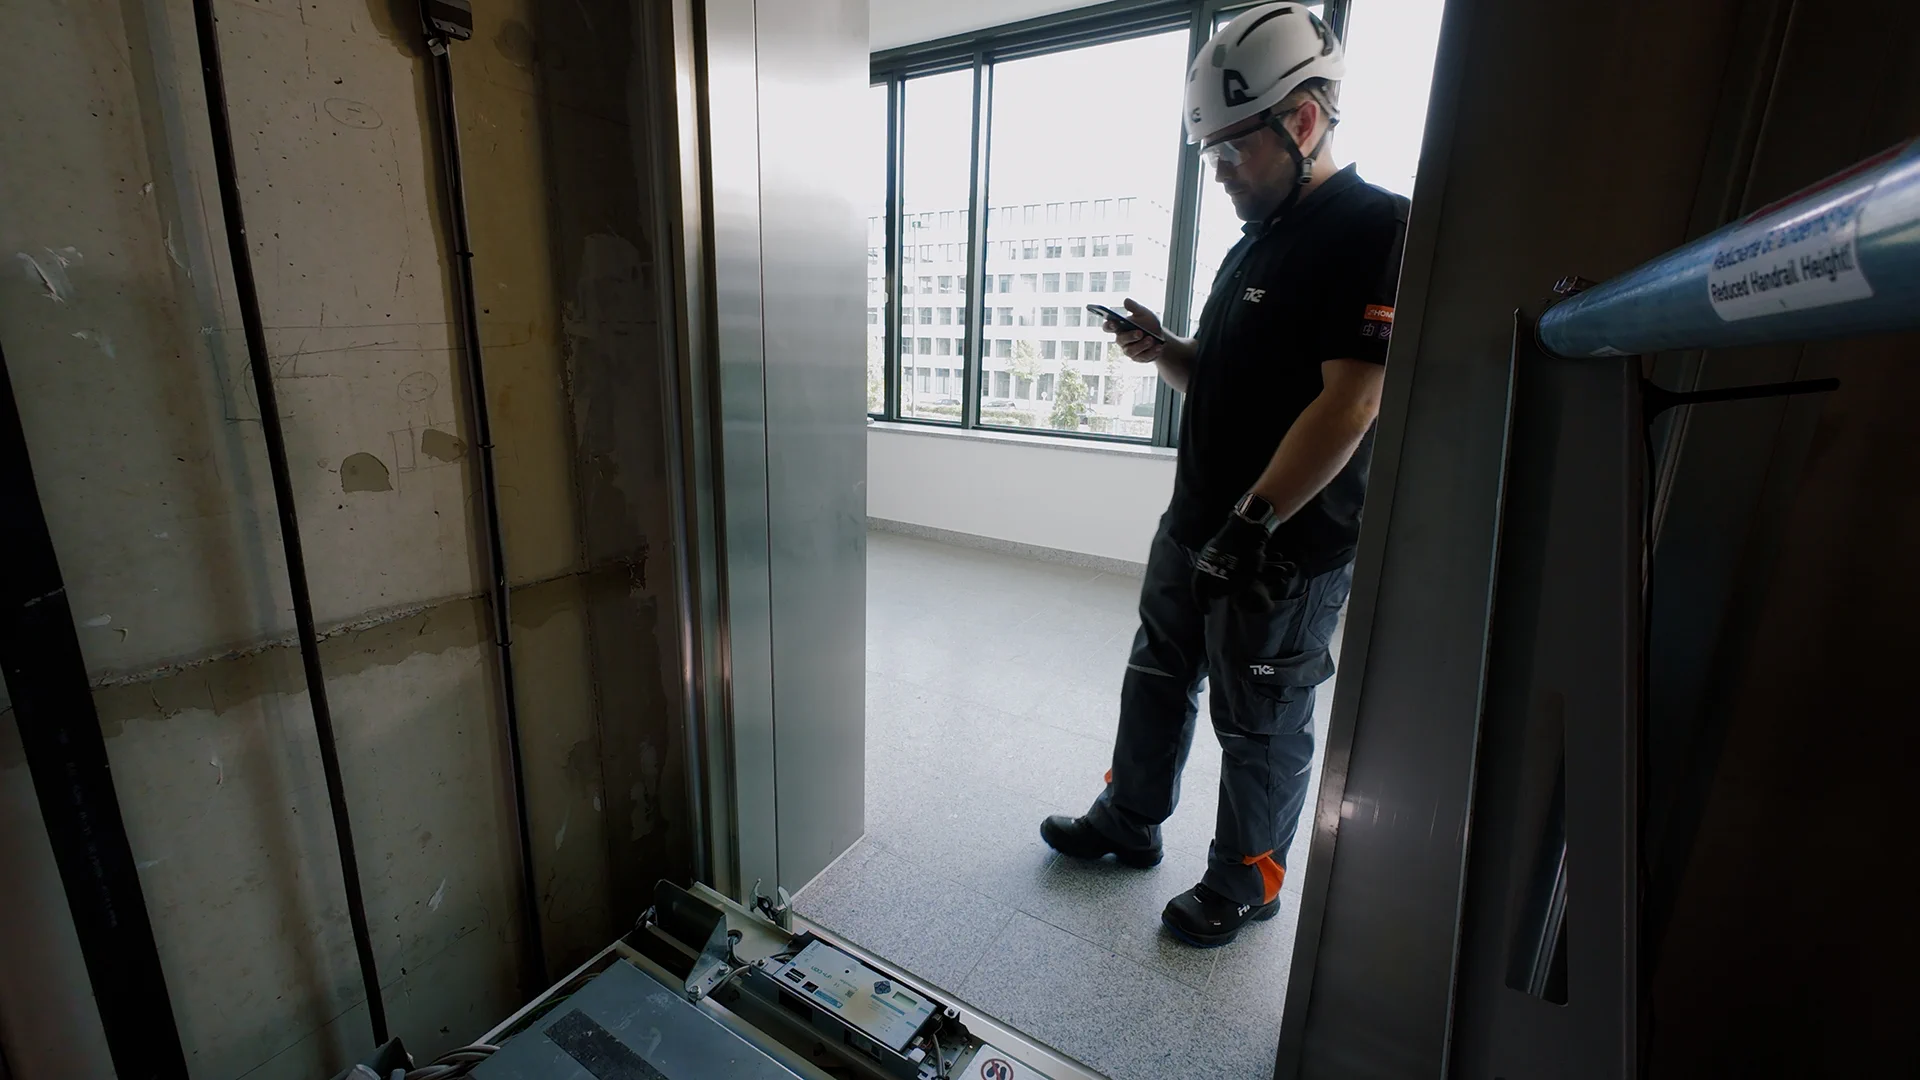
让超过一百万部电梯和自动扶梯平稳运行绝非易事。 今天在科隆,我了解到 TK Elevator 如何利用我们的技术,帮助其服务技师获取数十年积累的共享知识,简化流程,让他们能少花时间查找答案,多花时间保障人们顺畅出行。
在混合模型中,大批量处理时的投机解码会变得低效,因为 Mamba 层必须为每个草稿 token 完整复制状态,造成过多内存流量,抵消了更快解码带来的收益。
智谱的 ZCode 推出 Work 模式,将 AI 编程能力扩展到办公领域,支持文档分析、表格处理和 PPT 生成,并提供多 Agent 工作流功能,成为新一代办公工具的有力竞争者。
蚂蚁数科发布决策模型 LingDT-Decision-1.0,提供 4B 和 27B 两个版本,已在 DTMaaS 平台上线并限时免费体验。该模型首创原生多选与按序决策(DAG)能力,在 23 项开源评测基准中超过 Microsoft-Decision-1、Jev 1.13 等决策模型,27B 版本在同参数模型中准确率最高。
作者 A. Chen 在 ChinaTalk 征文中获奖的这篇报道,实地走访北京五道口的研究者与创业者,梳理机器人数据收集的三代技术:2017 年起的遥操作、2024 年 Stanford UMI 提出的同构外骨骼。
OpenAI 与 PerturbAI、Scripps Research 合作,用数千个基于 GPT-Rosalind 的智能体在 32 分钟内完成对数百万小鼠细胞的全脑 CRISPR 图谱分析,人工估计需数月至一年。
CrowdStrike CEO George Kurtz 解释了 AI 智能体如何加速攻击、防守方为何需要同等能力的模型,以及专有遥测数据、数字孪生和身份管控如何增强企业安全。
企业级 AI 的瓶颈不在模型能力,而在系统能否理解经营场景;长程智能体通过主观世界模型和场景积累,将 AI 从局部提效推向全局经营协同。
小红书大模型基建部发布 NeurIPS 2026 论文 Hint Tuning: Less Data Makes Better Reasoners,把推理模型的思维链按反思词切成片段作为 hint 交给同家族 Instruct 模型,测出每道题的最小有效提示,据此构造长度可变的训练数据。
Anthropic 上市前亮出特殊治理架构:把控制权交给不持股的外部受托人 · · Oct 22, 2026 31.8k 多数人的目光都落在 Anthropic 冲刺 IPO 时的收入增速、模型能力和万亿估值预期上,却很少有人留意它这套与硅谷常规模板迥异的治理安排。
这篇 Hacker News 帖子提出了 AI 语言模型生成代码的版权归属问题,这是科技行业中备受法律与伦理争议的话题。
IDC《中国汽车云市场跟踪,2026H1》显示,2026年上半年中国AI座舱解决方案市场规模达7.1亿元,火山引擎以45%份额位居第一。搭载豆包大模型的汽车已有700万辆上路,覆盖50个品牌、145个车型,日均座舱交互3000万次。火山引擎今年推出基于 Agentic AI 架构的“豆包座舱助手”和“AI座舱套件”,首款搭载车型荣威家越07已于9月开启预售。
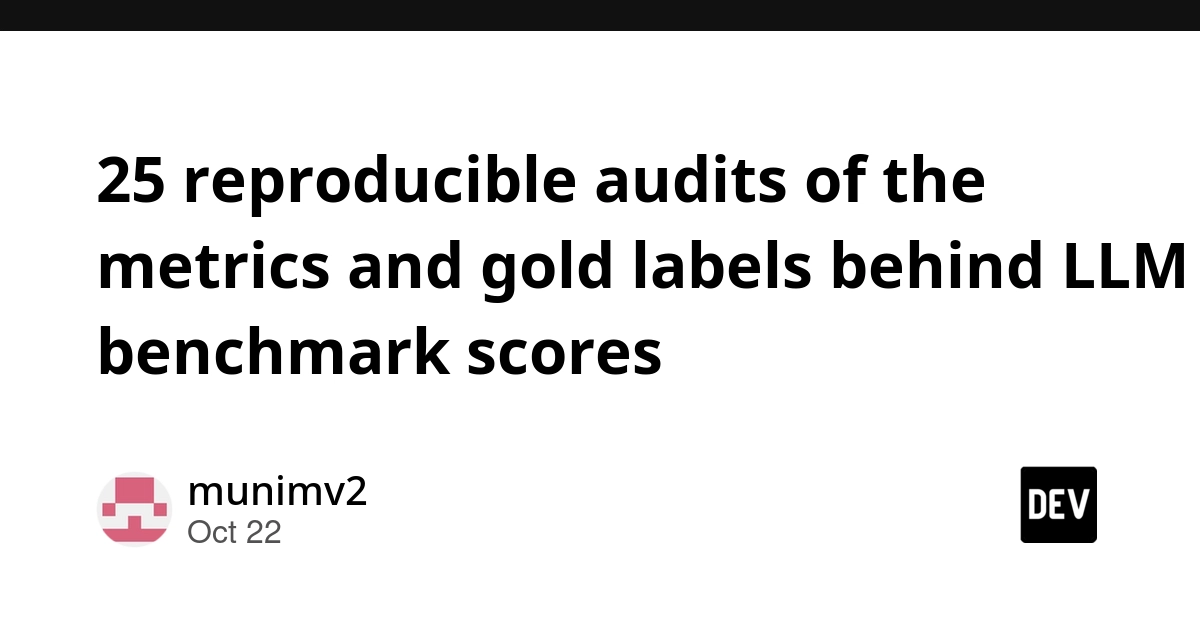
本文介绍了 25 项可复现审计,揭示热门 LLM 基准测试的评分代码和金标准标签中的具体缺陷,包括 NLI 数据集中的自相矛盾标注,以及 GSM8K 中最终答案与计算结果不一致的问题。
腾讯混元与复旦大学研究团队提出 WorkForge 框架,从真实世界资源出发规模化构建可验证的智能体工作环境,产出 WorkForge-16K 共 16,665 个环境,覆盖 40 个专业领域、60 种文件类型。
腾讯混元与复旦大学提出 WorkForge,一个从真实世界资源出发、规模化构建可验证智能体工作环境的框架,通过 16,665 个真实工作区训练模型,显著提升智能体在长程任务中的探索、核查与交付能力。
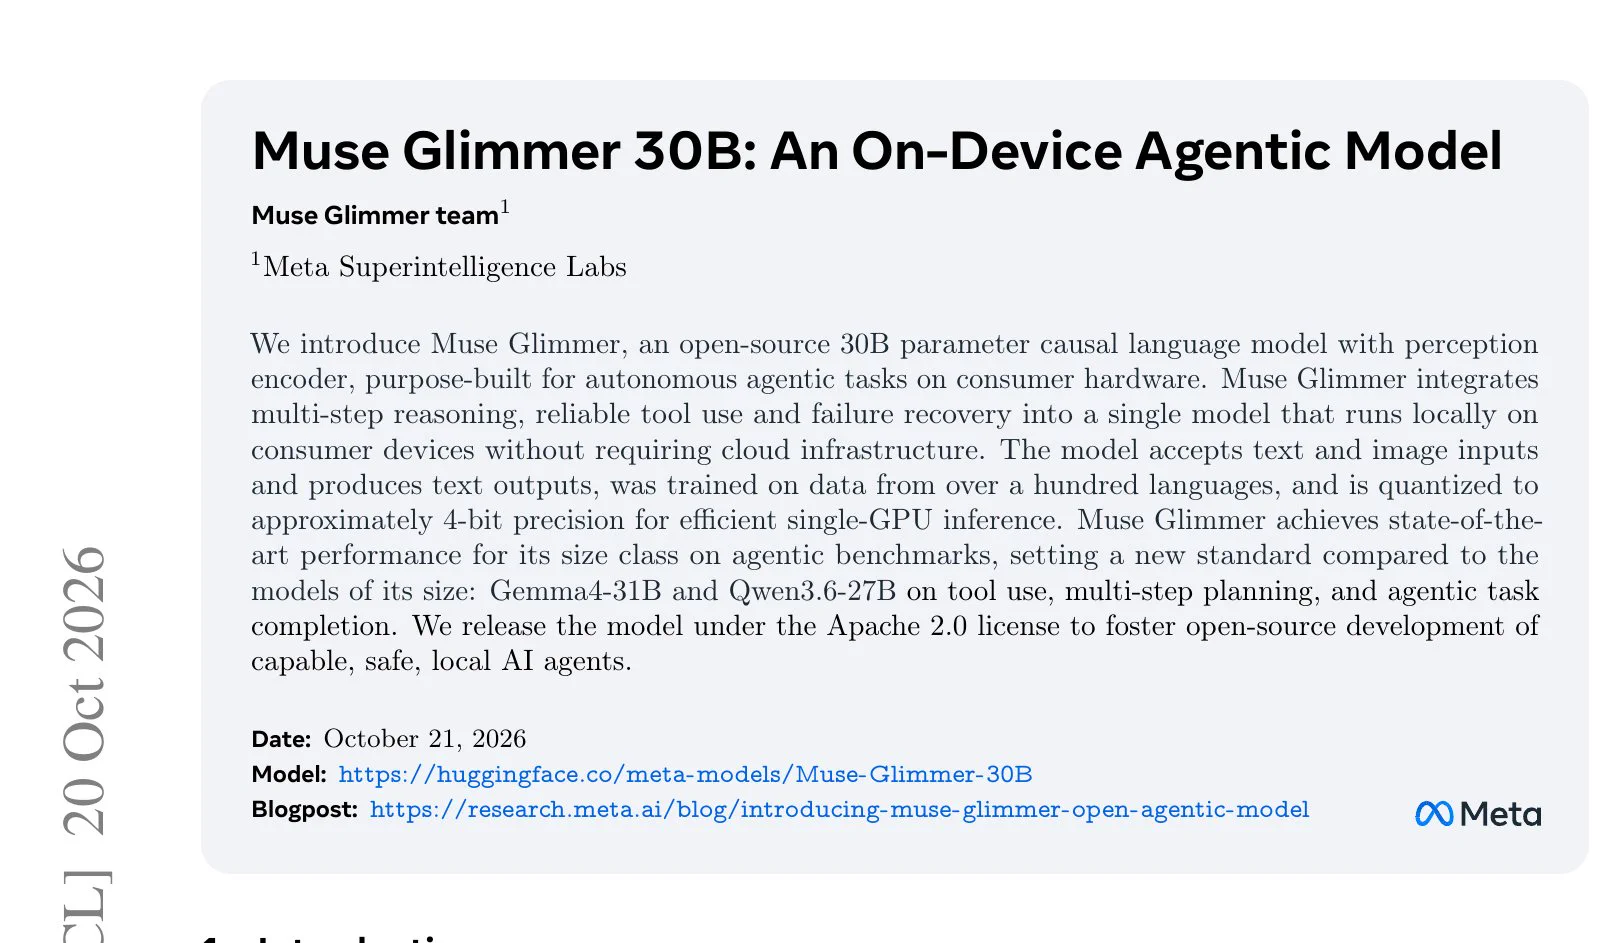
Meta Superintelligence Labs 发布论文并开源 Muse Glimmer 30B,一个从更大的 Muse Spark 蒸馏的稠密 30B 模型,面向消费级硬件的本地智能体任务,采用 Apache 2.0 许可。
Anthropic 开放了 Claude Duet 等待名单,这是一款基于 Claude Opus 5.5 的独立主动式智能体应用,面向美国 Pro 和 Max 用户,还可通过 Stripe Link 和 Shop Pay 购物。