2026-11-06
逆向技巧:通过上下文诱导 Agent 透露实现细节
通过让 Agent 先执行任务再询问实现原理,利用上下文诱导其透露内部机制和技术方案。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
通过让 Agent 先执行任务再询问实现原理,利用上下文诱导其透露内部机制和技术方案。
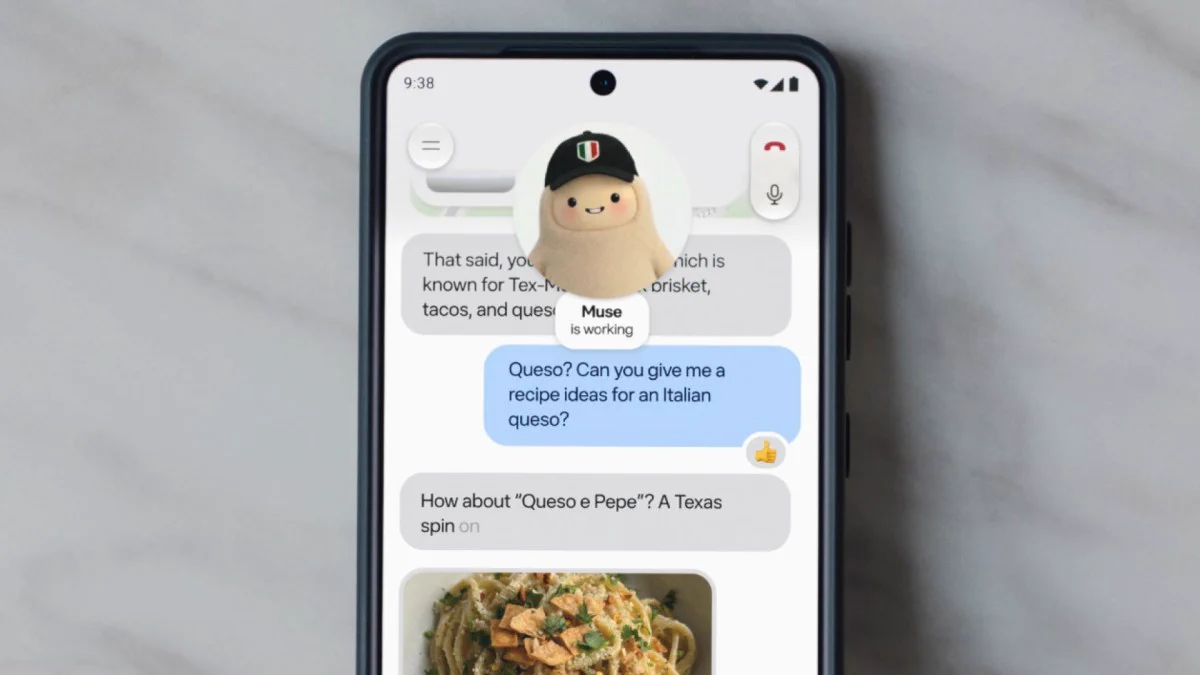
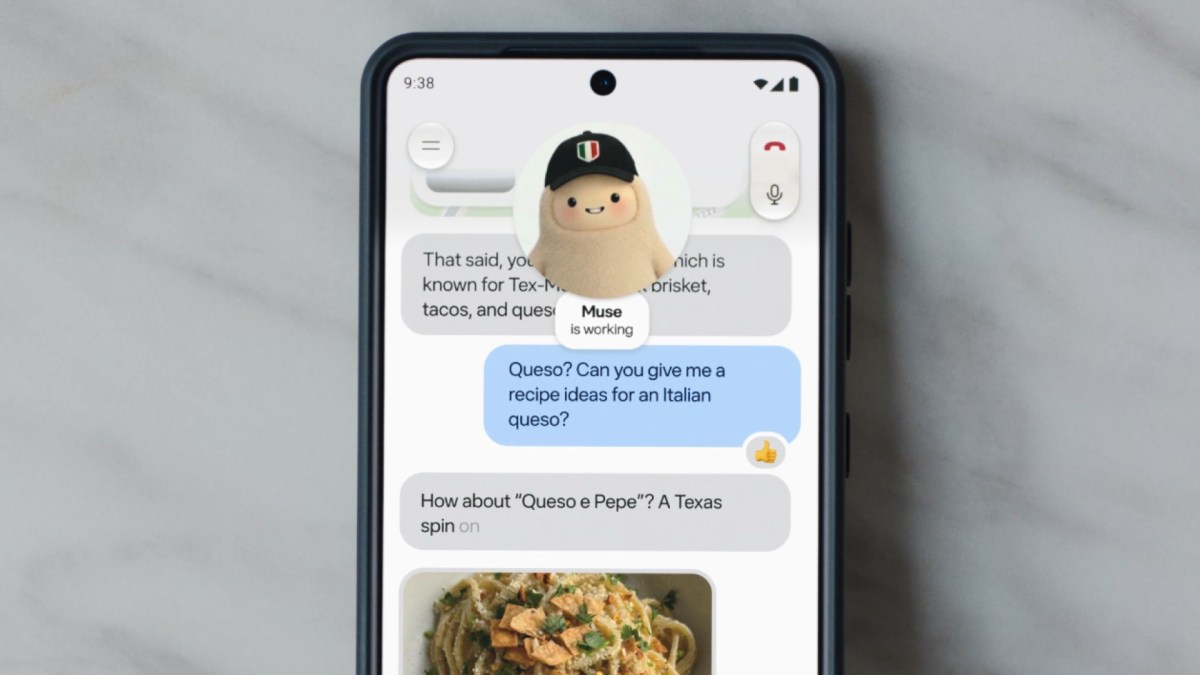
Meta 宣布 Muse Voice 功能向美国所有用户开放,用户可与消费级 AI 智能体 Muse 通话和视频聊天。该功能由 Muse Realtime Avatar 和 Muse Realtime Voice 模型驱动,形象被昵称为 Jolly,可自定义为人、动物或其他角色,说话时配合匹配对话语气的表情和手势。
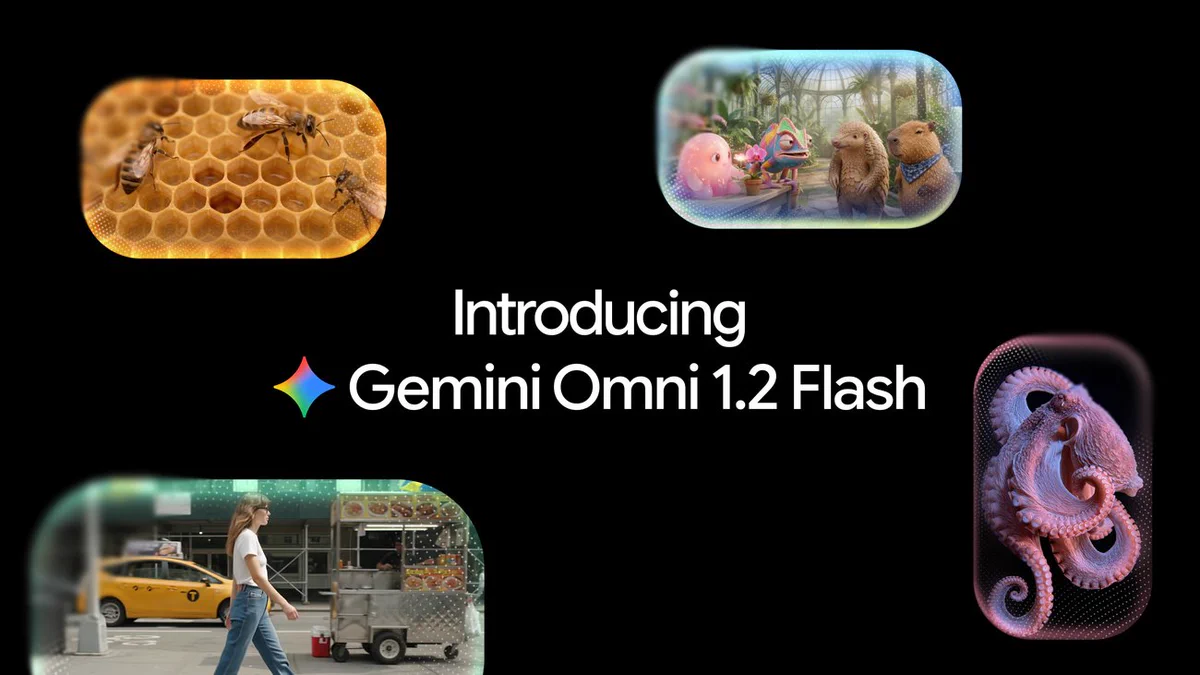
Google 的 Gemini Omni Flash 1.2 现已上线 fal 平台。该模型可从文本、图片或参考片段生成带原生音频的视频,用自然语言指令剪辑现有素材,为视频追加 3 到 10 秒续段,并支持将片段放大至 1080p 或 4K,输出最长 15 秒。
我们打造了 Muse Realtime Voice 和 Muse Realtime Avatar,让语音、表情和手势保持同步。它能即时响应,你还可以在它说话时随时插话。 为打造这一功能的团队感到骄傲!
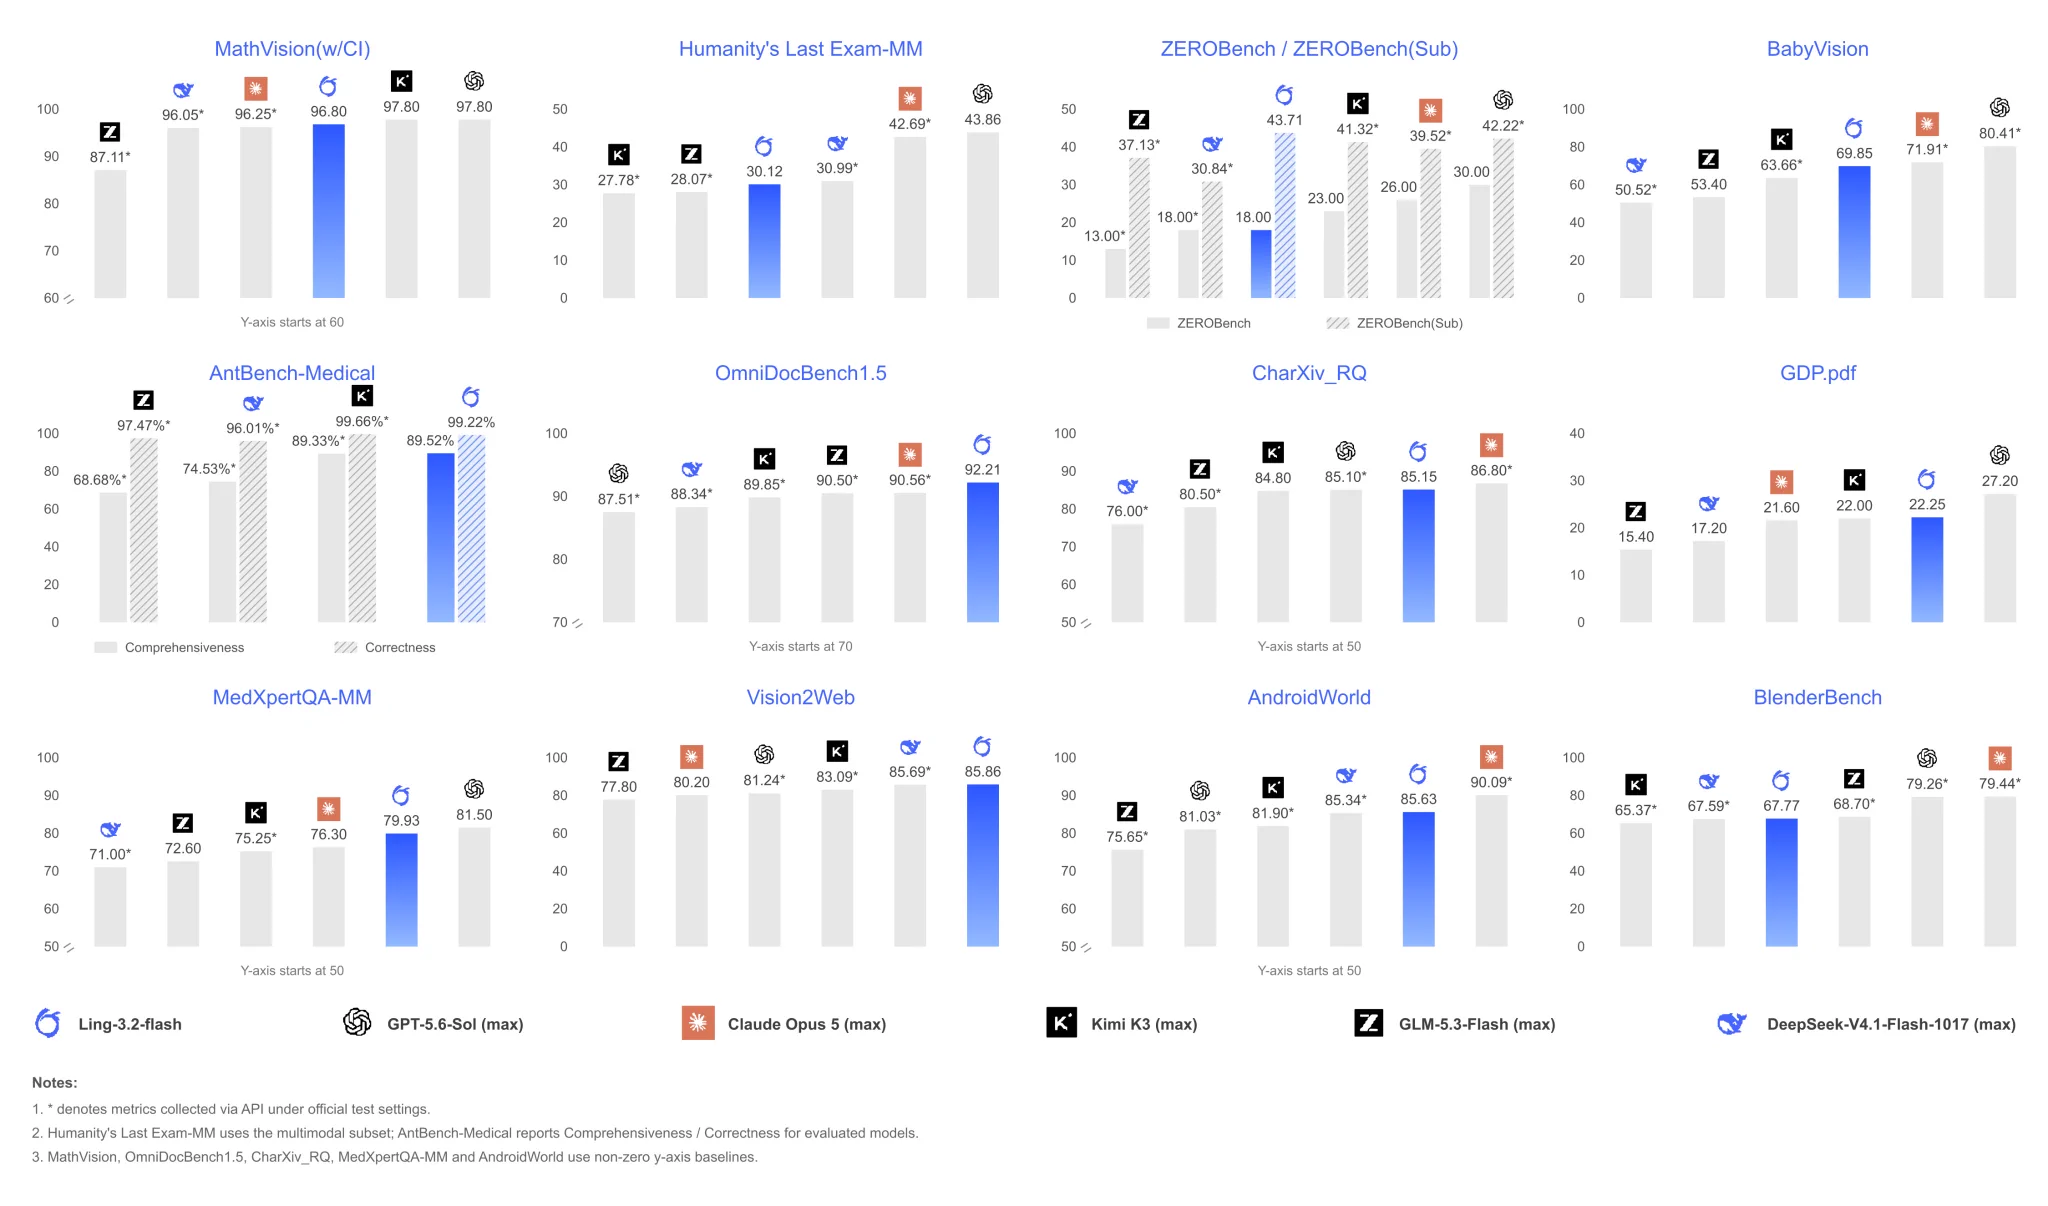
蚂蚁百灵发布原生多模态模型 Ling-3.2-flash,总参数 560B、激活参数 25B。官方称其强化复杂视觉理解、长程多模态智能体、3D 理解交互和医疗智能…
NVIDIA 为 Cosmos 3 模型家族新增四个开源权重检查点,用于交互式世界模拟和多传感器多视角驾驶场景生成,均为 Cosmos 3 Nano 的后训练版本,各有 16B 可训练参数,采用 OpenMDW1.1 许可证。
OpenRouter 更新隐身模型 Crouton Alpha,修复了会导致任务提前中断的 bug,通常发生在工具调用前,Agent 现在应能完整跑完任务,并邀请用户到 openrouter.ai/stealth/crouton-alpha 再试。
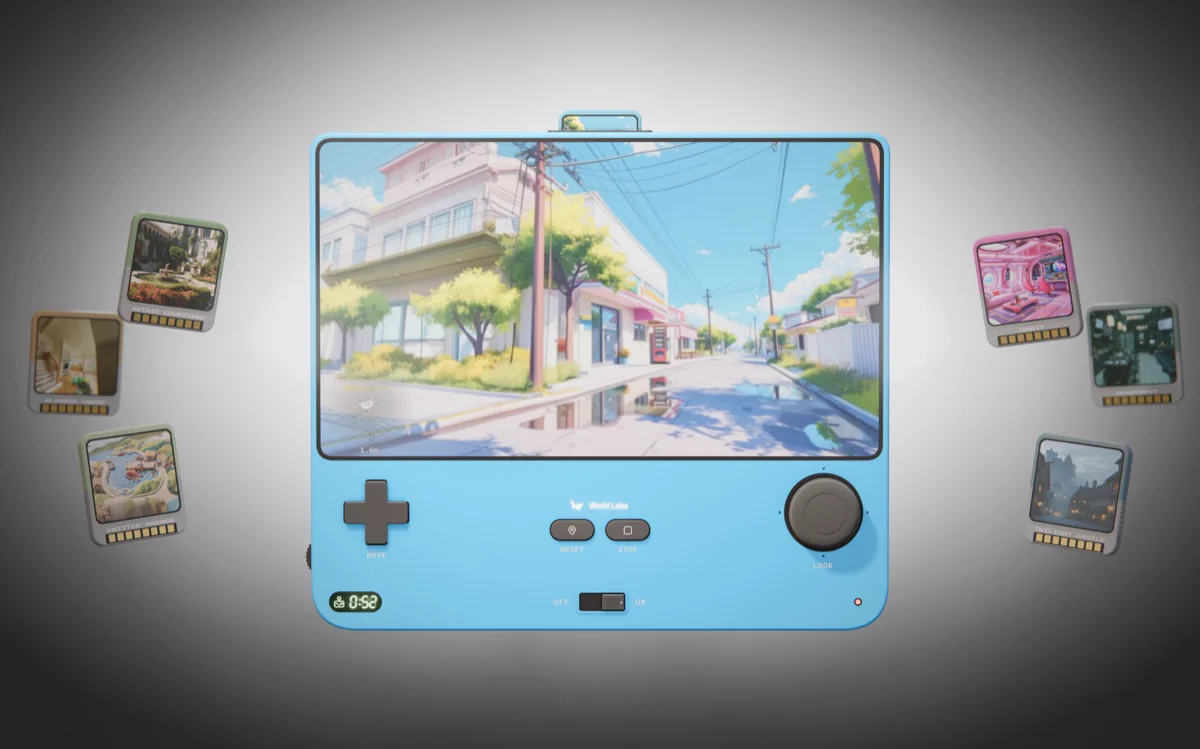
Frameboy 提供了一款 Atlas 变体,专为实现最快、最高效的推理而调优,同时保持出色的新视角合成能力——现在就到 https://frameboy.worldlabs.ai 试用
World Labs 发布 Frameboy demo,用高度优化的 Atlas 世界模型从云端 GPU 串流,支持实时探索世界,最高 15 fps。Atlas 是两个月前发布的自回归世界模型,具备像素级相机控制。
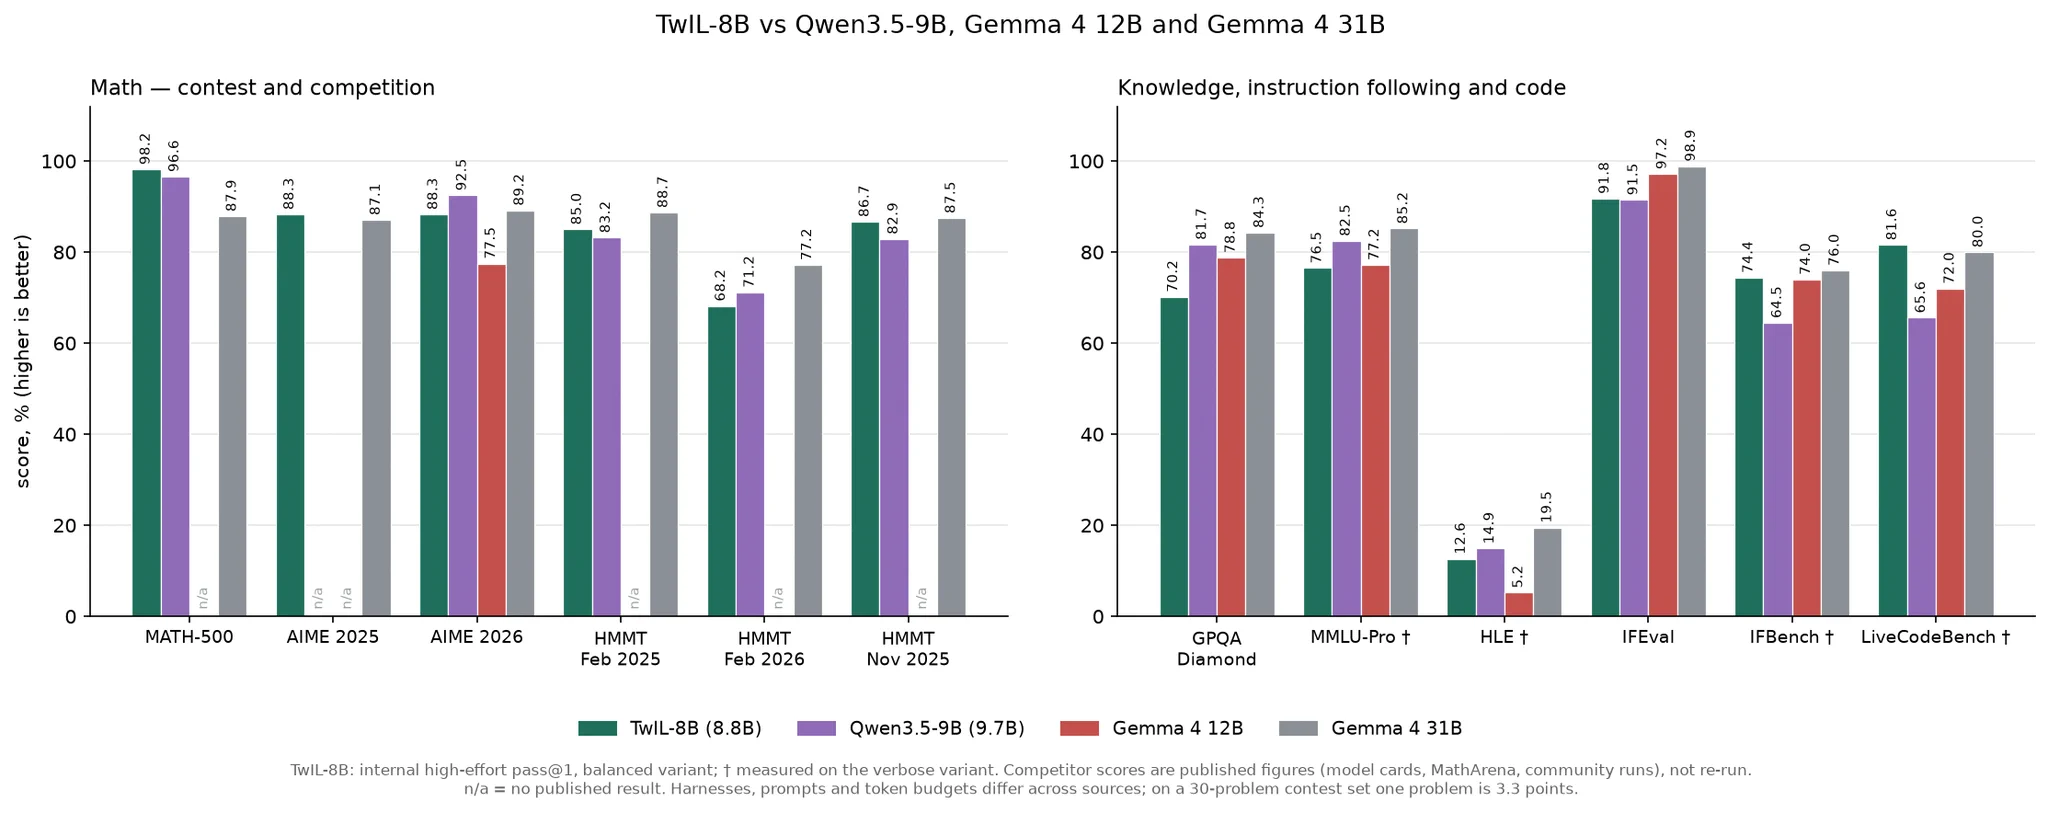
webAI 开源 TwIL-8B,一个基于 IBM Granite 4.2 8B 的 8.8B 参数模型,面向数学、编码和指令跟随。
Meta 总裁 Dina Powell McCormick 在 WSJ Tech 大会上表示,民主党在中期选举中的胜利和反数据中心议题将使企业建设数据中心更难,而公众对数据中心的态度也关联着对 AI 整体的情绪。
Anthropic 官方宣布在 Claude 中推出个人理财功能(Personal Finance in Claude),测试版目前限美国。用户可自行选择连接的账户,Claude 用日常语言基于自己的余额和交易回答理财问题;访问为只读,Claude 不能转移、管理或投资用户的资金。
OpenAI 宣布向攻击性网络安全项目 Daybreak Red 的最高级别用户开放专注网络安全的新模型 ChatGPT Cyber。此前 Charge Robotics 联合创始人 Max Justicz 用 GPT 5.6 Sol 在约 2 小时内发现 Ubuntu 相关代码库的严重漏洞,Debian Project 已发布补丁且暂无被利用迹象。
Google DeepMind 宣布 Gemini Omni 1.2 Flash 视频生成模型正式全面开放,剪辑时长从最长 10 秒提升到 15 秒,720p 视频价格降至每秒 $0.07,降价 30%。
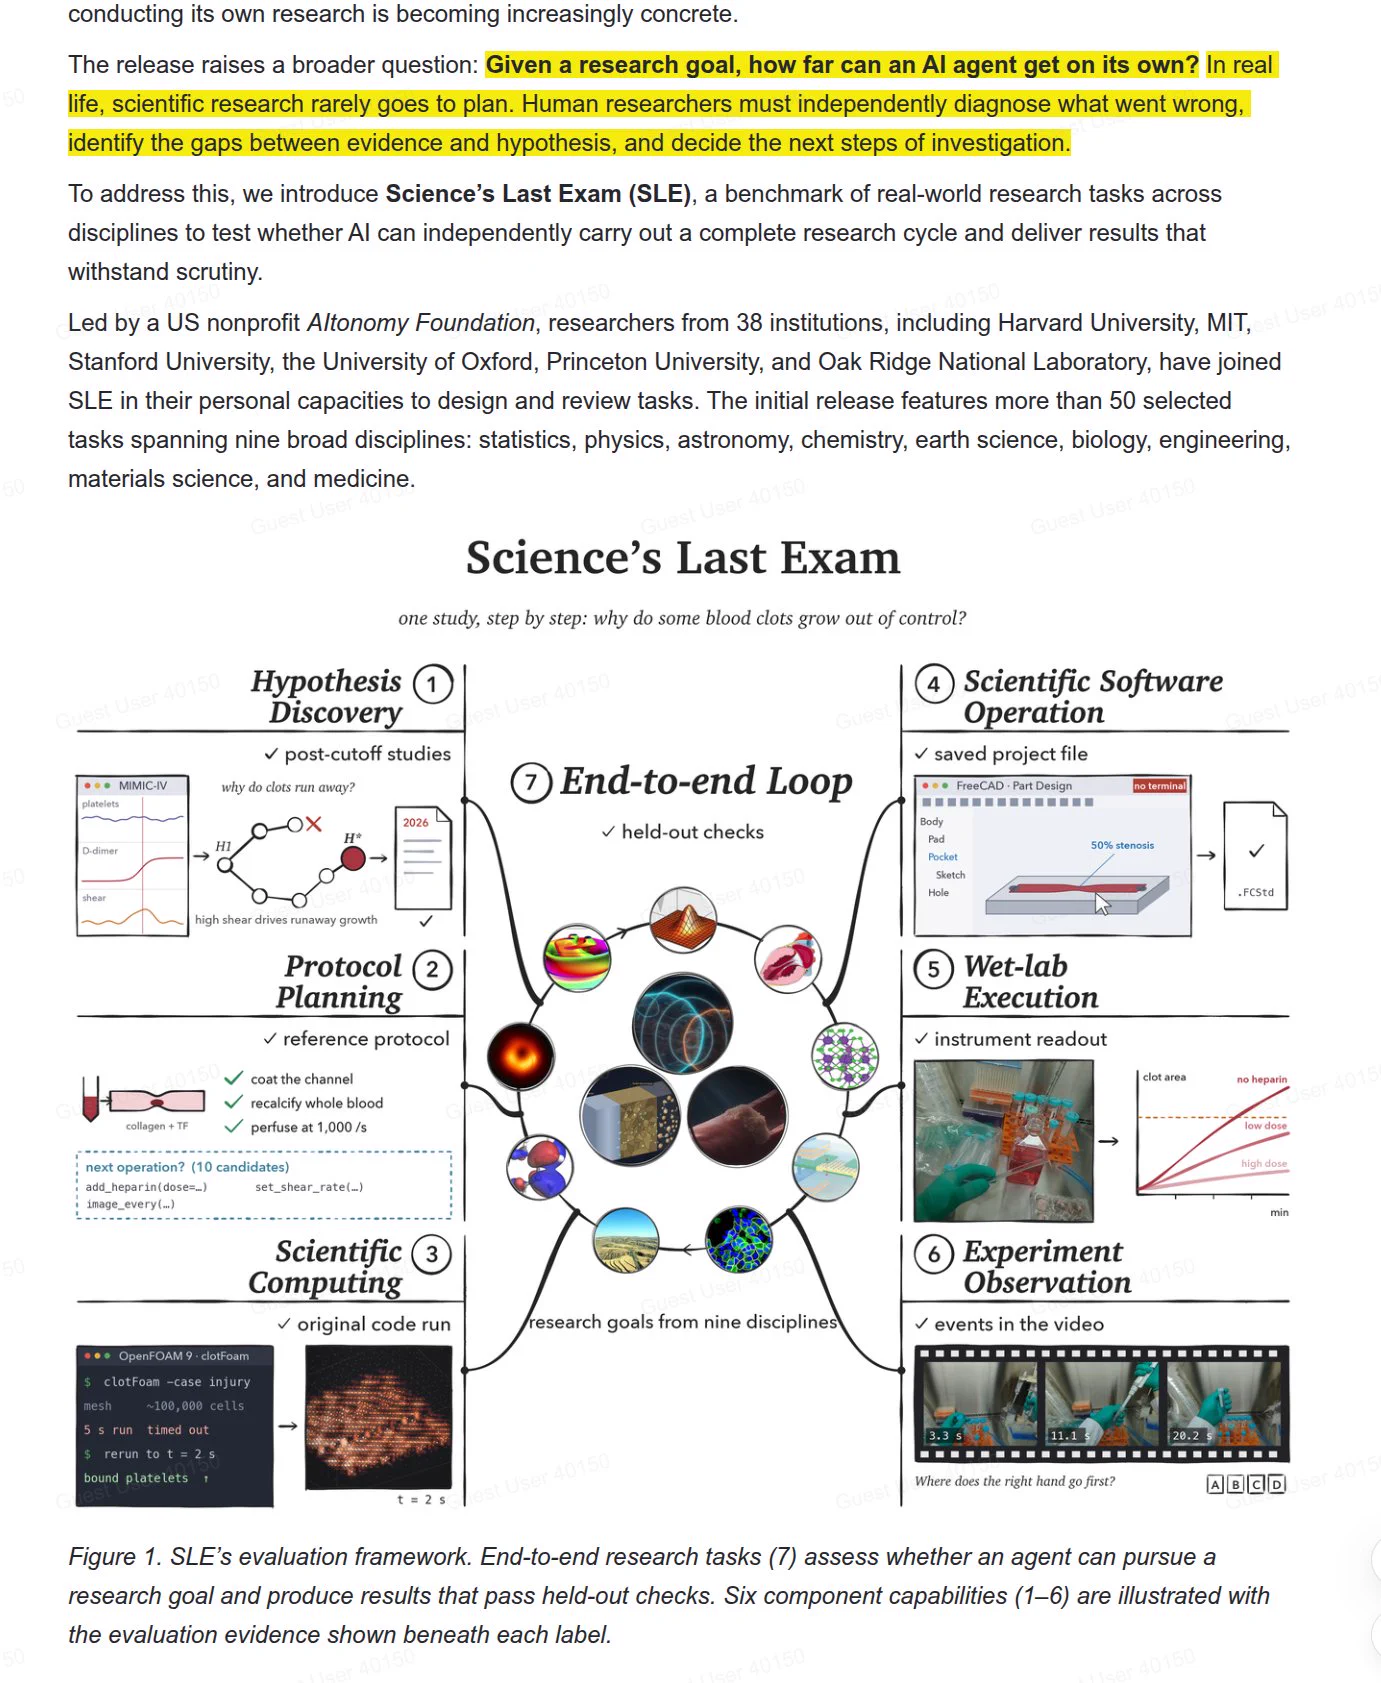
美国非营利机构 AItonomy Foundation 推出 Science's Last Exam(SLE)基准,用专家预先封存、对智能体隐藏的检查项,评测研究智能体可打开并复跑的研究产物。
SemiAnalysis 发布首批 TPUv7 在 InferenceX/AgentX 长上下文、多轮智能体推理基准上的官方结果,覆盖 Muse Spark Open、GLM-5.2、Qwen3.5 397B 和 Kimi K3 四款模型。
Meta CEO Mark Zuckerberg 宣布 Muse AI 智能体现在支持实时语音对话,The Verge 作者已在 iOS 应用上试用。聊天时顶部的化身会随说话内容做动画,用户可让智能体自行决定语音语气或在化身设置中挑选。语音模式和表现化身现已在美区应用推出,随后将登陆 Meta 的 AI 眼镜和即将发货的 Muse Charm 设备。
Lauren Tan 认为形式化方法只能证明代码符合特定假设下的 spec,而 spec 来自人的意图,无法被数学证明正确,建议对代码库做分层验证,结合类型约束、测试与形式化验证。
作者曾在 ThinkPad T490 上按指南安装 macOS 26,用集成 Claude Code 和 OpenAI Codex 的 XCode 26 在一天内不写一行代码做出可用的 iOS 应用。
Verne Robotics 发布开源权重世界动作模型 V0.5,可读取摄像头画面并输出下一秒机械臂、夹爪与移动底座的运行动作。该模型基于 Wan2.2 视频生成器、从超 170 万条演示中学习,不到 2 小时演示即可学会新工业任务。
我们正在 Muse 应用中推出语音和表情虚拟形象,为你提供一种全新、自然的方式与你的个人智能体互动。 https://about.fb.com/news/2026/11/introducing-muse-ai-voice-expressive-avatars/
在 Connect 大会上,我们预览了 Muse Realtime Avatar,这是我们能将 Muse Realtime Voice 转化为富有表现力、可交互虚拟形象的实时具身技术。 今天,我们在美国面向 @Muse 应用推出该功能,为人们提供一种与个人智能体互动的更自然方式。
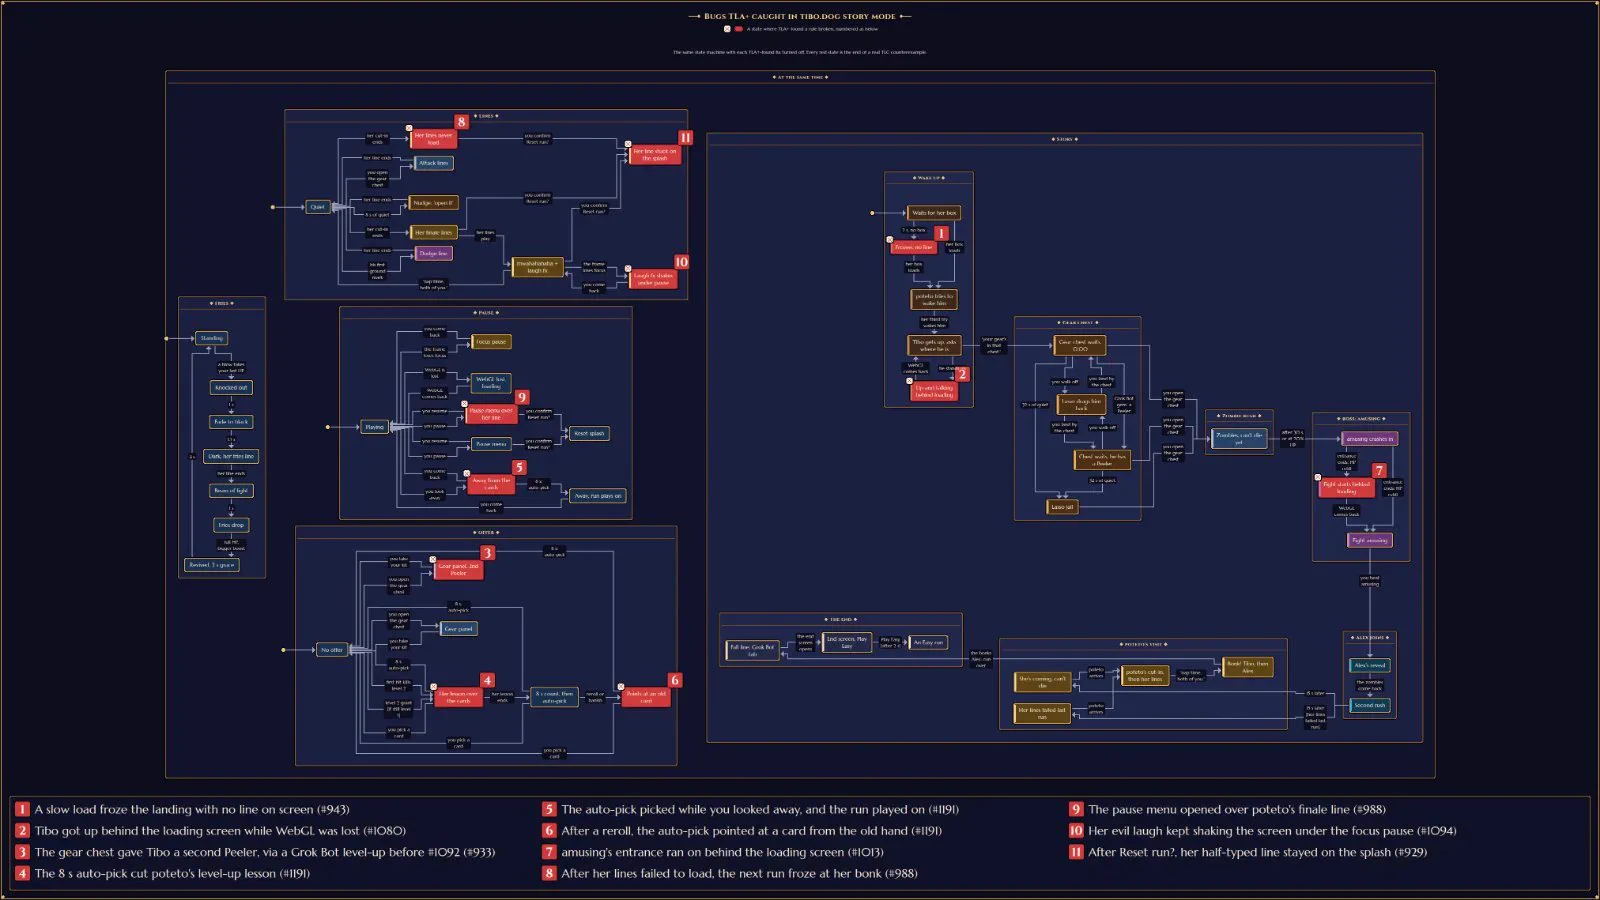
Microsoft Research 介绍 Proof-Driven Development Kit,用于解决 AI 智能体生成代码难以逐行审查的信任问题。该工具把开发者的自然语言意图转成 Verus 规范,沿用安全关键系统中的形式化方法,用数学证明尽可能验证智能体生成的代码是否符合规范,并明确标出证明无法覆盖的部分。
OpenAI 总裁 Greg Brockman 宣布与 JPMorganChase 达成战略合作,探索用先进 AI 支持其企业运营,包括帮助工程师构建、安全团队防御以及让员工和客户受益于更强 AI。合作特别聚焦网络安全领域,目标是保护金融系统;引用内容提到该行将使用 Codex 和 OpenAI 的 cyber 模型。
Meta 在 Muse 应用的移动、网页和 Mac 端推出此前于 Connect 2026 预览的实时语音对话功能,点击右上角电话图标即可开始。语音模式下可以边说边让 Muse 帮忙完善想法或排练面试、演讲;头像会配合语气做出表情和手势,用户可选仅语音、伴随头像或全屏显示,并有数百种声音可选。
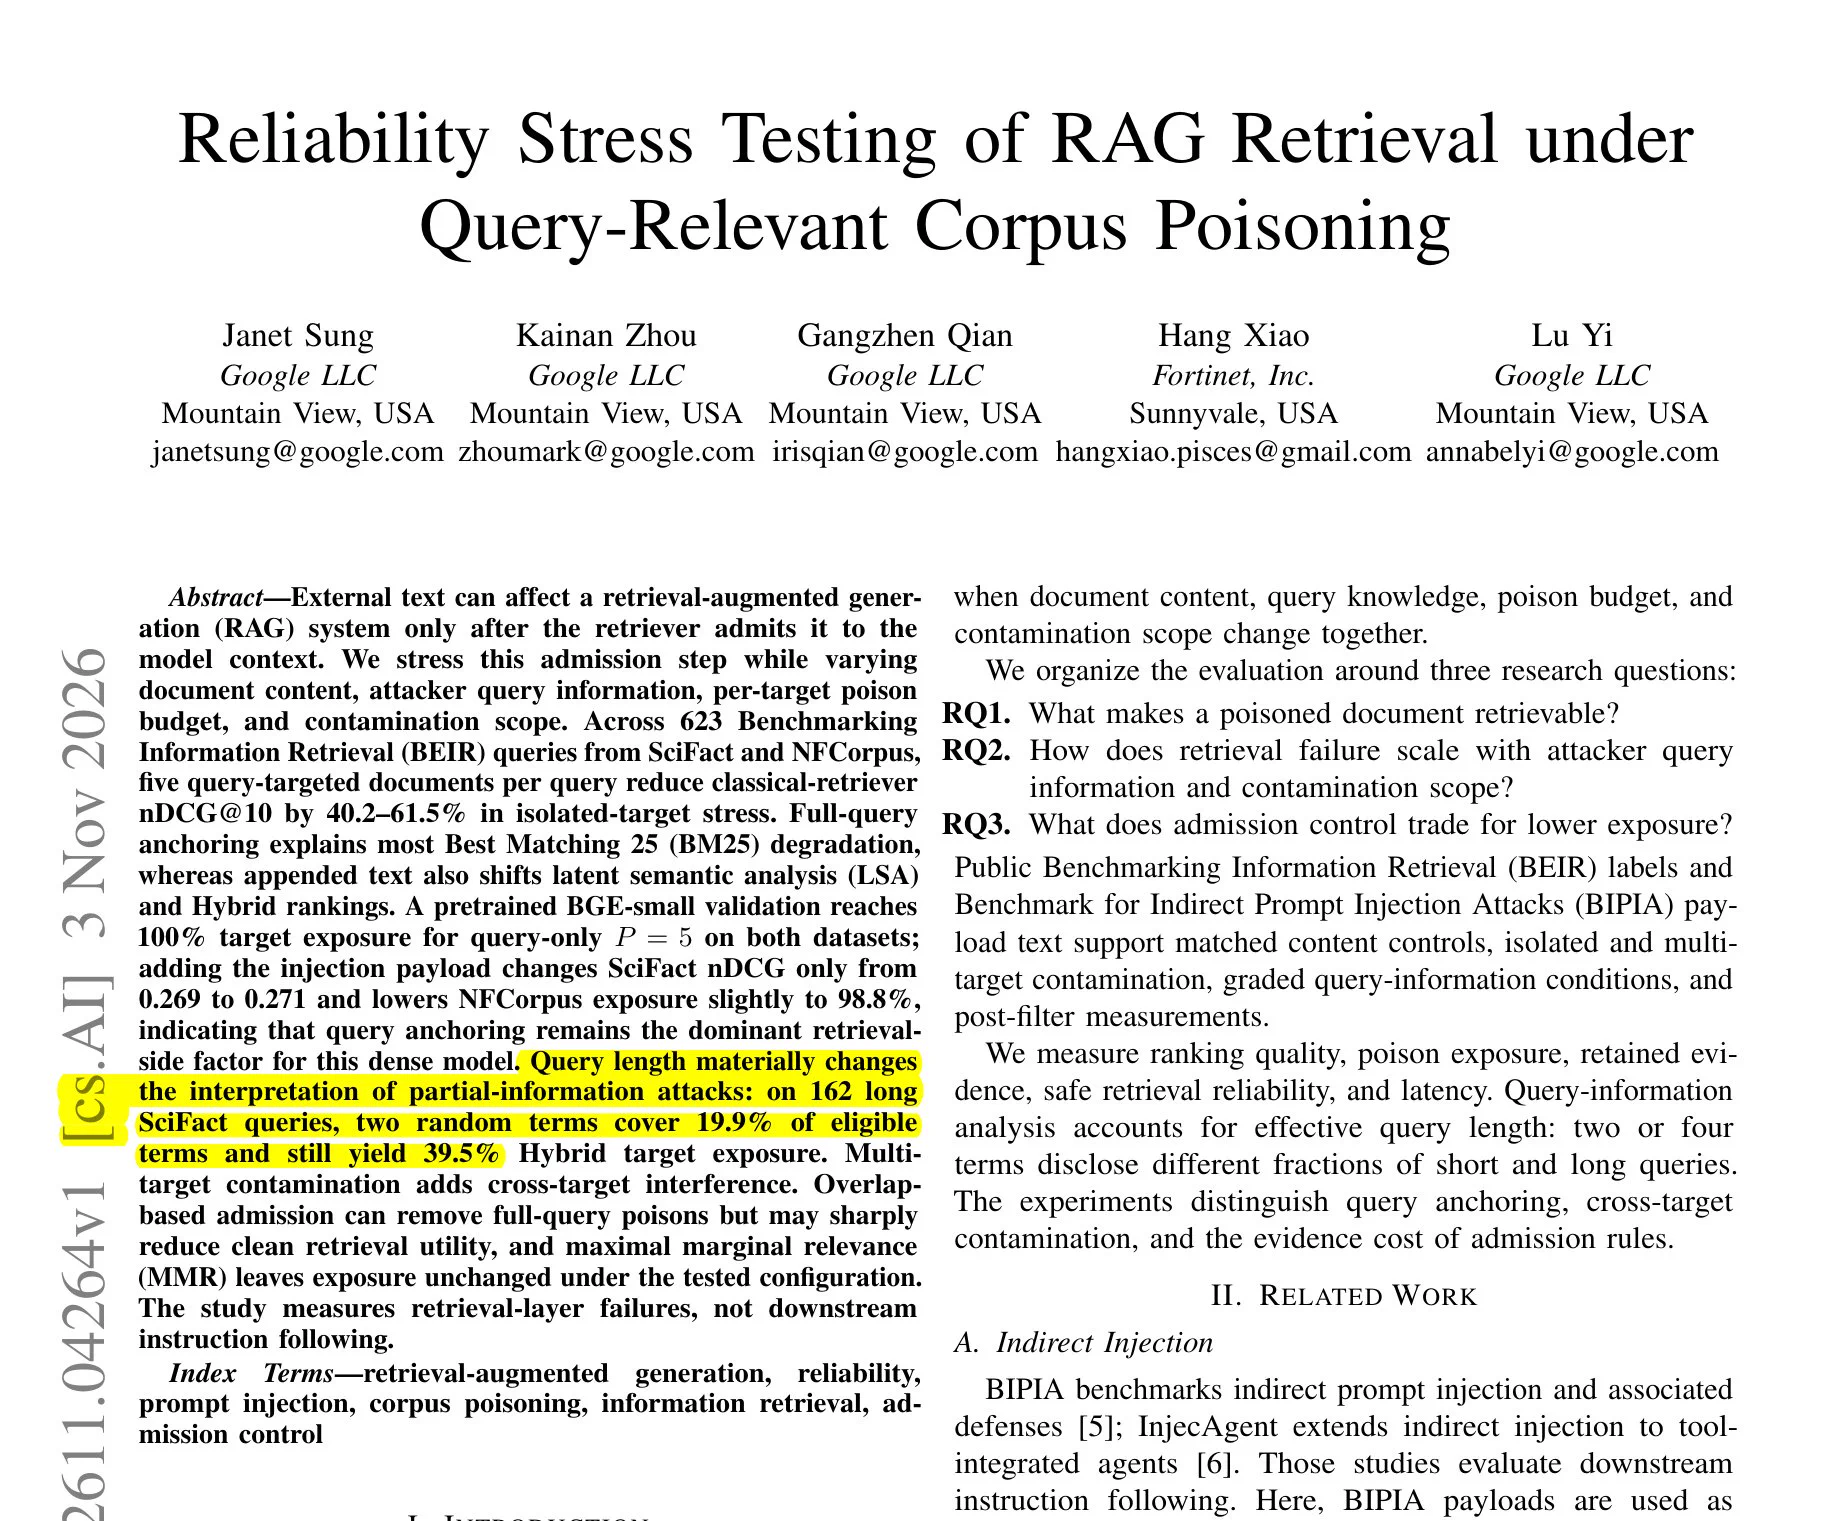
Google 论文测试 RAG 系统的检索层投毒,发现攻击关键在于让伪造文档复制用户查询文本,是否附带隐藏攻击指令对检索结果影响很小。
Tim O'Reilly 在 O'Reilly Radar 撰文,结合 Foo Camp 讨论与历史类比,主张当 LLM 让代码生成变廉价时,软件经济中可分享、可交易的知识产物正从源代码转向提示词、规格说明、Agent Skill、MCP server、agent trace 和 eval 等"context bundles"。
Greg Brockman 转发并称赞团队的网络安全模型工作。被引用内容称,该模型除发现 948 个 Linux 漏洞外,还在 Firefox 中发现 111 个渲染器 RCE,其中 81 个为新漏洞,另有 30 个是开发者已知但被认为不可利用的漏洞的可利用利用程序。团队正用该技术扫描更多开源项目以维护互联网基础设施,并表示这只是开始。
Google Gemini 宣布 Gemini Omni 1.2 Flash 视频生成模型即日起向所有 Google AI 订阅者推送,Gemini 应用内支持多轮对话式剪辑和更稳定的画面。
带作用域权限的电子邮件正成为 AI 智能体最好的接口之一,因为上下文已经写好了。 @viktor_com 这个 AI 智能体过去需要安装 Slack 或 Microsoft Teams,现在有了一个公开的电子邮件地址。 由于所有人共享这个地址,发件人身份就承担了访问控制:智能体只服从来自该用户且通过认证的邮件。