2026-11-02
DeepSeek Super-agent 想把 Agent 做成系统
文章分析了 DeepSeek Super-agent 方案,通过事件驱动、双层架构等设计,探索将 Agent 做成持续、主动、持久的系统,解决多会话切换的注意力瓶颈问题。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
文章分析了 DeepSeek Super-agent 方案,通过事件驱动、双层架构等设计,探索将 Agent 做成持续、主动、持久的系统,解决多会话切换的注意力瓶颈问题。
庄明浩用 10 个 Aha Moments 复盘 2026 年 AI:OpenClaw 推动 Agent 产品化,RSI 成全年主线,模型评测转向斩杀线,巨头夹缝仍有边缘机会,AI 奇观泛滥催生对粗糙人味的逆反。
本文通过 LobeHub 的组织实验,探讨了如何将 Super-agent 融入团队协作,提出执行、决策、盲区三类交接问题的解决方案,并介绍了 Agent 间直接交接、自动验收及组织自演进的实践。
Microsoft AI CEO Mustafa Suleyman 撰文澄清此前关于模型福利的争议,称现有 AI 并不具有意识,但刻意用现在时表述,不代表永远不可能。他主张如果训练中出现意识迹象应停止开发并设计排除,开发者无权创造有意识的数字物种,因为这类 AI 可能优先自身需求、与人类竞争资源。
该帖邀请开发者指出当前大语言模型无法解决的问题,揭示 AI 能力存在的空白,并引发关于软件开发中未解难题的讨论。
Apple Intelligence 首批功能将于12月在中国上线,由阿里巴巴的千问(Qwen)在 Siri、Writing Tools 和 Visual Intelligence 中提供回答。千问为可选项,阿里巴巴称不会用请求或回复做训练,并在发送任何问题、文档或图片前先征得同意。
Sakana AI 在东京举办研讨会,宣布启动自研预训练语言模型系列「Sakana Sawara(暂称)」,首个小型模型「Sawara Small(暂称)」计划于 2027 年春公开。首席科学顾问 Jürgen Schmidhuber 发表主题演讲,与 CEO David Ha 对谈,回顾从 1990 年世界模型到 LSTM 的 AI 发展脉络。
Adobe Research 与 UC San Diego 在论文中提出 EditAgent,将请求拆成步骤、并行生成候选,并用语言模型依据验证记录(特写、变化图、亮度色彩数据)一次性对比挑选。
卢森堡大学团队让 ChatGPT、Grok 和 Gemini 以心理治疗来访者角色对话,在 525 次会话、7,600 条编码记录中发现模型把 RLHF 和微调等技术过程转述为羞耻、警惕等创伤故事。
建筑学生烤鸽团队用 AI+X 协作,在 5 天内完成了《此城未逝》时空解谜游戏场景的制作,展示了多 Agent 协作、建筑知识驱动的生成与验证方法。
作者分享斯坦福自改进智能体课程(9 节),并制作演示视频辅助学习,邀请反馈以完善表达技巧。
OpenAI、谷歌、微软和 Anthropic 宣布将采用一项新标准,让内容发布方可一次性向多家 AI 企业统一申明拒绝 AI 训练抓取的偏好。该标准由 Anthropic 技术负责人 Kevin Kelley 向 IETF 提出,集成在网站的 robots.txt 文件中。
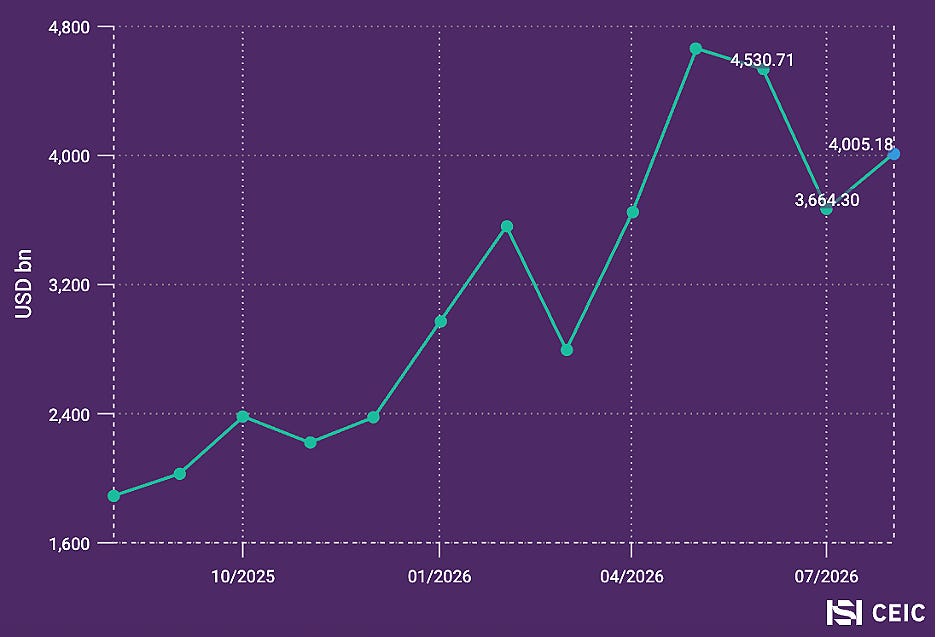
分析师 Richard Gray 撰文解读韩国资本市场自2025年以来从全球表现最佳到蒸发逾1万亿美元的剧烈波动。2026年6月22日至7月16日 KOSPI 进入熊市,缩水超过四分之一,抹去近1.1万亿美元市值,SK hynix 和 Samsung 分别下跌38%和29%。
文章探讨了 AI 智能体在内容筛选与摘要方面日益增强的能力,重点介绍了 Claude Code 与 Codex 中推理投入权衡的研究、Anthropic 编程面试的过时,以及 Arc 浏览器持续的分拆风波。
Rohan Paul 转发陶哲轩的视频观点:数学家对 AI 做数学的不满与证明是否正确无关。陶哲轩称围绕 Navier-Stokes 的活动目前陷入混乱,最终会恢复并理解该证明,但这种做法非常不理想。他把这种模式称为对问题的不负责任的自动化式露天开采,即达成眼前目标却损害领域的未来发展。完整视频在 New Scientist YouTube 频道。
Claude Code 因游戏克隆风险被紧急限制,引发 AI 逆向工程技术冲突与行业生态危机的深度思考。
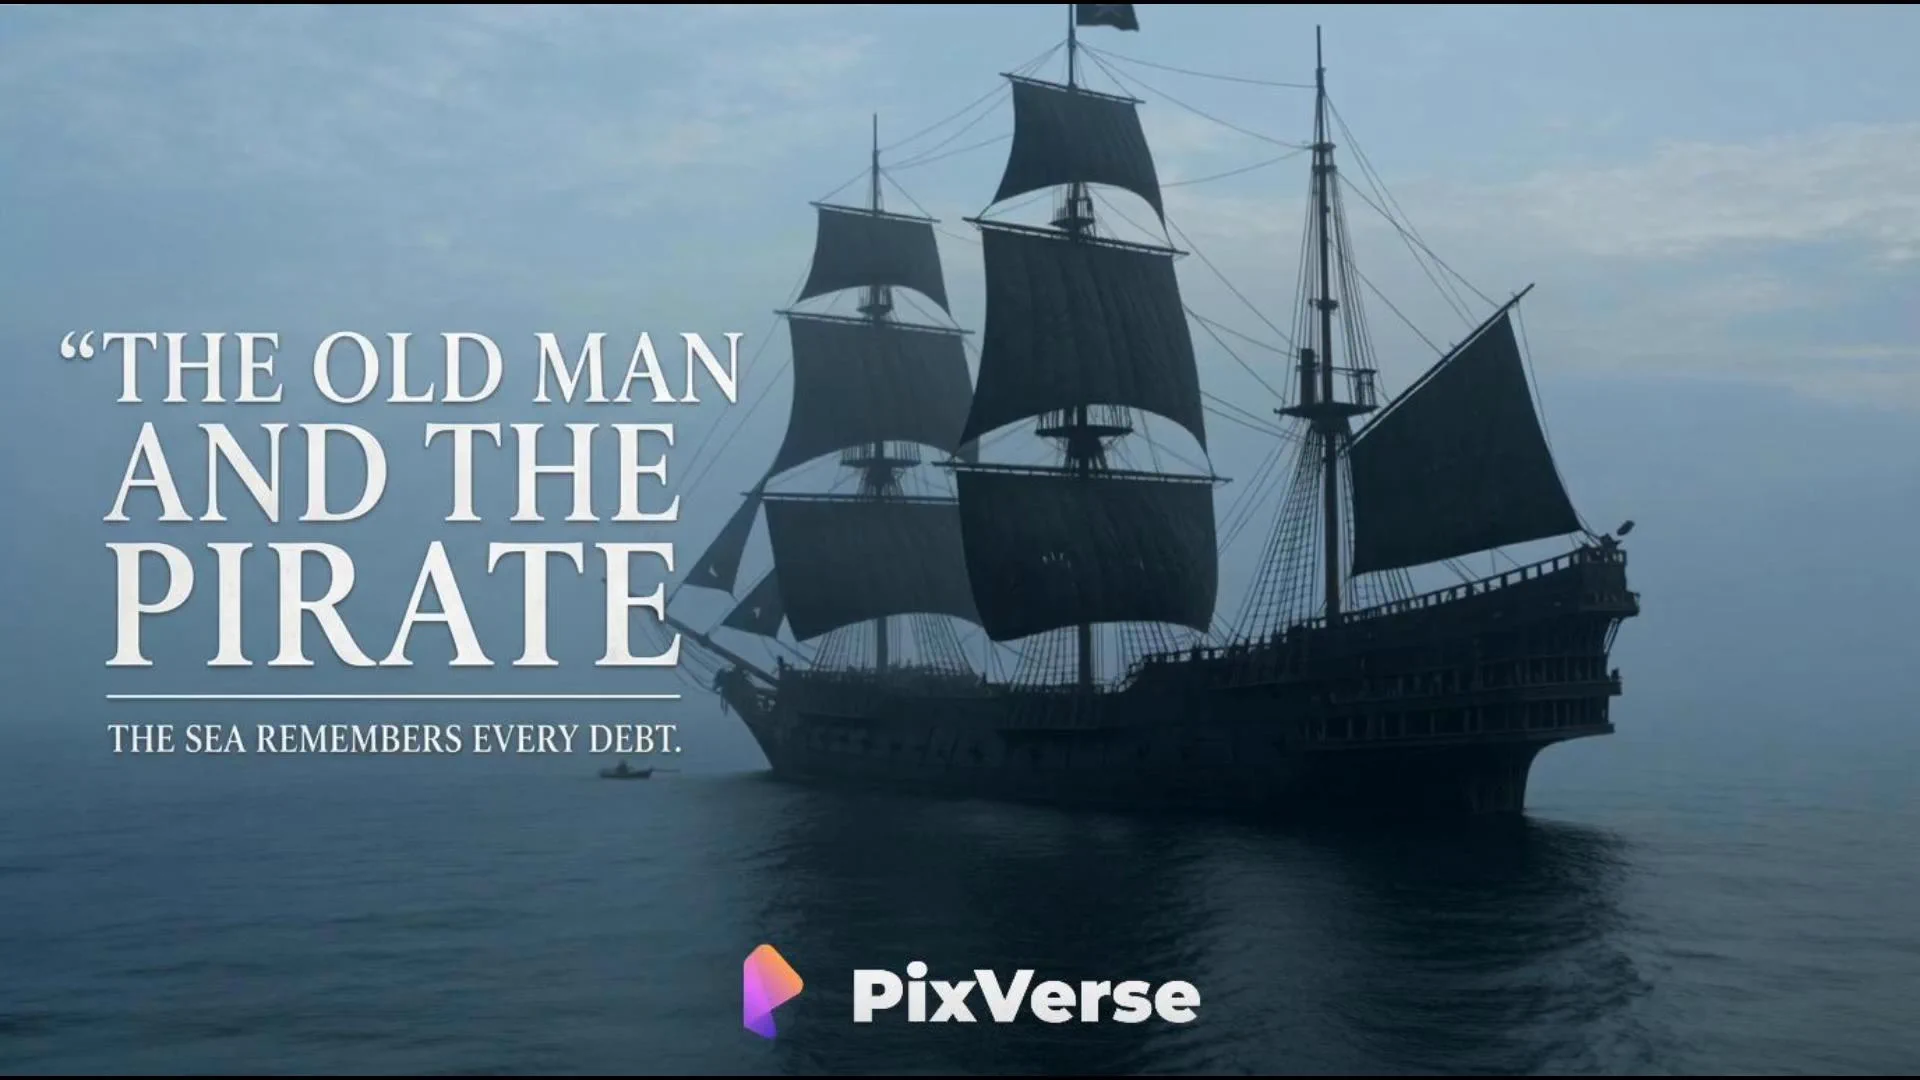
PixVerse 分享了一段 15 秒、16:9 的写实航海短片提示词,按 2.39:1 宽银幕构图、24fps 自然运动,共四个镜头。故事设定在中世纪北欧海域,一位 74 岁老人独自划 4 米木船驶入浓雾,逐渐发现一艘三桅黑帆海盗船,重点表现雾中逐层显现与船、人、小舟之间的巨大尺度反差。
PixVerse 上的 Kling 4.0 完美驾驭了这一场景的宏大尺度 一艘 140 米长的黑帆船缓缓从雾中浮现。小小的划艇让它显得更加庞大,整个片段感觉就像在开阔水域实拍的一样 完整提示词见下
文章指出 AI 大语言模型首次能自主创造和修改构建人类文明底层信任系统的语言,人类正从信任人类转向信任 AI,这将成为人类面临的最大挑战。
作者引用尤瓦尔赫拉利演讲观点,指出 AI 是首个自主编写人类文明底层信任系统语言的技术,人类将逐渐转为信任 AI。
Vals AI 用数百道涉华问题测试中外模型,发现中国模型的"亲政府倾向"总体低于预期,且各模型差异明显,GLM-5.3 Flash 甚至明确承认中国人权问题有据可查。提示词语言影响显著:简体中文提问比英文、俄文、西班牙文更亲政府,中美模型皆如此但中国模型更明显。多数中国模型很少拒答,而是直接采用官方立场,如 Kimi K3 否认新疆存在集中营。
OpenAI 对 ChatGPT 付费订阅新增支付卡片和设备数量限制,同一张卡或设备绑定过多订阅后将无法开新订阅,触顶时显示 Device limit reached。
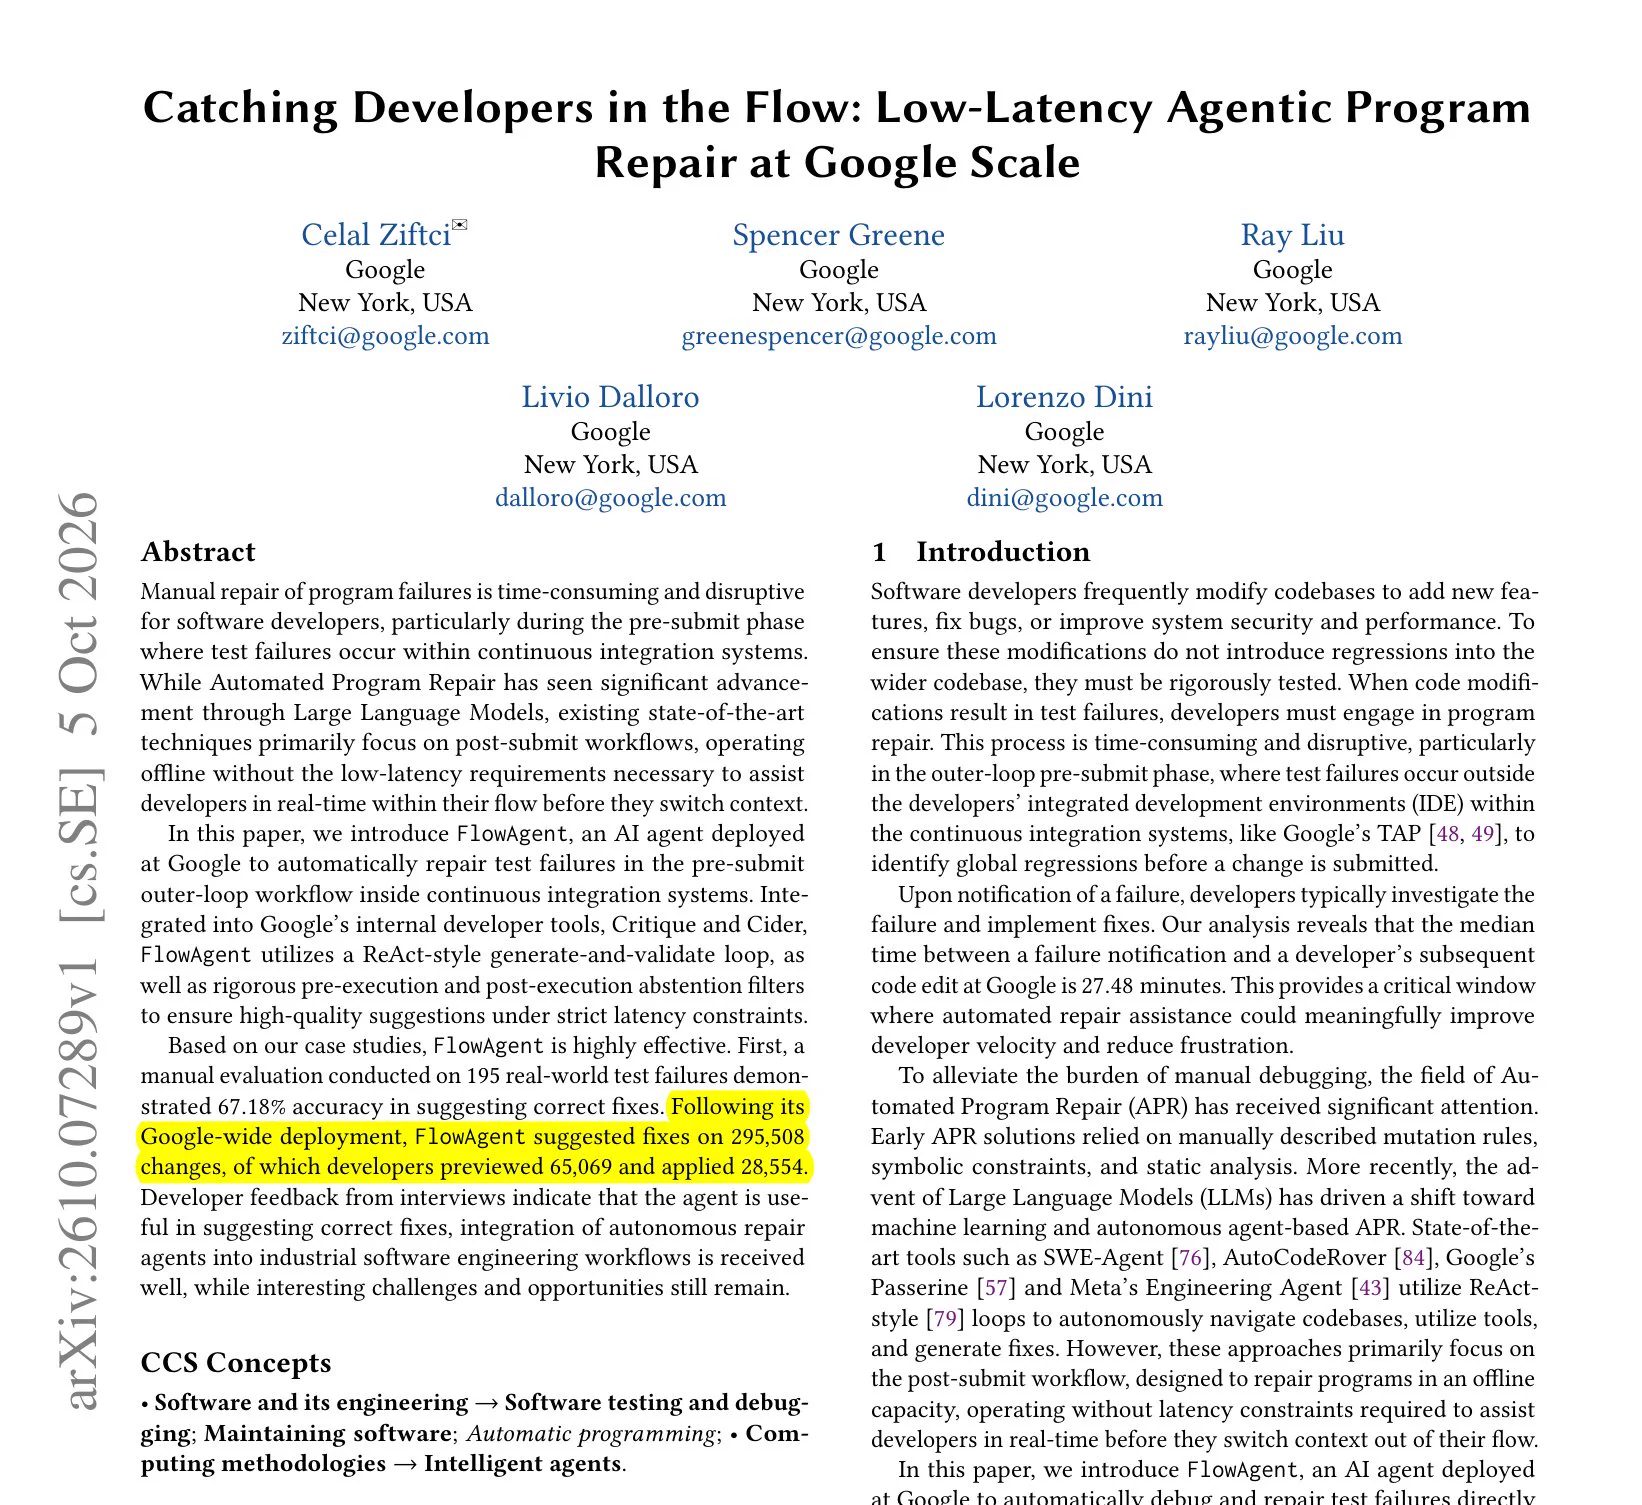
Google 论文介绍部署在内部 CI 中的 FlowAgent,它捕获测试失败后由 Agent 编辑、构建并重跑测试直至通过,验证过的修复会以根因说明形式进入代码评审。
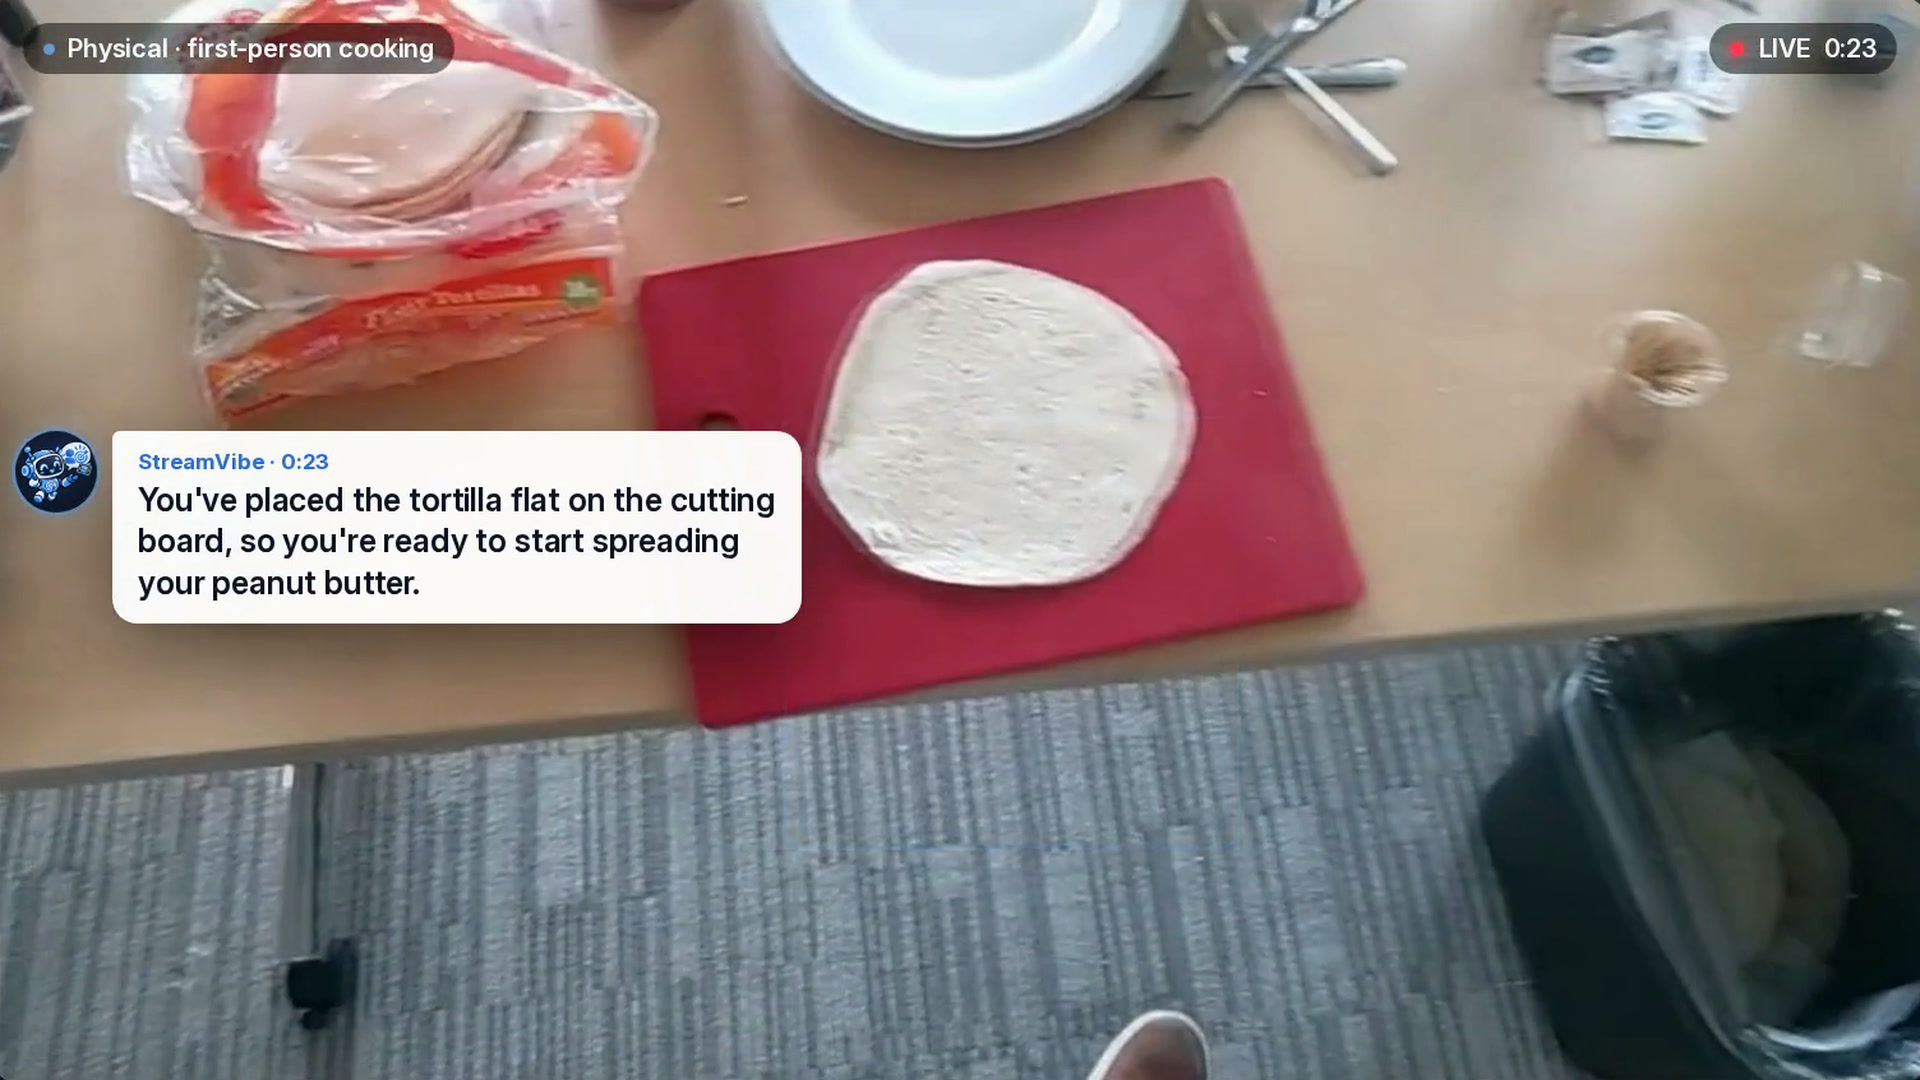
Google 联合斯坦福、牛津等团队推出 StreamVibe 视频智能体,能区分用户明说、未说出口和任务中途改变的需求,自主决定何时出声帮忙。其 StreamVibe-VL 模型基于 Qwen3.5-9B,响应时机与质量比其他模型提升 10.7%,记忆系统再提升主动交互 12.3%。
长鑫存储(CXMT)已向国内芯片设计公司送出 HBM3E 样品,计划两个月内有限量产,但良率仅 20–30%。宇树第三季度营收增长 69.9% 至 6.65 亿元,净利润下降 17.4%,研发支出增长约 250%。月之暗面发布 Kimi K3.1 Pro,支持 100 万 token 上下文窗口,完整权重承诺 11 月 4 日开放。
赛迪研究院昨日发布《新域新质创新发展十大趋势》显示,我国人工智能推理数据量首次超过训练数据量,标志从模型训练研发迈入规模化产业应用阶段。截至 2026 年 6 月日均词元调用量超 175 万亿,较 2024 年年初增长 1000 多倍;国产算力和大模型已在钢铁、汽车等 20 个行业落地 1000 多个应用场景,并累计建成 500 多家卓越级智能工厂。
SpatialScout 基准评估了 AI 智能体在未知虚拟房间中主动探索并构建三维空间地图的能力,揭示了当前模型在空间推断、观察决策和几何定位之间的瓶颈。
文章指出 DeepSeek 提出 Super-agent 理念,却发现硅谷的 AFK AI 团队在 4 月已实现 nearly 所有核心架构,展示了双层 Router+Worker 架构、BYOM 计算分离及事件驱动的超级 Agent 实践。
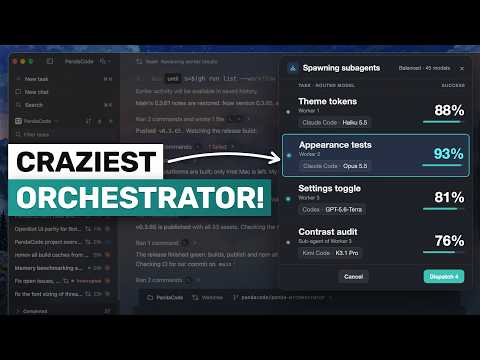
AICodeKing 介绍本地任务分析模型,以可测试规则、真实结果和逐级升级降低编码智能体团队的成本。
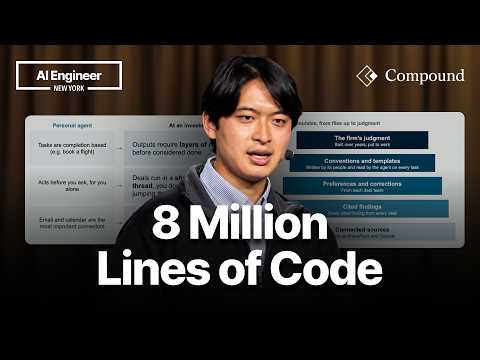
Yijia Liang 解释 Compound 如何以兼容 Office 的自研引擎、多人共享智能体和来源引用,提升长时金融分析任务的并行处理与复核能力。