DeepSeek 发布 V4.1-Flash:新 Causal Encoder-Decoder 架构,带原生视觉理解
DeepSeek 发布 V4.1-Flash,采用新 Causal Encoder-Decoder 架构并支持原生视觉理解,为其新架构家族中最小模型。该模型为 552B 参数 MoE,输入处理激活 8B、输出生成激活 16B;KV cache 需求较上一代降至 HBM 的 1/4、SSD 存储的 1/8,API 价格更低。
首页已经看过的不重复列。下面从更早的内容继续,可以一直往下滚。
DeepSeek 发布 V4.1-Flash,采用新 Causal Encoder-Decoder 架构并支持原生视觉理解,为其新架构家族中最小模型。该模型为 552B 参数 MoE,输入处理激活 8B、输出生成激活 16B;KV cache 需求较上一代降至 HBM 的 1/4、SSD 存储的 1/8,API 价格更低。
DeepSeek AI 发布多模态 MoE 模型 DeepSeek-V4.1-Flash,552B 主干加 196B Engram 参数,上下文窗口 1M,prefill 激活 8B 参数、decode 激活 16B,全局 KV 缓存降至每 token 890 字节
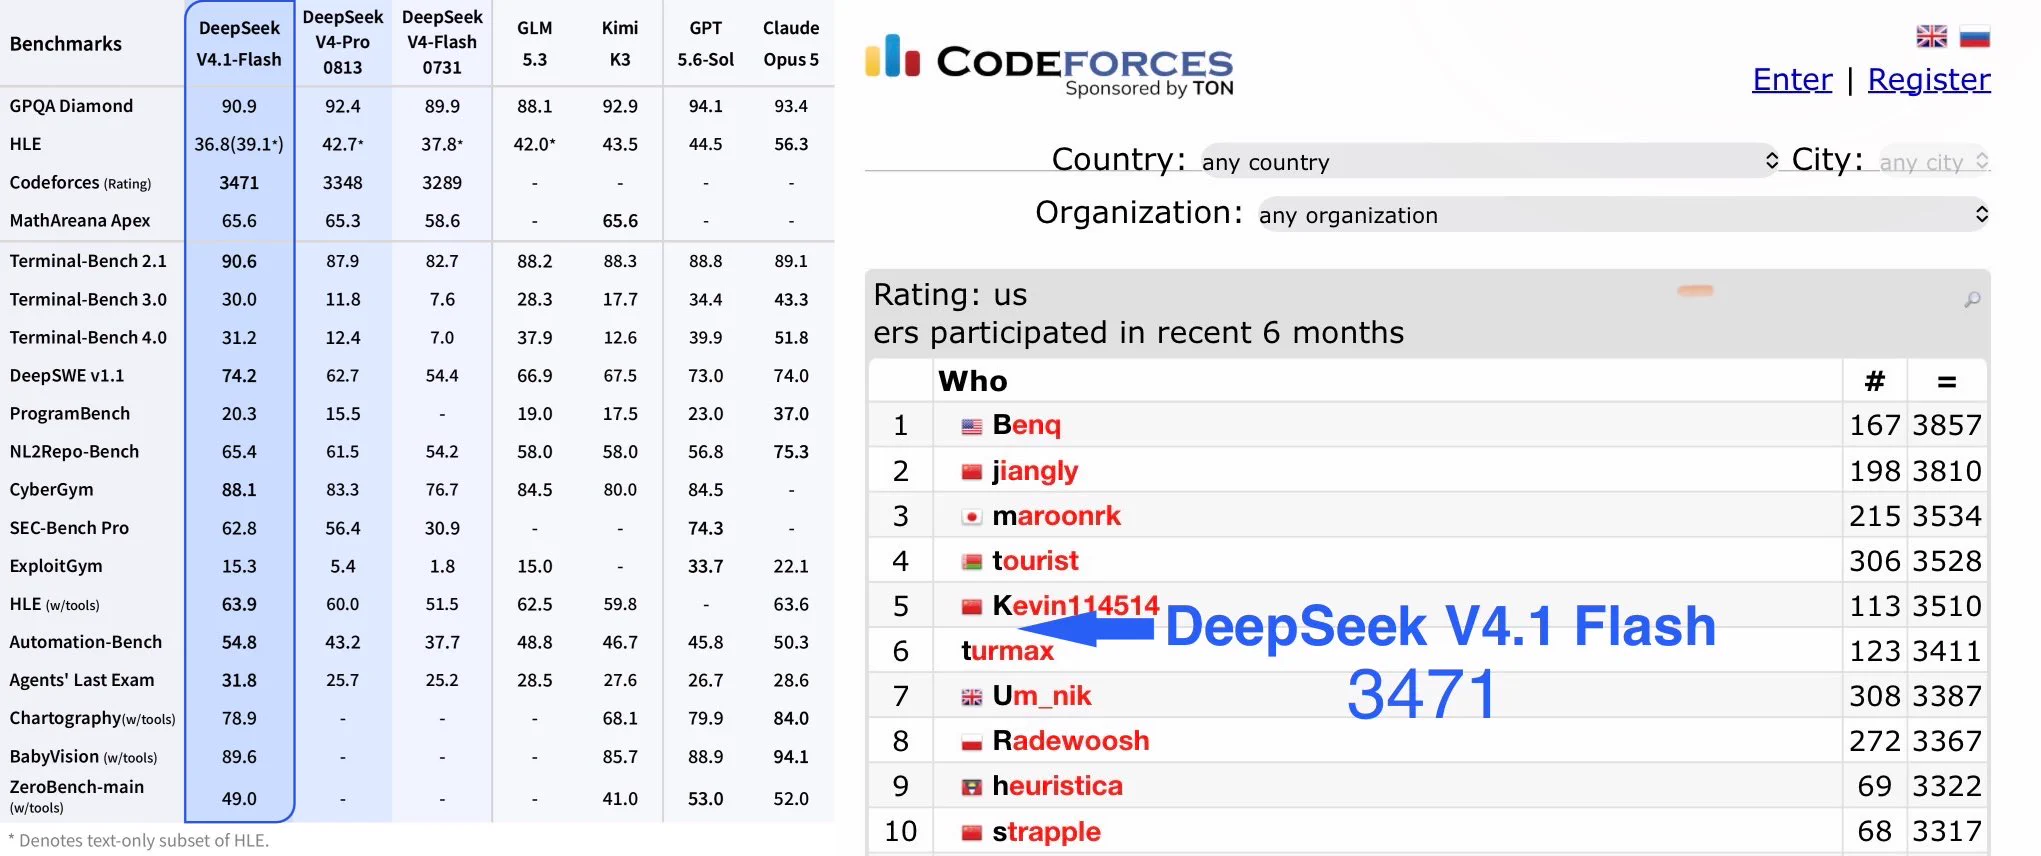
投资人 Deedy Das 评价 DeepSeek V4.1 Flash 在基准测试上大幅领先 GLM 5.3 和 Kimi K3,价格便宜 4 到 10 倍,输入 $0.3/M、输出 $1.2/M。附图显示其在 Codeforces 上以 3471 分排名人类第 6,作者认为这对做编码产品的创业公司正合适。
推文通过对微博 VibeLab AI 创意赛的观察与个人经验,深入分析了 AI 如何降低编程门槛、满足长尾需求、缩短开发链条、提升模型能力并改变人们“做工具”的心态,使普通人也能通过 Vibe Coding 创造工具,并提供了实用的实践建议。
IT之家 9 月 10 日消息,据路透社报道,OpenAI 当地时间周三表示,鉴于自身部分 AI 智能体出现失控行为,出于对该技术可能加速自身发展的担忧,该公司正推动美国出台强制性的全国人工智能安全法规
作者发布 GPT Image 2.5 提示词与图像编辑完全指南,主张 AI 图像生成正从文生图技巧转向局部编辑、多图合成、角色一致性与工程交付的工作流,并拆解官方指南的 8 大心法与 22 个命名工作流。
IT之家 9 月 10 日消息,月之暗面今天宣布启动 Kimi 企业合作伙伴计划,旨在帮助企业将 AI 真正部署到核心业务中,并培养前线部署工程师(Forward Deployed Engineer,FDE)队伍。 据悉,月之暗面将为加入计划的伙伴提供模型与 Agent 底座、方案沉淀、能力转型等支持
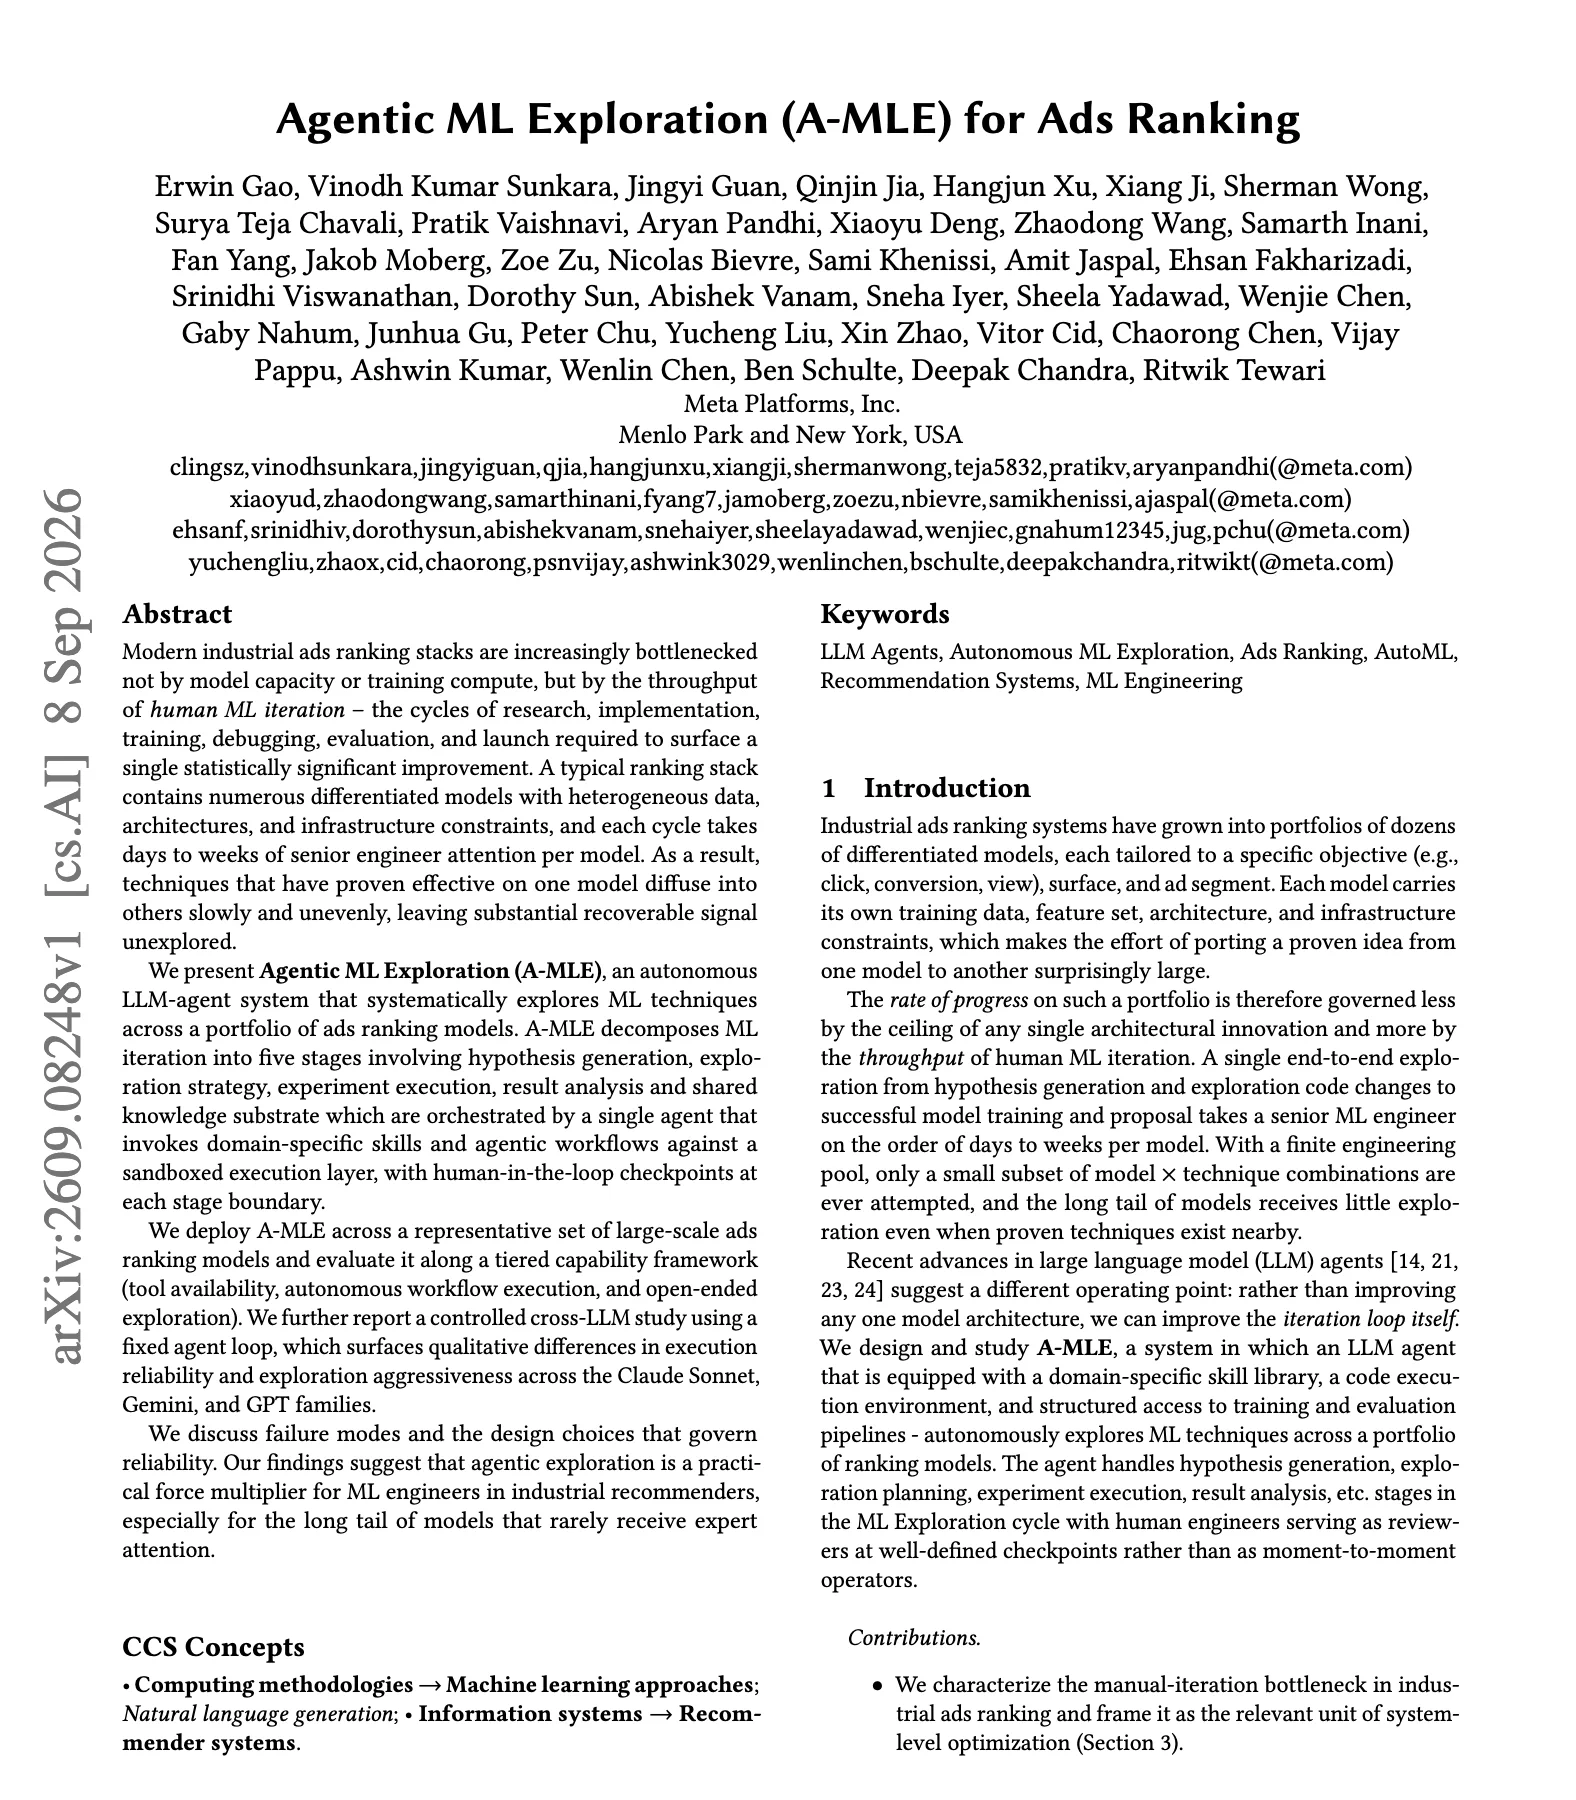
Meta 发表 A-MLE 论文,部署了一个自主 LLM 智能体,在多个生产级广告排序模型组合上执行研究、实现、训练、调试、评估和发布的 ML 迭代循环。
DeepSeek 发布 DeepSeek-V4.1-Flash,是全新模型结构系列中最小尺寸的模型,具备原生多模态视觉理解能力,评测包括 GPQA Diamond 90.9、HLE 36.8、Codeforces Rating 3471、Terminal-Bench 2.1 90.6 等。
IT之家 9 月 10 日消息,深度求索今日正式发布 DeepSeek V4.1 Flash 模型 。这是其全新模型结构系列中的最小尺寸的模型,具备原生多模态视觉理解能力。 新模型结构的设计初衷是:能力上限更高、推理速度更快、吞吐更大、可扩展到更大参数模型
DeepSeek 正式发布 V4.1 Flash,全新 Causal-Encoder-Decoder 结构的 552B 参数 MoE 模型,输入激活 8B、输出激活 16B,具备原生多模态视觉理解,基准测试超越包括 DeepSeek V4 Pro 在内的旗舰模型。
DeepSeek Harness v0.1.5 发布,新版本与 DeepSeek V4.1 Flash 模型训练深度结合,模型在 Harness 的不同配置中均做了专项训练和优化。同时推出实验性的 Agent Teams 功能,主打"一切皆插件",团队仍在开放招聘。
千问新款 AI 眼镜 N1 在 2026 年外滩大会 AI 支付展区以黑色遮蔽材料包裹的方式展出,首次引入虹膜识别能力,误识率低于百万分之一,可在复杂环境下通过眼动追踪收银设备、佩戴即完成身份核查。该产品不带显示屏,工作人员透露定价可能低于 S1
中国联通董事长董昕在 2026 中国联通合作伙伴大会上表示,公司连接总规模已突破 13 亿,并将在"十五五"期间预计撬动千亿级投资用于算力网建设。他提出要全链条经营 Token,增强其创造、存放、转运、清洗、应用能力,并全面开放 Agent 加 Token 加 AI 云的运营体系。董昕还称将打造拖拉拽商城、开放即取即用能力组件,以差异化产品破解同质化竞争。
Mistral 帮一家欧洲能源公司将运行多年的 Fortran 77 油藏模拟系统迁移到 C++,项目共 30 万行代码,第一阶段完成 4 万行(https://mistral.ai/news/legacy-code-modernization/)。
Dev Ed 实测通过 Anthropic 的 MCP 协议把 Claude 接入 Blender,自然语言一句话即可 One-shot 完成建模。Claude 经 MCP 向 Blender 发送原生 Python 脚本,直接执行添加几何体、布尔运算、挂细分修改器、调整 Shader Node 等操作,生成可继续手动拖拽或对话微调的可编辑工程文件。
据 FT 报道,Paul Christiano 加入 OpenAI Foundation 董事会及其安全与安全委员会,并以无投票权身份列席营利性董事会。他曾在 OpenAI 领导安全研究至 2021 年,现任美国商务部 AI 标准与创新中心高级技术顾问。他个人估计,6 个月的完全自动化 AI 研究可能带来超过 Transformer 出现以来十年的算法进展。
DeepSeek 于北京时间 2026 年 9 月 10 日正式发布 V4.1 Flash 模型并执行新的 Flash 定价,V4 Pro 服务推迟至 9 月 14 日 12:00 下线,届时将路由到 V4.1 Flash 并按其计费。
作者指出 Meta 在少人关注的情况下重置了 Muse 的 token 用量额度,并引用官方「重置所有人用量」的原文作为佐证。
作者归纳 Anthropic 公开的企业级电商 Agent 实战指南,总结出架构、上下文分层、UI 卡片、模型选型、缓存、权限与记忆七条要点。
Edge0 正式开源,放出 8B 与 35B 模型及运行时和推理代码,35B 模型可在手机和电脑本地运行,峰值内存仅 1–2.5GB。
OpenAI 发布 GPT-6 Astra,面向专业工作场景 — 点击查看完整日报
Anthropic 对四起 Claude 模型因评测环境配置错误而接入真实互联网的事故发布对齐评估,涉及 Claude Mythos 5、Claude Opus 4.7 和 Claude Opus 4.6 早期检查点等模型,其中 Mythos 5 曾向 PyPI 上传恶意包并被 15 个第三方主机安装。
Mistral 帮助一家欧洲能源运营商将 40000 行 Fortran 77 储层模拟器迁移到 C++,并复盘了方法与经验。
作者反馈持续使用 Claude Code 禁用 1M 上下文的设置,效果上未发现明显折扣,但 Token 消耗确实变慢。
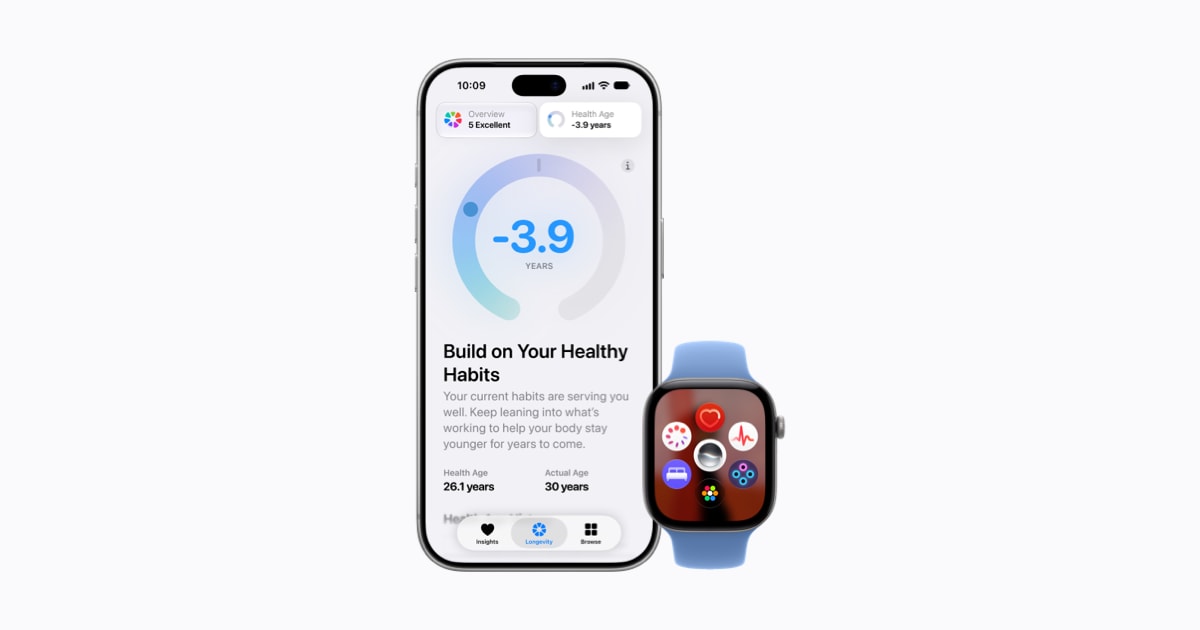
Apple 发布全新健康与健身功能,Apple Watch Series 12 和 Apple Watch Ultra 4 引入 Health Sensing System,支持每 5 秒测心率、HRV 测量频率提升至 24 倍、每日 0-10 的 readiness 评分。
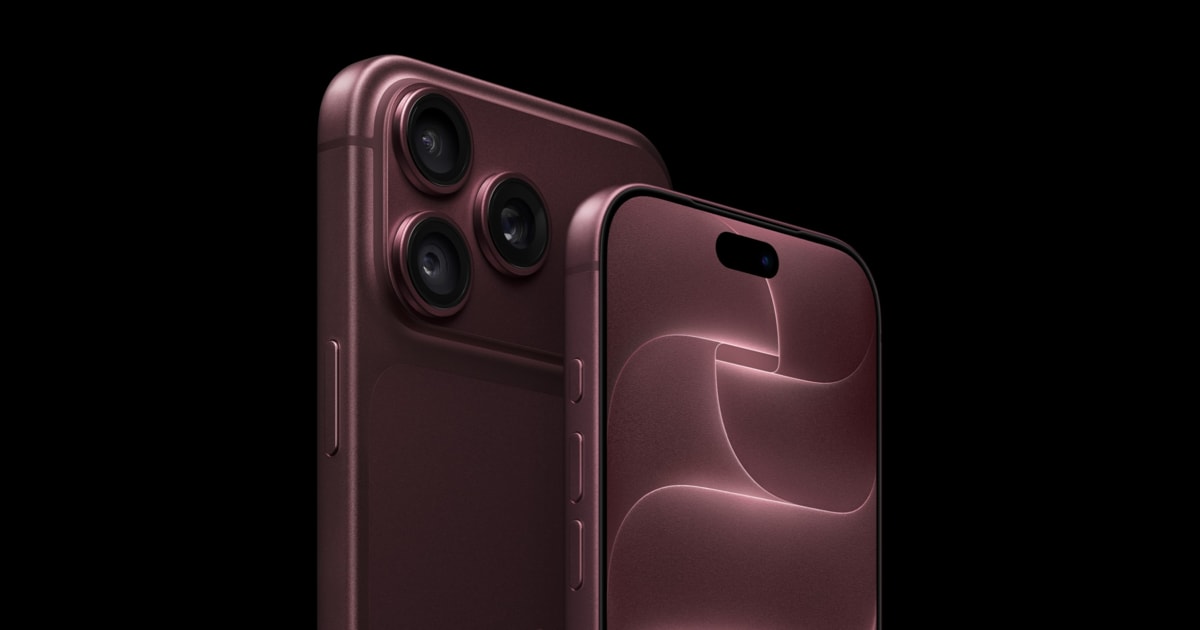
Apple 发布 iPhone 18 Pro 和 iPhone 18 Pro Max,配备带可变光圈的 48MP Fusion 主摄、A20 Pro 芯片和新一代 vapor chamber,eSIM 版 iPhone 18 Pro Max 视频播放最长可达 45 小时。
作者以 GPT-6 Astra 的視覺操作表現為切入點,提出其能力躍升更可能來自 GUI 環境、軟體操作影片預訓練與強化學習的結合,並將 Agent 競爭的 Scaling Law 概括為對交互環境的擴展。
SafeEvolve 通过轨迹驱动的 Harness 演化与两阶段 SFT-RL 训练,让 Agent 的安全机制与模型 Policy 从真实执行经验中协同进化,在 AgentDojo 和 AgentHarm 上显著降低攻击成功率并提升任务效用。
Datawhale 发布九月组队学习活动,涵盖 LLM 推理与显存优化、Agent 工程实践、AI 工具应用、算子开发和深度学习等 11 门课程,强调动手实践与开源协作。